Vision AI
- Envoi d'une photo par le formulaire de l'application
- L'image est déposée dans le bucket, sous son nom définitif
- images:annotate demande labels et SafeSearch en une requête synchrone (20 Mo au plus)
- files:asyncBatchAnnotate traite les PDF et TIFF du bucket : opération longue, résultat JSON écrit à côté
- Les annotations et le verdict de modération sont enregistrés avec la fiche de l'image
Ce que c'est
Vision AI désigne l'offre d'analyse d'images ; l'API appelée depuis le code est la Cloud Vision API. Une requête porte une image et une liste de fonctions à appliquer ; la réponse est un JSON d'annotations.
- Fonctions :
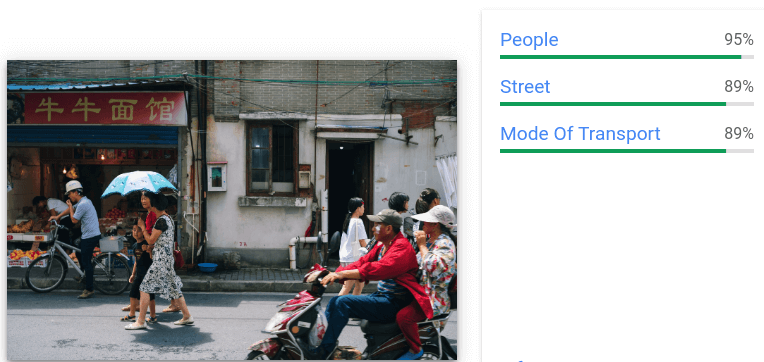
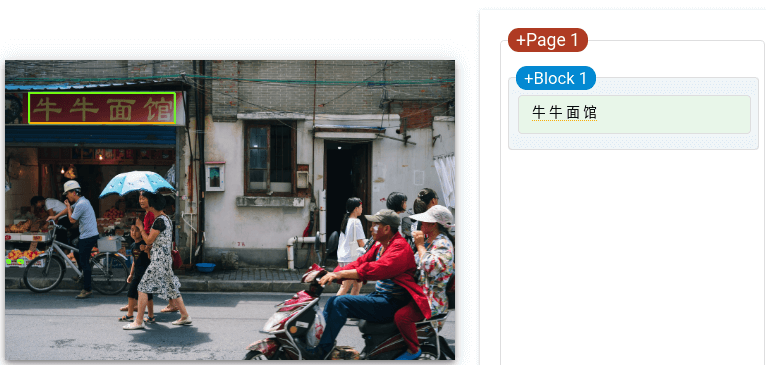
LABEL_DETECTION(libellés généraux),TEXT_DETECTIONetDOCUMENT_TEXT_DETECTION(OCR, texte épars ou dense et manuscrit),OBJECT_LOCALIZATION(objets et boîtes englobantes),FACE_DETECTION(visages, points caractéristiques, indices d'émotion — pas d'identification de personne),LOGO_DETECTION,LANDMARK_DETECTION,SAFE_SEARCH_DETECTION(contenu sensible, en cinq catégories et six niveaux de vraisemblance),IMAGE_PROPERTIES,CROP_HINTS,WEB_DETECTION. - Product Search : un index d'images de catalogue, interrogé par photo, pour retrouver un article de référence.
- Trois points d'entrée.
images:annotateen synchrone, jusqu'à 20 Mo par image et 10 Mo pour la requête JSON entière.files:annotatepour un PDF ou un TIFF court.images:asyncBatchAnnotateetfiles:asyncBatchAnnotatepour les lots : opération longue, les fichiers sont lus dans Cloud Storage et le JSON d'annotations y est écrit. - Entrées : JPEG, PNG, GIF, BMP, WEBP, RAW, ICO, PDF, TIFF. 640×480 suffit pour la plupart des fonctions, 1024×768 pour l'OCR, 1600×1200 pour les visages ; au-delà de 75 millions de pixels, l'image est redimensionnée pour l'OCR.
- Modèles versionnés :
builtin/stable,builtin/latestetbuiltin/legacydans le champmodeld'une fonction, pour essayer un nouveau modèle avant qu'il ne devienne le défaut. - Facturation par unité = une fonction appliquée à une image ou à une page. Les 1 000 premières unités du mois sont gratuites, puis 1,50 $ les 1 000 unités jusqu'à 5 millions. SafeSearch est gratuit quand il accompagne la détection de labels.
Pour un PDF, chaque page compte comme une image facturée, et chaque fonction demandée comme une unité distincte : une requête à trois fonctions sur un document de 40 pages coûte 120 unités.
À quoi ça sert
- Modérer des images envoyées par les utilisateurs, avec SafeSearch.
- Étiqueter et rendre cherchable un fonds photographique.
- Lire du texte dans des photos : panneaux, étiquettes, plaques, captures d'écran.
- Reconnaître des articles de catalogue à partir d'une photo, avec Product Search.
À éviter pour un document structuré — facture, formulaire, contrat : Document AI lit la mise en page, les tableaux et les champs, là où l'OCR de Vision ne renvoie qu'une hiérarchie page / bloc / paragraphe / mot. À éviter aussi quand la question posée sur l'image est ouverte (« que fait cette personne ? », « ce plan est-il conforme ? ») ou que l'on veut une sortie au format de son choix : c'est le terrain d'un modèle Gemini multimodal. L'API dédiée reste préférable pour des sorties structurées et stables — coordonnées de boîtes, scores de confiance, catégories fixes —, pour un tarif à l'unité qui ne dépend pas de la taille de l'image, pour la latence, et pour des volumes de plusieurs millions d'images.
Dans la console
Alternatives en logiciel libre
- Tesseract (Apache 2.0) et PaddleOCR (Apache 2.0) : OCR classique, plus de 100 langues ; PaddleOCR gère mieux les scènes naturelles et les langues asiatiques.
- docTR (Apache 2.0) : OCR par réseaux de neurones, détection puis reconnaissance, en PyTorch ou TensorFlow.
- OpenCV (Apache 2.0) : traitement d'images classique — détection, segmentation, correspondance de points ; la base sur laquelle se construit le reste.
- Ultralytics YOLO (AGPL 3.0) et MMDetection (Apache 2.0) : détection d'objets et boîtes englobantes, préentraînées sur COCO ou affinées.
- OpenCLIP (MIT) : étiquetage et recherche d'images par similarité vectorielle, l'équivalent libre de Product Search.
- NudeNet (AGPL 3.0) : classification et floutage de contenu explicite, à la place de SafeSearch.