Speech-to-Text
- Dépôt des enregistrements dans un bucket (WAV, FLAC, MP3, OGG)
- Eventarc reçoit l'événement de création d'objet
- Le service Cloud Run est déclenché pour chaque fichier déposé
- batchRecognize ouvre une opération longue sur l'URI gs:// du fichier
- Speech-to-Text lit l'audio directement dans le bucket, sans limite de taille
- Le service relève l'opération terminée et charge les transcriptions dans une table
Ce que c'est
API de reconnaissance vocale : on envoie de l'audio, le service renvoie du texte horodaté. Modèles préentraînés, aucun entraînement nécessaire, appel en REST ou par bibliothèque cliente.
- Trois modes d'appel. Synchrone (
recognize) pour un extrait d'une minute au plus, la réponse arrive dans le même appel. Par lots (batchRecognize) pour un fichier de Cloud Storage jusqu'à 480 minutes (une heure avec le modèlechirp_3) : l'appel ouvre une opération longue que l'on interroge jusqu'à sa fin, le résultat étant renvoyé en ligne ou écrit dans un bucket. En flux (streamingRecognize) pour du direct, en gRPC bidirectionnel, jusqu'à 5 minutes par flux. - Modèles :
chirp_3(modèle génératif multilingue, diarisation et détection automatique de la langue),chirp_2, ettelephonypour de l'audio téléphonique à 8 kHz. - Ressources de l'API v2 : un recognizer fige une configuration réutilisable (langue, modèle, options) ;
_désigne le recognizer implicite. Les appels sont régionalisés (global,eu,us, régions dédiées). - Options : ponctuation automatique, horodatage par mot, plusieurs alternatives, filtrage des grossièretés, séparation des locuteurs, adaptation par
PhraseSet(jusqu'à 5 000 expressions par requête, 1 000 avecchirp_3) pour les noms propres et le vocabulaire métier. - Entrées : 10 Mo maximum quand l'audio est passé en ligne dans la requête ; aucune limite de taille quand il est référencé par une URI
gs://. Chaque canal est facturé séparément. - Facturation à la seconde d'audio traité, par paliers mensuels (0,016 $ la minute sur le premier palier de l'API v2). Le dynamic batch, qui traite l'audio avec un niveau d'urgence moindre, est facturé 0,003 $ la minute.
Une transcription qui dérape sur des noms de produits ou des références clients se corrige avec l'adaptation (
PhraseSet) avant d'envisager un modèle personnalisé : c'est gratuit et l'effet est immédiat.
À quoi ça sert
- Transcrire un fonds d'enregistrements : réunions, appels du centre de contacts, podcasts, archives audio.
- Sous-titrer des vidéos, en enchaînant avec Translation AI pour les versions étrangères.
- Dicter et piloter à la voix dans une application, par le mode flux.
- Alimenter un index de recherche ou une table BigQuery à partir de contenus parlés.
À éviter quand on cherche à comprendre l'audio plutôt qu'à le retranscrire — résumer une réunion, répondre à une question sur un appel, en extraire des champs : un modèle Gemini multimodal prend l'audio en entrée et fait les deux en un appel. L'API dédiée reste préférable quand il faut une transcription verbatim avec horodatage au mot, de la diarisation, du flux temps réel à faible latence, de l'audio téléphonique 8 kHz, un coût proportionnel à la durée plutôt qu'au nombre de jetons, ou un volume massif traité en lots. Le montage courant consiste d'ailleurs à transcrire ici, puis à envoyer le texte au modèle de langue.
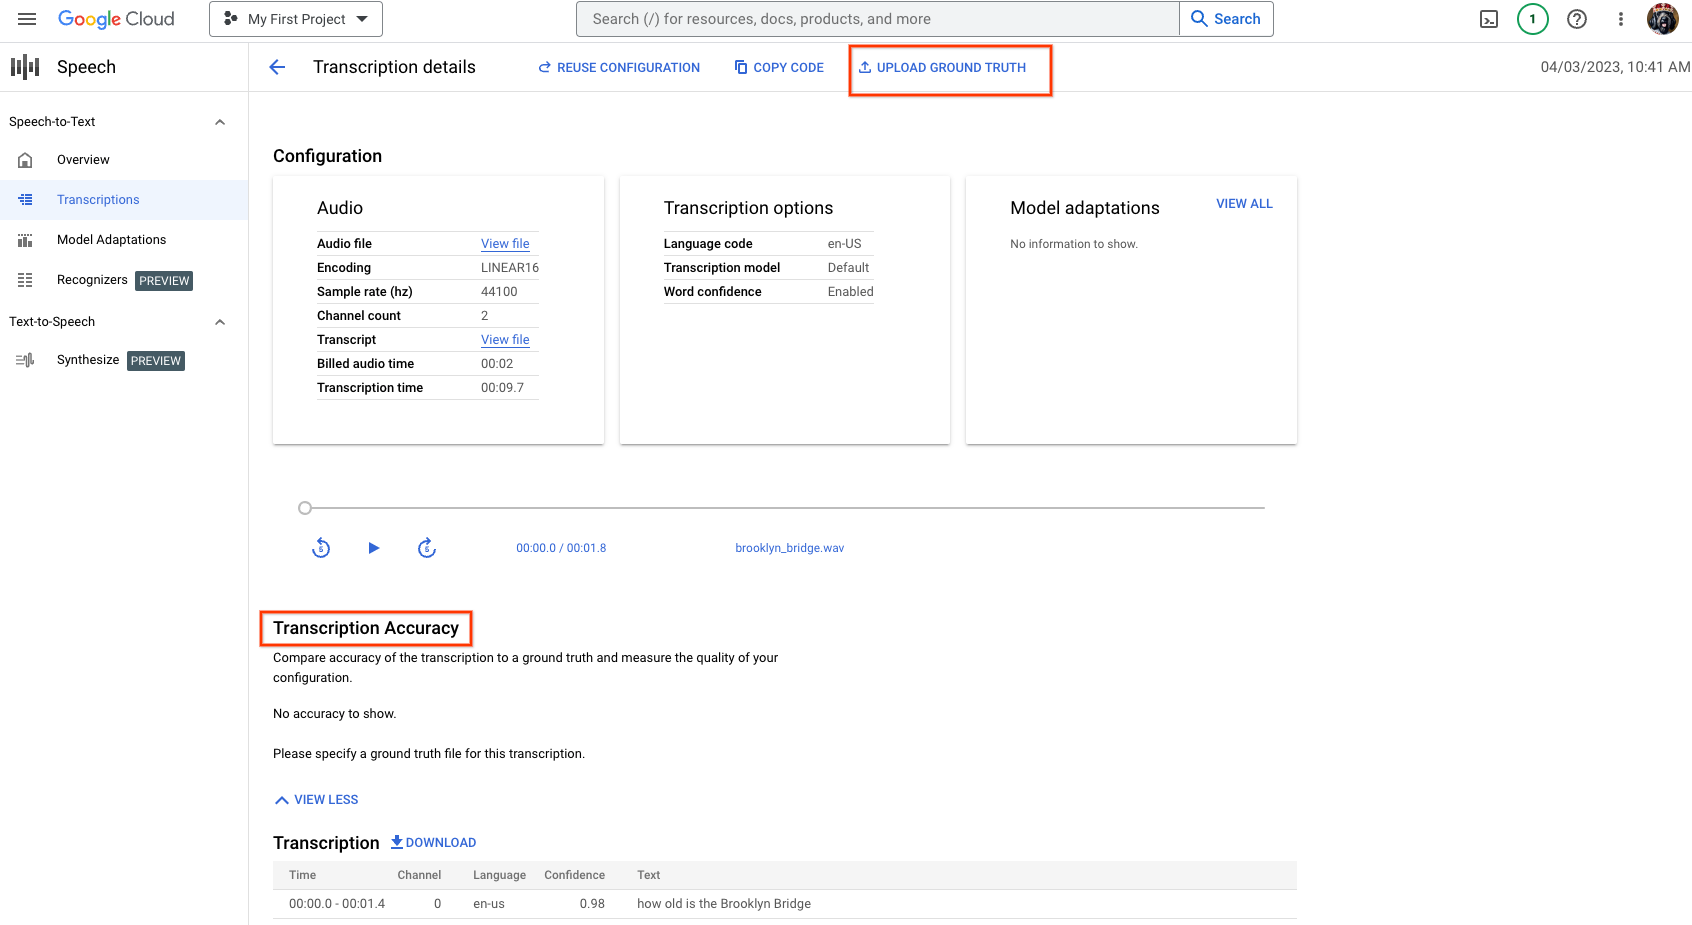
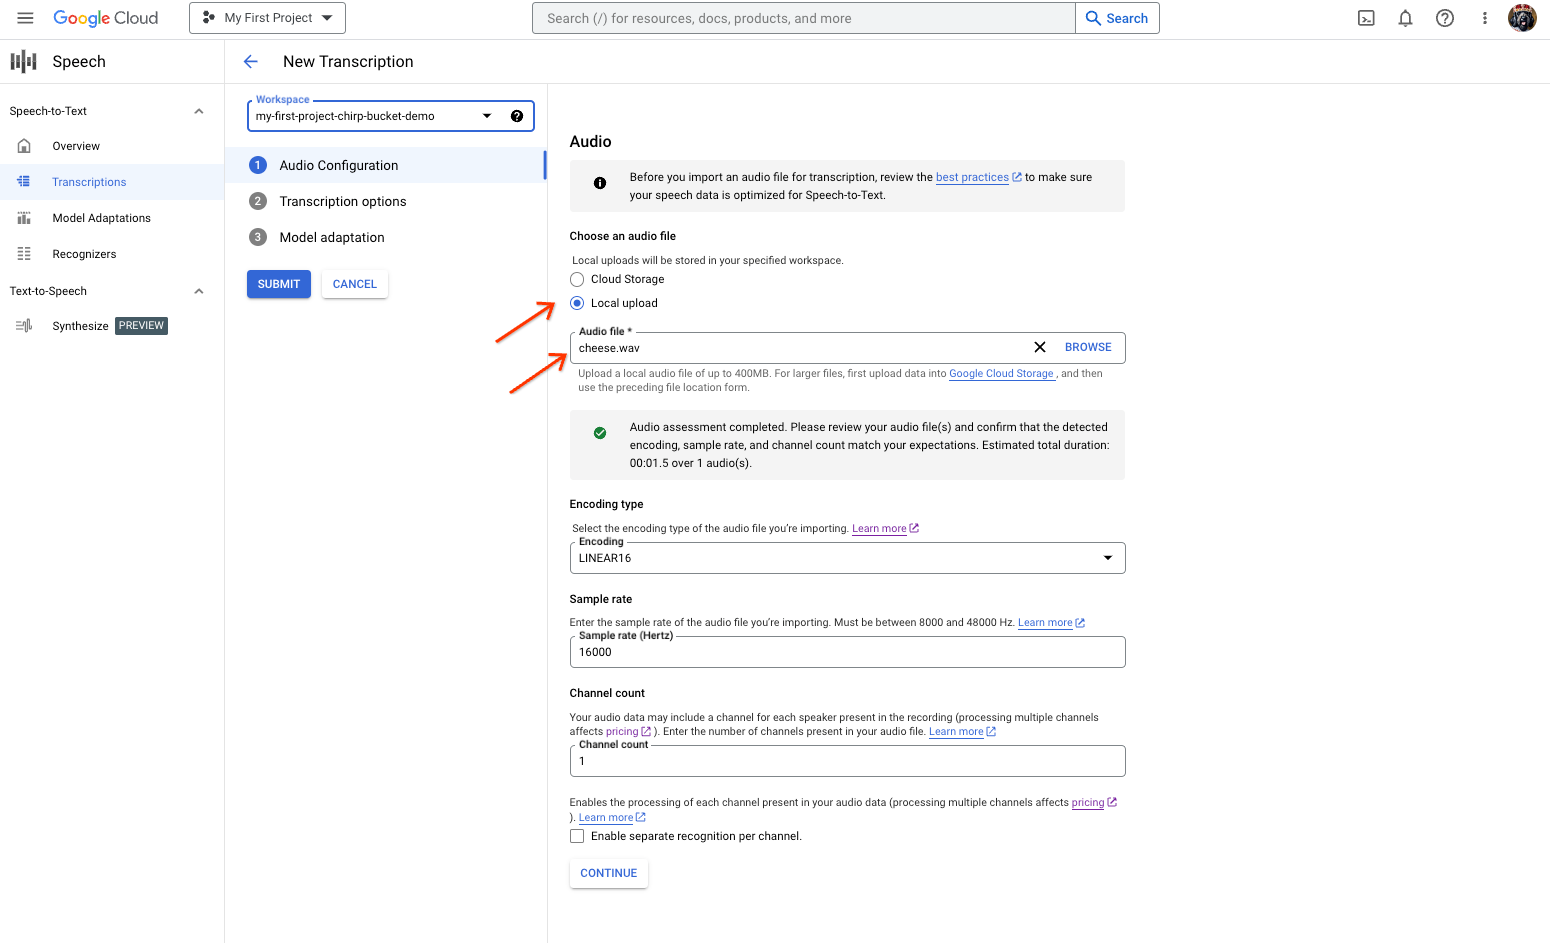
Dans la console
Alternatives en logiciel libre
- Whisper (OpenAI, licence MIT) : le modèle de transcription multilingue de référence ; faster-whisper et whisper.cpp en réimplémentations rapides, WhisperX pour l'alignement au mot et la diarisation.
- NVIDIA NeMo ASR : modèles Parakeet et Canary, entraînement et affinage inclus.
- Vosk et Kaldi : reconnaissance hors ligne, légère, adaptée à l'embarqué et au temps réel.
- wav2vec 2.0 (Meta, via Transformers) : modèle autosupervisé à affiner sur un domaine.
- pyannote.audio : séparation et identification des locuteurs, à combiner avec un modèle de transcription.