Sensitive Data Protection
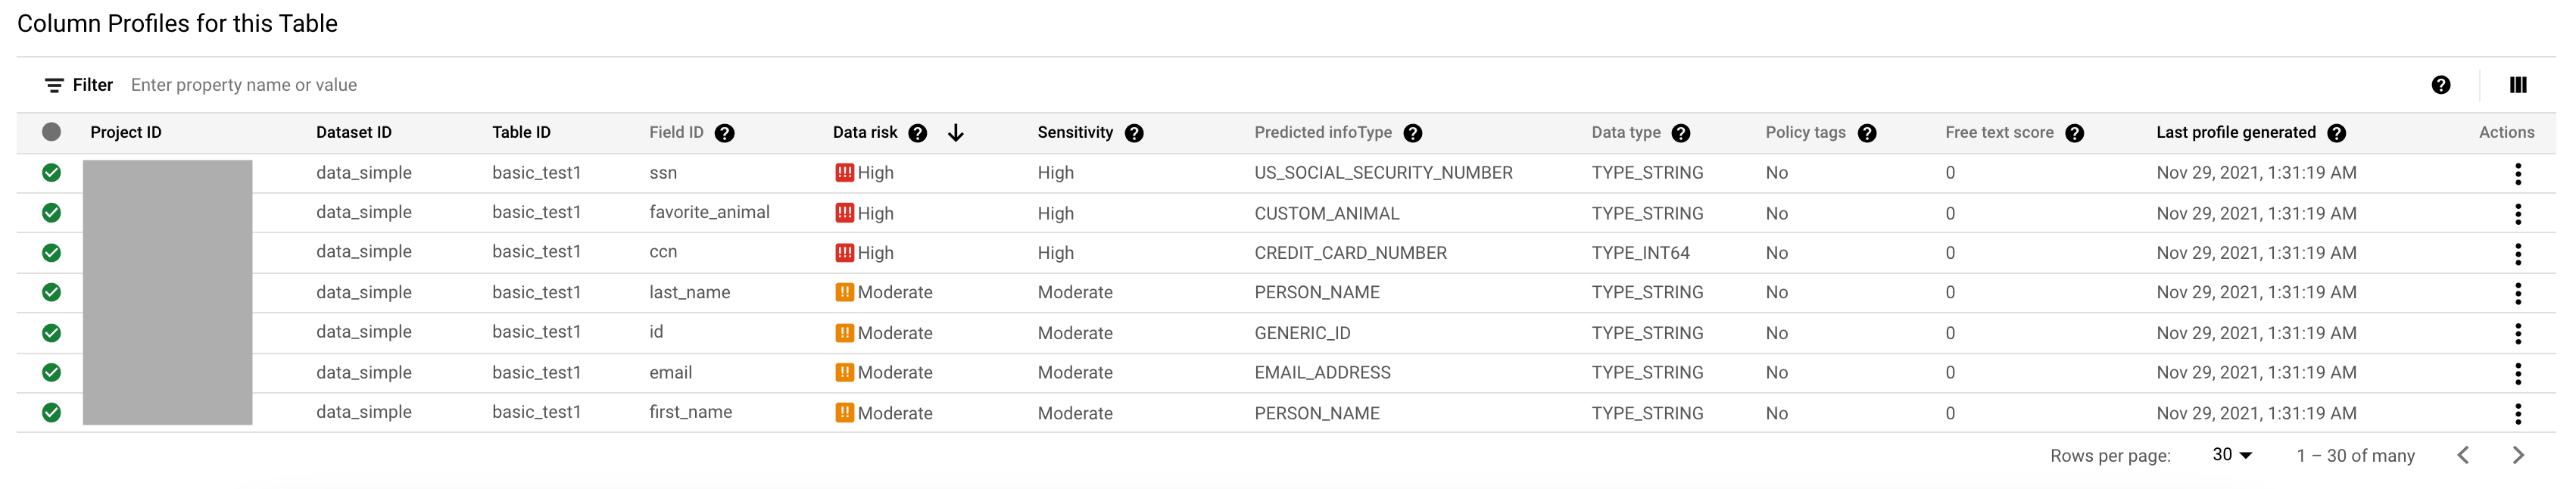
- La découverte profile en continu les tables de l'organisation : chaque colonne reçoit un infoType probable, un niveau de sensibilité et un niveau de risque, sans copie des données.
- Un job d'inspection parcourt un bucket et signale chaque occurrence trouvée, avec son emplacement exact et une probabilité.
- Les instances Cloud SQL sont profilées de la même façon, et les métriques remontent au niveau du dossier et de l'organisation.
- Une application appelle content.deidentify en synchrone pour masquer, remplacer par un jeton réversible ou décaler les dates avant d'enregistrer la charge utile.
- Les résultats à risque élevé remontent dans Security Command Center et peuvent déclencher une notification Pub/Sub vers une chaîne de remédiation.
Ce que c'est
Un service de classification et de transformation de données sensibles, appelé aussi bien sur des dépôts au repos que sur un flux applicatif. Il repose sur une bibliothèque de plus de cent cinquante infoTypes — numéro de sécurité sociale français, IBAN, carte bancaire, nom, adresse e-mail, identifiant médical — complétée par des détecteurs personnalisés (dictionnaire, expression régulière, mot-clé de proximité). L'API sous-jacente s'appelle toujours Cloud Data Loss Prevention.
- Découverte. Un service continu qui profile les ressources d'un projet, d'un dossier ou d'une organisation et produit des métriques par table et par colonne : infoType prédominant, sensibilité, risque de données, date du dernier profil. Une configuration de scan désigne le périmètre, les infoTypes, la fréquence et les actions de fin. Les profils ne copient pas les données et couvrent BigQuery, Cloud SQL, Cloud Storage et d'autres dépôts.
- Inspection. Un examen approfondi d'une ressource donnée, qui rend la position exacte de chaque occurrence et un niveau de probabilité. Trois formes : le job d'inspection sur un dépôt Google Cloud, le job hybride qui accepte des données envoyées depuis n'importe quelle source (base sur site, autre cloud), et l'appel synchrone
content.inspectqui renvoie directement le résultat sans rien conserver. - Dé-identification. Une palette de transformations : masquage par caractère, occultation, remplacement par l'infoType, regroupement en intervalles, décalage de dates cohérent par entité, hachage cryptographique, et tokenisation — déterministe ou préservant le format, réversible avec une clé Cloud KMS. Elle s'applique à un flux (
content.deidentify) ou à une copie de données Cloud Storage produite par un job. - Analyse du risque de ré-identification. Sur des tables BigQuery, le calcul des métriques classiques — k-anonymat, l-diversité, k-map, δ-présence — pour savoir si un jeu prétendument anonyme peut être recroisé. Utile avant la dé-identification pour choisir la stratégie, et après pour la vérifier.
- Restitution. Les résultats s'enregistrent dans une table BigQuery, se publient dans Pub/Sub, et remontent dans Security Command Center où ils pondèrent les chemins d'attaque.
- Facturation au volume inspecté et transformé, avec un tarif distinct pour la découverte ; les appels
content.*se facturent à la quantité de données envoyées.
La découverte est le bon point d'entrée : elle dit où se trouvent les données sensibles à l'échelle de l'organisation, pour un coût bien inférieur à une inspection exhaustive. L'inspection ne sert qu'ensuite, sur les ressources que le profil a signalées.
À quoi ça sert
- Cartographier les données personnelles d'un patrimoine hérité : savoir quelles tables et quels buckets en contiennent, sans lancer d'inspection généralisée.
- Nettoyer un flux avant stockage — formulaires, journaux applicatifs, transcriptions, invites envoyées à un modèle — en supprimant les identifiants au passage.
- Préparer un jeu de données pour l'analyse ou l'entraînement : pseudonymiser les identifiants directs, décaler les dates, regrouper les âges, puis vérifier le k-anonymat obtenu.
- Tokeniser un numéro de carte ou de client de façon réversible, pour que les traitements en aval travaillent sur un jeton et que seul un service habilité puisse revenir à la valeur.
- Prouver la conformité à un auditeur : le profil continu montre ce qui est présent, où, et depuis quand.
- Alimenter une chaîne de remédiation automatique — retrait d'un accès public, ajout d'une étiquette de règle, ouverture d'un ticket — à partir des résultats les plus graves.
À éviter comme unique barrière d'accès : identifier une donnée sensible ne la protège pas, ce sont IAM, les étiquettes de règle BigQuery et VPC Service Controls qui décident qui la lit. À éviter aussi comme classificateur infaillible : les détecteurs rendent une probabilité, pas une certitude, et un infoType mal calibré produit des faux positifs en masse — les détecteurs personnalisés et les règles d'exclusion sont indispensables sur des données métier. Enfin, inspecter systématiquement des volumes massifs coûte cher : l'échantillonnage et la découverte existent pour ça.
Dans la console
Alternatives en logiciel libre
- Microsoft Presidio : détection et anonymisation de données personnelles dans du texte et des images, avec reconnaissance par modèle et par règles — l'équivalent libre le plus complet, extensible par détecteurs personnalisés.
- ARX Data Anonymization Tool : anonymisation de tables avec calcul du k-anonymat, de la l-diversité et de la t-proximité, et arbitrage entre risque et utilité.
- Amnesia : outil d'anonymisation de jeux de données tabulaires et de données de séquence, publié par un projet de recherche européen.
- spaCy (MIT) avec un modèle de reconnaissance d'entités nommées : détection d'identifiants dans du texte libre, en bibliothèque plutôt qu'en service.
- 🧊 scrubadub (Apache 2.0) : nettoyage d'identifiants personnels dans du texte, par détecteurs et remplacement.
- DataFog : classification de données sensibles orientée pipelines, applicable avant chargement dans un entrepôt.
- Apache Ranger : pour la partie masquage à la lecture — politiques de masquage de colonnes appliquées par le moteur de requête plutôt que par transformation préalable.