Model Garden
- Recherche d'un modèle dans le catalogue par tâche, fournisseur et fonctionnalité, puis lecture de sa fiche
- Dépôt du jeu de données de réglage
- Réglage fin du modèle ouvert choisi, sur l'infrastructure gérée
- Déploiement du modèle sur un endpoint, avec le conteneur de service fourni (vLLM, Hex-LLM)
- L'application interroge son endpoint dédié : machines réservées, facturées tant qu'il est déployé
- Ou appel d'un modèle géré à l'API, facturé aux jetons, sans infrastructure à réserver
Ce que c'est
Catalogue de modèles d'apprentissage automatique de Gemini Enterprise Agent Platform : il sert à découvrir, essayer, personnaliser et déployer des modèles de Google, de ses partenaires et de la communauté, depuis un seul endroit et selon un schéma de déploiement identique d'un modèle à l'autre.
- Trois familles : les modèles de fondation préentraînés multitâches, appelables tels quels ou personnalisables ; les modèles réglables, affinés par un notebook ou un pipeline ; les solutions par tâche, prêtes à l'emploi et souvent personnalisables avec ses propres données.
- Deux modes de consommation. Le modèle en tant que service : l'appel passe par l'API de la plateforme, sans machine à réserver, facturé aux jetons — c'est le cas des modèles Gemini et de modèles partenaires. Le déploiement : le modèle ouvert est servi sur un endpoint dédié, avec un conteneur de service fourni (vLLM, Hex-LLM pour les TPU, xDiT pour l'image et la vidéo) et le coût des machines et accélérateurs associés.
- Recherche dans le catalogue par tâche, collection (modèles gérés par Google, par un partenaire ou par soi), fournisseur et fonctionnalité ; chaque modèle a une fiche qui documente son usage, ses licences et ses options de déploiement.
- Analyse de sécurité : Google teste les conteneurs de service et de réglage qu'il fournit et les analyse en continu ; les modèles des partenaires mis en avant passent par une vérification d'empreinte, ceux du Hub Hugging Face sont analysés par Hugging Face (logiciels malveillants, fichiers pickle, secrets). Un modèle jugé dangereux est bloqué au déploiement, un modèle suspect reste signalé mais déployable.
- Contrôle d'accès : une règle d'administration Model Garden, posée au niveau de l'organisation, du dossier ou du projet, restreint les modèles utilisables à une liste validée.
Un modèle ouvert déployé sur un endpoint coûte le prix des machines, qu'il serve ou non des requêtes ; un modèle géré appelé à l'API ne coûte que les jetons. Pour un trafic faible ou intermittent, le second gagne presque toujours.
À quoi ça sert
- Comparer et essayer plusieurs modèles avant de choisir, depuis la console, sans écrire de code de service.
- Déployer un modèle ouvert (Gemma, Llama, Qwen, modèles du Hub Hugging Face) sur un endpoint géré, avec un conteneur de service optimisé déjà prêt.
- Régler finement un modèle ouvert sur ses propres données, puis le déployer par le même chemin.
- Encadrer ce que les équipes ont le droit d'utiliser : catalogue restreint à des modèles validés.
À éviter pour héberger un modèle sur une infrastructure que l'on maîtrise ligne à ligne, ou pour mutualiser des GPU déjà réservés entre plusieurs charges : un déploiement vLLM sur GKE donne ce contrôle. À éviter aussi comme registre des modèles maison : c'est le rôle de Model Registry, dans Agent Platform.
Dans la console
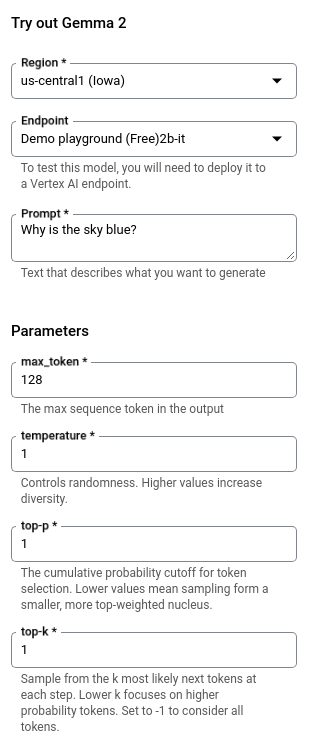
Alternatives en logiciel libre
- Hugging Face Hub avec les bibliothèques
transformersethuggingface_hub: le catalogue de référence des modèles ouverts, avec fiches, versions et licences. - vLLM : serveur d'inférence pour les grands modèles de langage, celui que Model Garden emploie lui-même dans ses conteneurs de service.
- Ollama : récupération et exécution locales de modèles ouverts en une commande, pour le poste de développement et les petits serveurs.
- KServe, BentoML : déploiement de modèles sur Kubernetes derrière une API stable, l'équivalent d'un endpoint.
- MLflow Model Registry : catalogue et versionnement de modèles maison, à côté du catalogue de modèles publics.