Managed Service for Prometheus
- Chaque pod expose ses métriques au format Prometheus ; une ressource PodMonitoring déclare la cible à l'opérateur du cluster.
- Le collecteur managé, déployé en DaemonSet, interroge les cibles de son nœud et pousse les échantillons dans le magasin global.
- En collecte auto-déployée, le binaire Prometheus de Google remplace celui d'origine et écrit directement, sans opérateur.
- Les règles d'enregistrement et d'alerte au format Prometheus sont évaluées côté service, sans serveur de règles à exploiter.
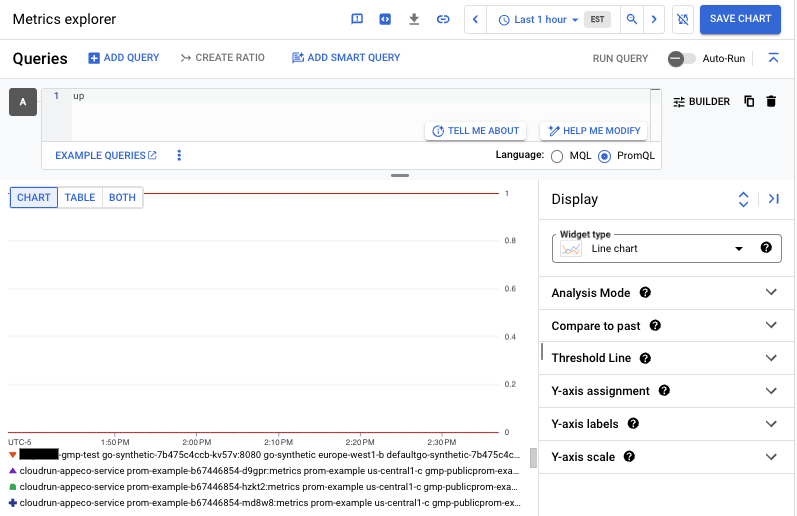
- Les séries deviennent des métriques Cloud Monitoring ordinaires : explorateur, tableaux de bord et règles d'alerte en PromQL.
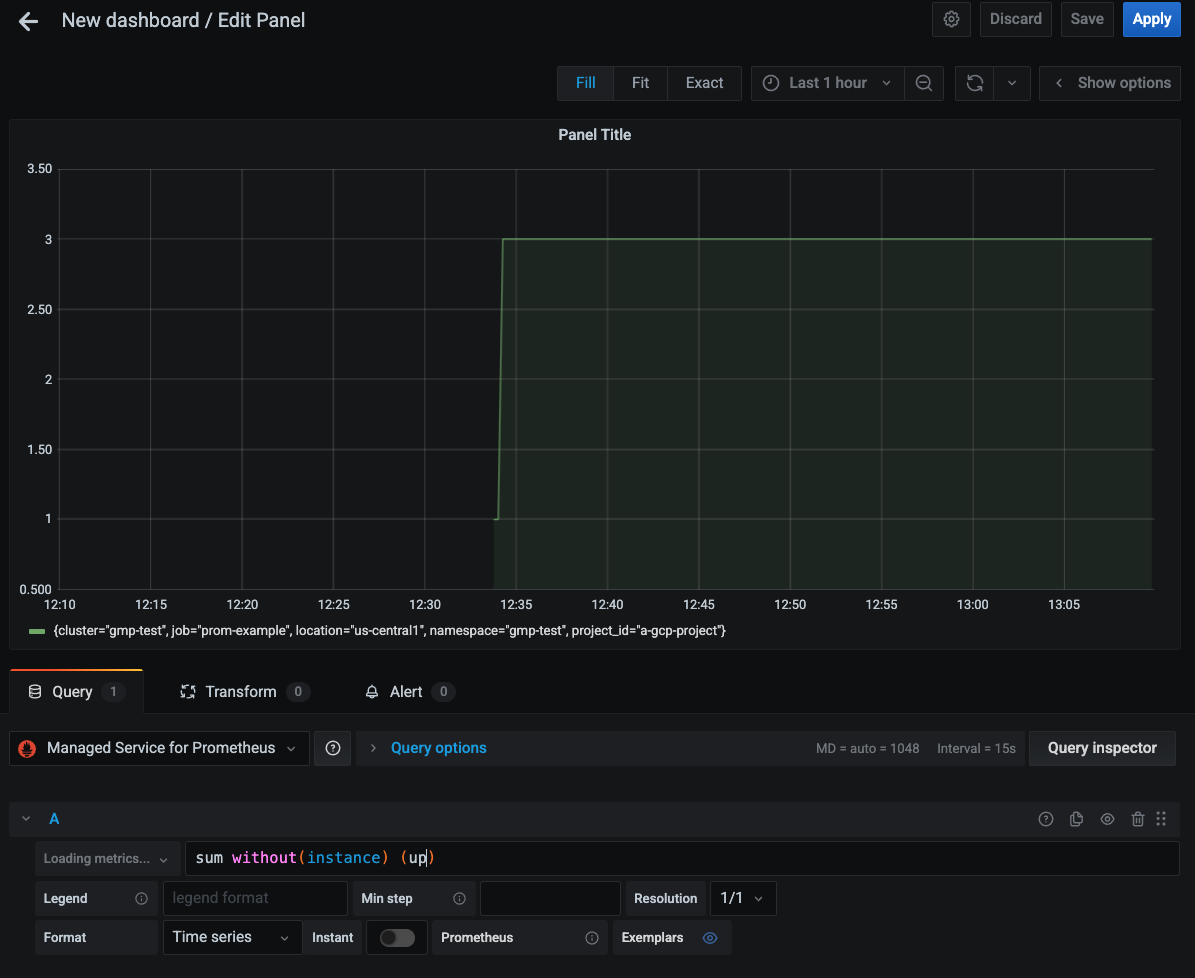
- Grafana interroge l'API compatible Prometheus ; le data source syncer renouvelle le jeton d'accès Google de la source de données.
Ce que c'est
Composant métriques Prometheus de Google Cloud Observability, le nom d'ensemble qui réunit Cloud Monitoring, Cloud Logging, Cloud Trace, Error Reporting et Cloud Profiler. Il conserve l'écosystème Prometheus — format d'exposition, PromQL, règles, tableaux de bord — en remplaçant le serveur et son stockage local par Monarch, le magasin global de Google.
- Deux modes de collecte. La collecte managée est la voie recommandée sur Kubernetes : un opérateur est déployé dans le cluster, les cibles se déclarent par des ressources personnalisées PodMonitoring (portée espace de noms) et ClusterPodMonitoring (portée cluster), et Google prend en charge la mise à l'échelle et les mises à jour des collecteurs. La collecte auto-déployée remplace le binaire Prometheus par une version de Google qui écrit dans Monarch : elle convient aux configurations existantes complexes, mais le support technique y est limité.
- Hors Kubernetes. Les VM et les charges hors cluster passent par l'agent Ops, qui sait interroger des points
/metrics, ou par le collecteur OpenTelemetry construit par Google. - Stockage. Rétention de 24 mois sans surcoût, requêtes possibles sur toutes les régions et sur un grand nombre de projets à la fois, sans fédération ni instance à dimensionner.
- Interrogation. PromQL est servi par une API compatible Prometheus (
monitoring.googleapis.com/v1/.../prometheus), que Grafana interroge avec un jeton Google tenu à jour par le data source syncer, la méthode recommandée ; le mandataire d'authentification (frontend) reste documenté pour les installations existantes. Les mêmes requêtes s'écrivent dans l'explorateur de métriques de Cloud Monitoring et dans les conditions de règles d'alerte. - Règles. Les fichiers de règles Prometheus — enregistrement et alerte — s'appliquent soit par des ressources
Rulesévaluées côté service, soit par un évaluateur de règles autonome. Les alertes partent vers Cloud Monitoring, ou vers un Alertmanager existant. - Métriques du plan de contrôle et de kube-state. Le serveur d'API, le planificateur et le contrôleur de GKE, ainsi que
kube-state-metricsetnode-exporter, s'activent en une option du cluster, sans déployer les exportateurs soi-même. - Facturation à l'échantillon ingéré, dégressive par paliers, et non à l'octet comme le reste de Cloud Monitoring — c'est pourquoi les métriques de cardinalité élevée y reviennent moins cher. Les requêtes sont facturées de façon marginale.
Le coût suit la cardinalité, pas le nombre de métriques : une étiquette qui porte un identifiant de requête, une adresse IP ou un horodatage multiplie les séries et la facture. Les filtres de l'opérateur (
metricRelabeling) permettent d'écarter une métrique ou une étiquette avant l'envoi.
À quoi ça sert
- Garder des tableaux de bord et des alertes Prometheus déjà écrits en supprimant le serveur, son disque, sa haute disponibilité et sa fédération.
- Interroger d'un coup les métriques de dizaines de clusters GKE et de plusieurs régions, sans monter un étage de Thanos ou de Cortex.
- Instrumenter une application avec les bibliothèques Prometheus classiques et retrouver ces métriques à côté des métriques d'infrastructure dans la même console.
- Exposer les métriques du plan de contrôle du cluster et les métriques
kube-statesans déployer ni maintenir les exportateurs correspondants. - Alimenter en PromQL l'autoscaler Kubernetes par l'adaptateur de métriques personnalisées.
À éviter quand la charge n'est pas en conteneurs et n'expose rien au format Prometheus : pour une flotte de VM et des applications tierces, l'agent Ops et Cloud Monitoring demandent moins de mise en place. À éviter aussi pour un besoin de stockage strictement local, hors ligne ou sans dépendance au cloud : c'est le cas d'usage de Prometheus lui-même. Enfin, ce n'est pas un remplaçant d'Alertmanager pour qui tient à ses silences, à ses regroupements et à ses passerelles maison — l'évaluateur de règles peut continuer à lui envoyer les alertes.
Dans la console
Alternatives en logiciel libre
- Prometheus (Apache 2.0) : le logiciel dont c'est l'implémentation managée — même format d'exposition, même PromQL, même syntaxe de règles.
- Thanos (Apache 2.0) : rétention longue sur stockage objet et vue globale sur plusieurs Prometheus, ce que Monarch apporte ici sans composants supplémentaires.
- Grafana Mimir (AGPL v3) : stockage Prometheus distribué et multi-locataire, avec évaluation de règles côté serveur, l'équivalent fonctionnel le plus complet.
- VictoriaMetrics (Apache 2.0) : base compatible PromQL, économe en ressources, avec
vmagentpour la collecte etvmalertpour les règles. - Cortex (Apache 2.0) : ancêtre commun de ces architectures, toujours maintenu, orienté multi-locataire.
- Prometheus Operator et kube-prometheus (Apache 2.0) : opérateur Kubernetes et ses ressources
ServiceMonitoretPodMonitor, dontPodMonitoringreprend le principe. - OpenTelemetry Collector (Apache 2.0) : récepteur Prometheus et exportateurs multiples, pour qui veut une seule chaîne de collecte pour les métriques, les traces et les journaux.
- Alertmanager (Apache 2.0) : routage, regroupement et mise en sourdine des alertes produites par les règles.