Managed Service for Apache Spark
- Le DAG crée un cluster éphémère (ou lance un batch serverless) et soumet le job PySpark ; il supprime le cluster à la fin
- Lecture des données brutes par le connecteur Cloud Storage (gs://)
- Écriture des résultats par le connecteur BigQuery
- Écriture des fichiers transformés dans le lac de données
Ce que c'est
Service géré pour exécuter Apache Spark et l'écosystème Hadoop, sous deux formes :
- Clusters : des VMs Compute Engine (un nœud maître, des nœuds de calcul) préinstallées avec Spark, Hadoop, Hive, et en option Flink, Trino, Jupyter. Création en une à deux minutes, autoscaling, nœuds secondaires en VMs Spot pour réduire le coût.
- Serverless : des batches et des sessions interactives Spark sans cluster à gérer ; le service alloue les ressources le temps du job.
Les données restent de préférence dans Cloud Storage (connecteur gs://) ou BigQuery plutôt que dans le HDFS du cluster : le cluster devient jetable. Le catalogue des tables peut être partagé entre clusters par un metastore Hive géré. La facturation s'ajoute au prix des ressources Compute Engine utilisées, à la seconde.
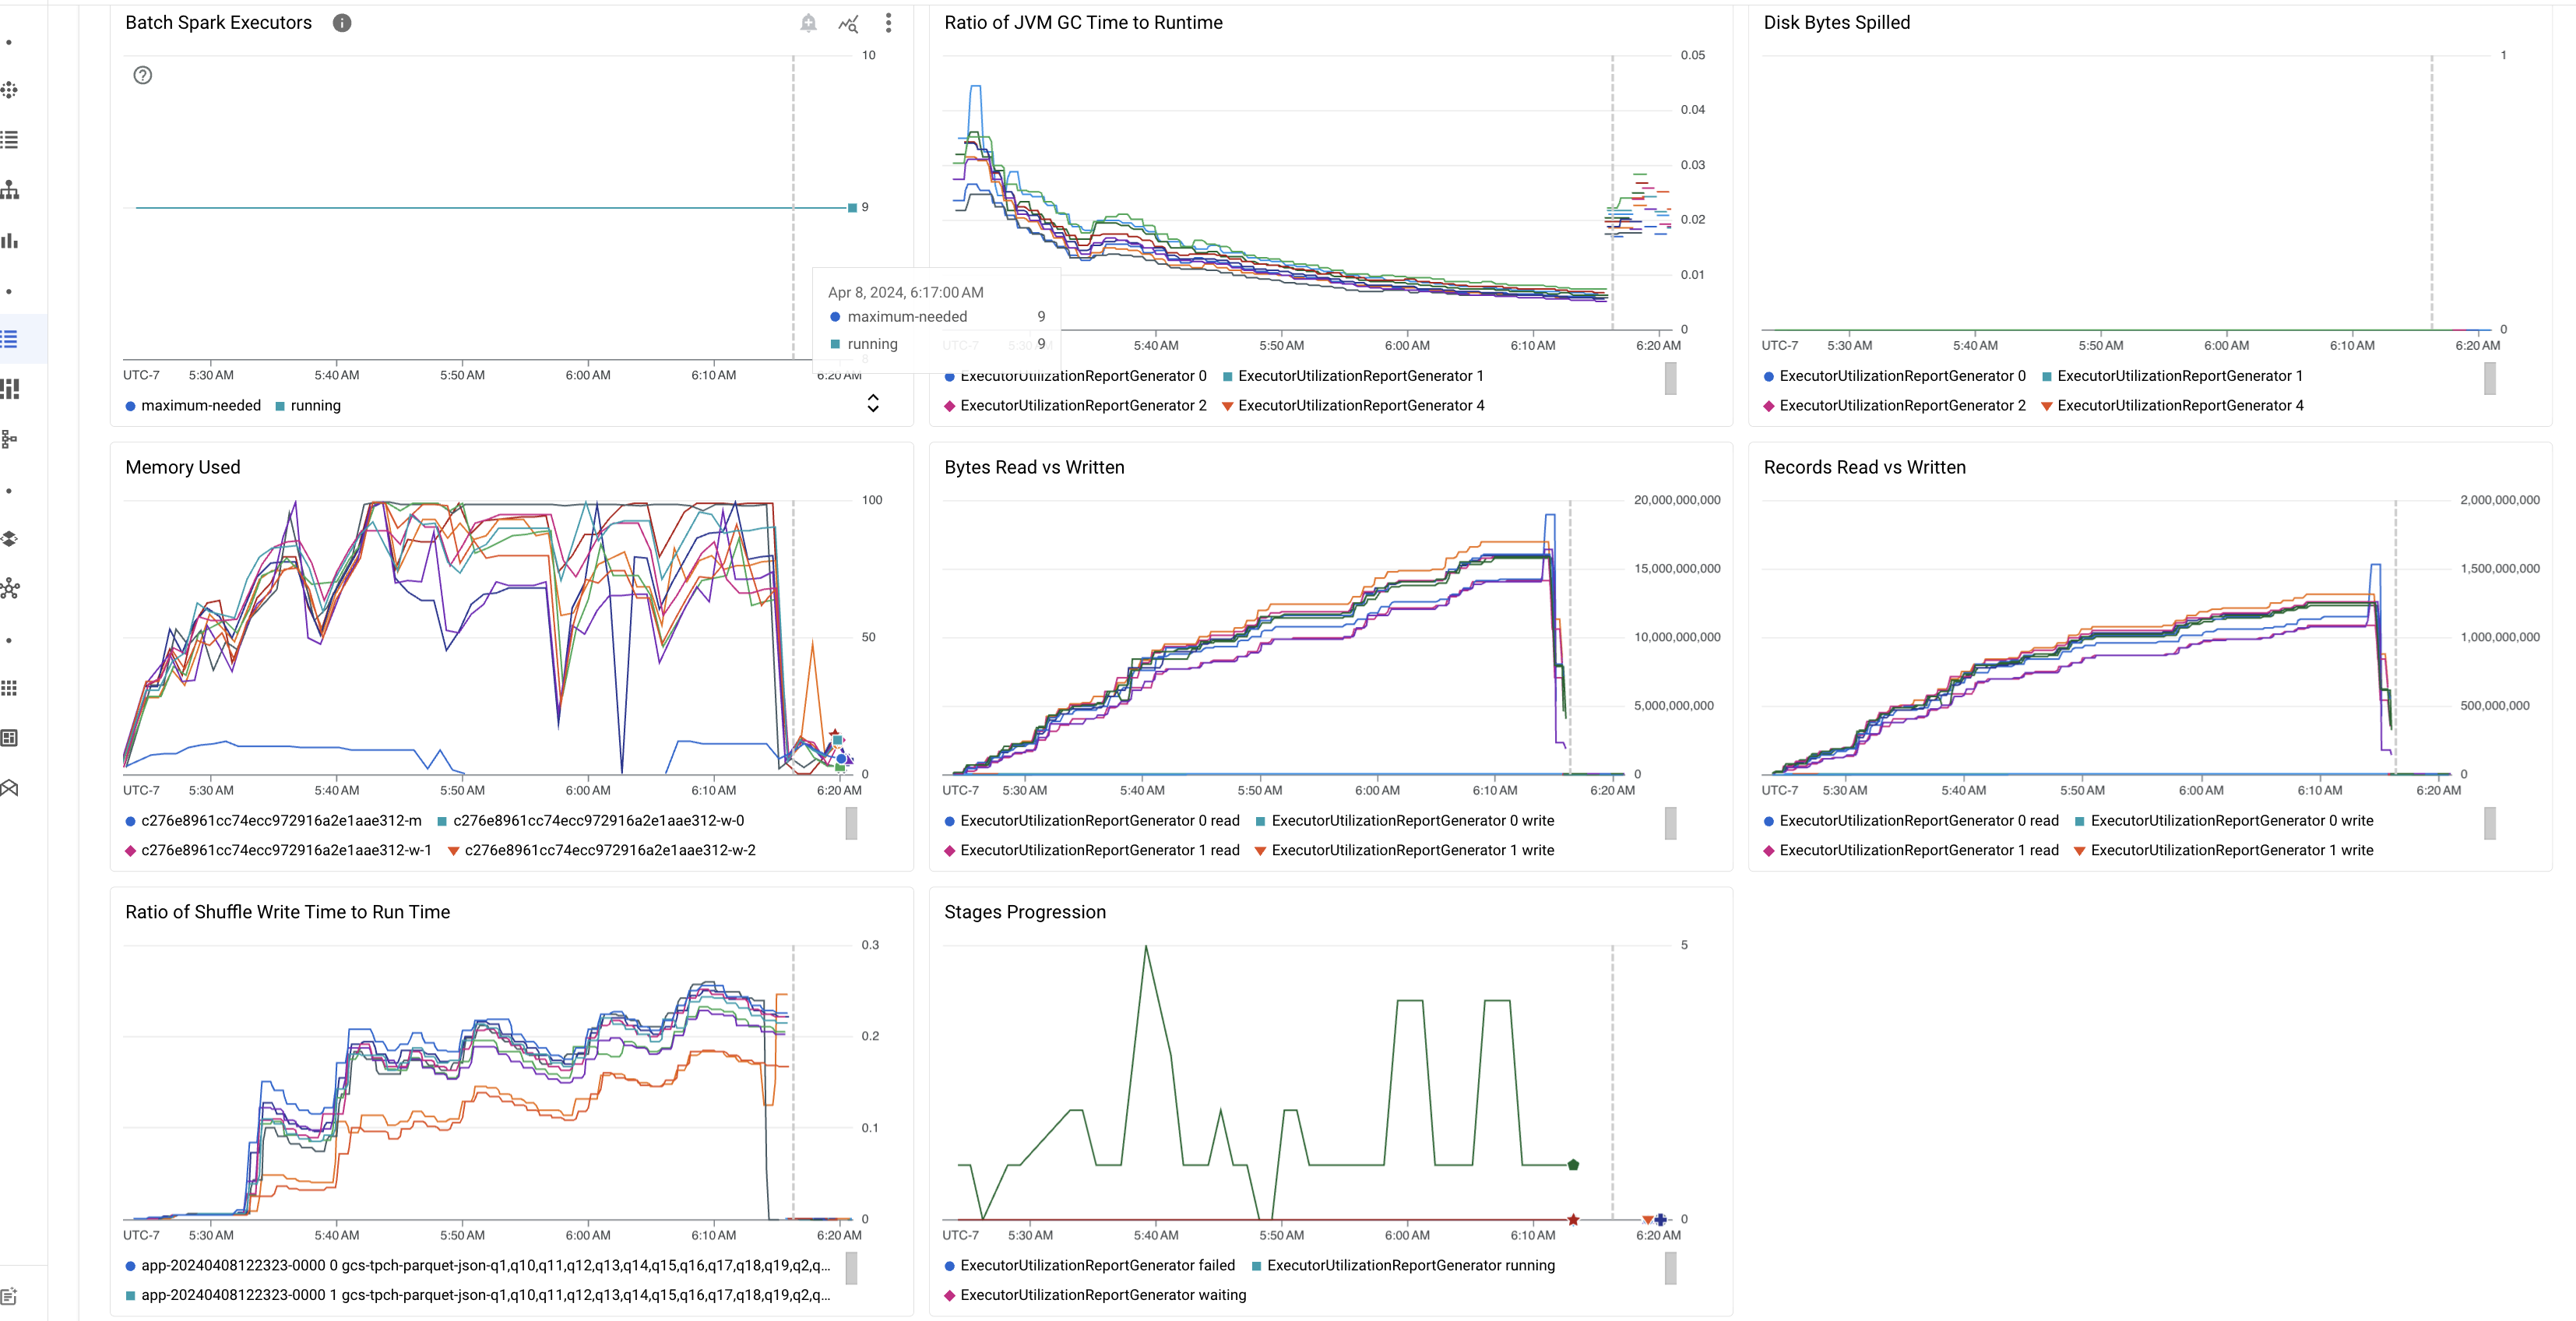
Autoscaling des clusters. Une politique d'autoscaling fait varier le nombre de nœuds de calcul d'après la mémoire YARN en attente ou disponible ; le nœud maître et le type de machine ne changent pas. La documentation en fixe l'usage :
- Adapté aux clusters dont les données sont hors du cluster (Cloud Storage, BigQuery), aux clusters qui enchaînent de nombreux jobs, et pour agrandir un cluster dédié à un seul job.
- Nœuds secondaires seulement. Les nœuds principaux portent les DataNodes HDFS : en retirer un impose de recopier ses blocs, parfois pendant des heures, et le décommissionnement peut rester bloqué. Fixer leur nombre (
minInstanceségal àmaxInstances) et faire varier les nœuds secondaires, de calcul pur. - Déconseillé pour dimensionner un HDFS sur le cluster, avec Spark Structured Streaming (non pris en charge), et pour réduire un cluster inactif : un cluster se recrée aussi vite qu'il se redimensionne, donc on le supprime (workflow, DAG Airflow, ou suppression planifiée après une durée d'inactivité).
- Décommissionnement progressif (graceful decommissioning) : avant de retirer un nœud, YARN attend la fin des applications en cours, au plus
gracefulDecommissionTimeout; au-delà, le nœud est arrêté de force, au risque de perdre des données. Régler ce délai au-dessus de la durée du plus long job, et isoler les jobs longs sur leur propre cluster éphémère : sur un cluster partagé, ils retardent la réduction pour tous les autres.
À quoi ça sert
- Migrer des traitements Spark ou Hadoop existants sans les réécrire.
- Jobs PySpark ou Spark SQL de transformation par lots, préparation de données pour le ML.
- Clusters éphémères : un cluster créé pour un job ou un workflow, puis supprimé, plutôt qu'un gros cluster permanent.
À éviter pour un nouveau pipeline sans existant Spark : Dataflow (Apache Beam, serverless, batch et streaming unifiés) ou BigQuery en SQL demandent moins d'exploitation.
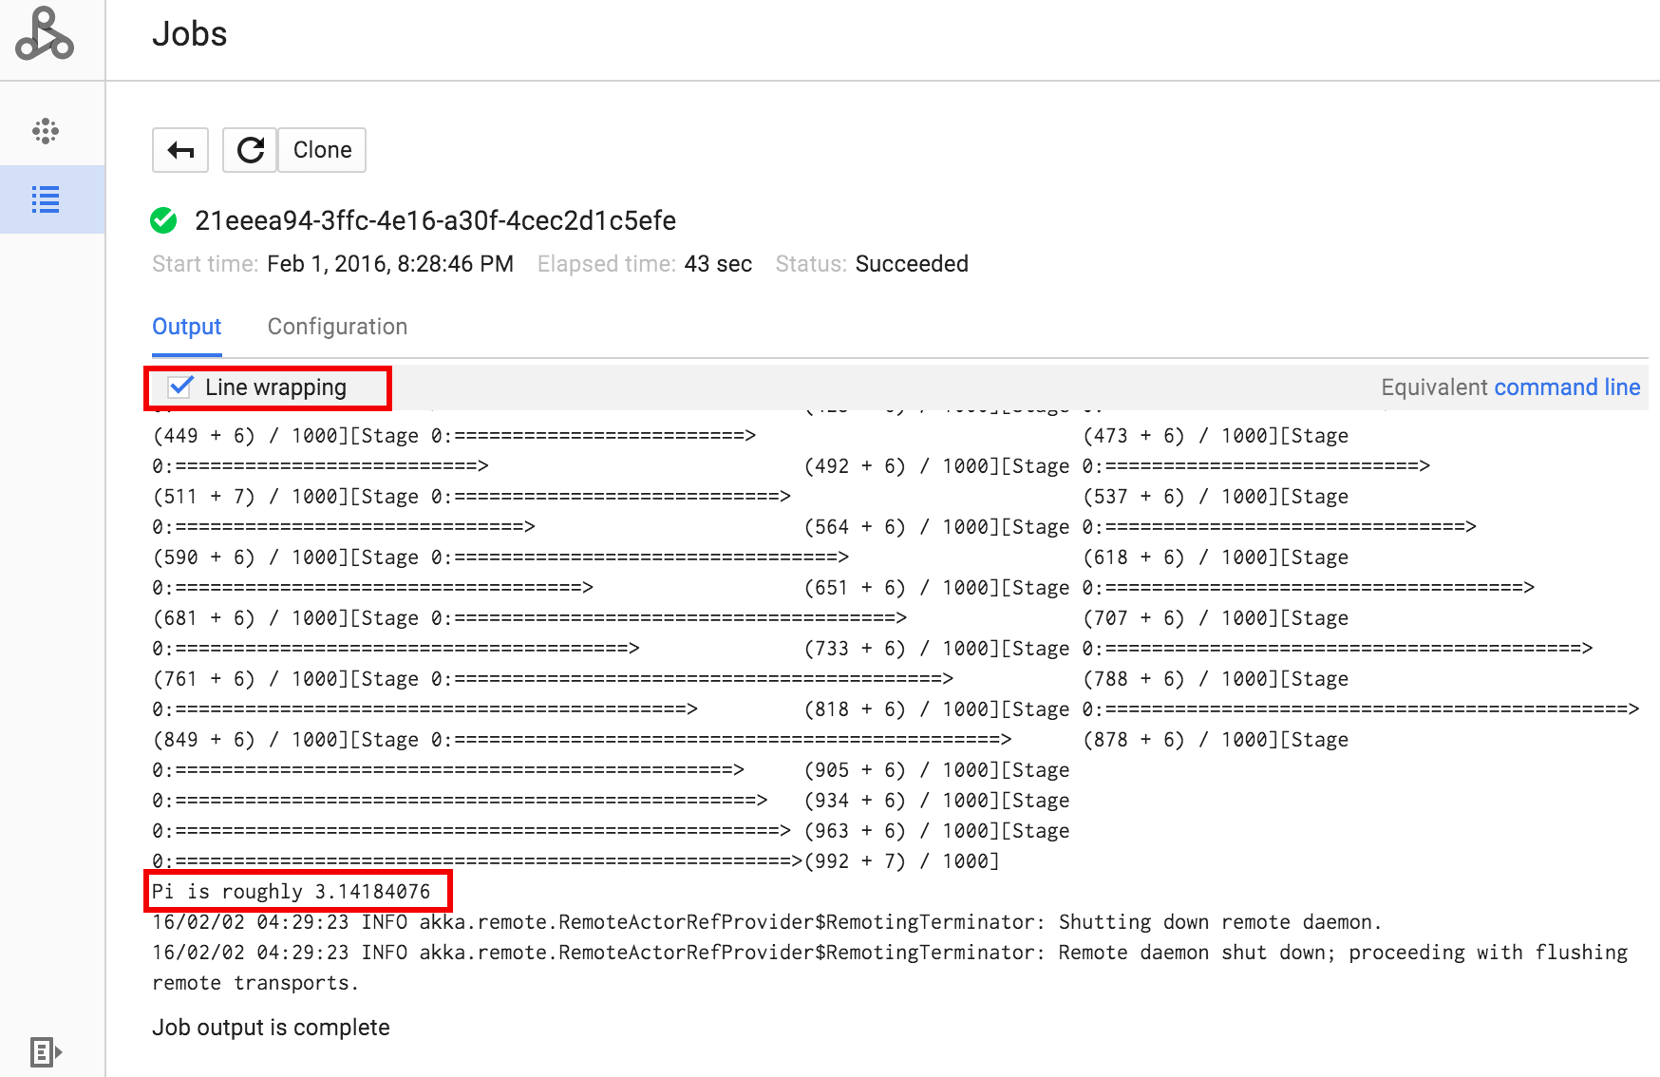
Dans la console
Alternatives en logiciel libre
- Apache Spark lui-même, sur un cluster autogéré : YARN (Hadoop) ou Kubernetes avec le Spark Operator.
- Apache Flink : traitement de flux avec état, et batch.
- Trino : SQL distribué sur le lac de données, quand le traitement s'exprime en SQL.
- Apache Hadoop MapReduce et Apache Hive : l'écosystème historique, pour des traitements existants.