Knowledge Catalog
- Les datasets et tables BigQuery sont catalogués automatiquement : schémas, colonnes, descriptions générées
- Les analyses de découverte parcourent les fichiers non structurés et en extraient entités et relations
- La connectivité gérée importe les métadonnées de systèmes externes sans pipeline à écrire
- Les analyses de qualité et de profil s'exécutent sur les tables et publient leurs résultats dans le catalogue
- Recherche en langage naturel : l'analyste retrouve la table pertinente et sa définition métier
- Un agent lit le contexte par serveur MCP ou par l'API Context, ce qui ancre ses réponses sur des définitions vérifiées
Ce que c'est
Catalogue de données et couche de gouvernance : il recense les actifs d'un patrimoine de données, leur attache un sens métier, mesure leur qualité et restitue ce contexte aux humains comme aux agents. L'API, la CLI et les rôles IAM gardent leur préfixe dataplex.
- Métadonnées : le modèle repose sur des entrées (entries), regroupées en groupes d'entrées, décrites par des aspects — des blocs de métadonnées typés par un type d'aspect, dont on peut définir les siens. Des liens d'entrées relient deux entrées entre elles.
- Agrégation : catalogage automatique de BigQuery, AlloyDB, Spanner, Cloud Storage ; connectivité gérée pour importer les schémas de systèmes externes (Oracle, PostgreSQL, registres partenaires) ; ingestion des tableaux de bord et du LookML de Looker.
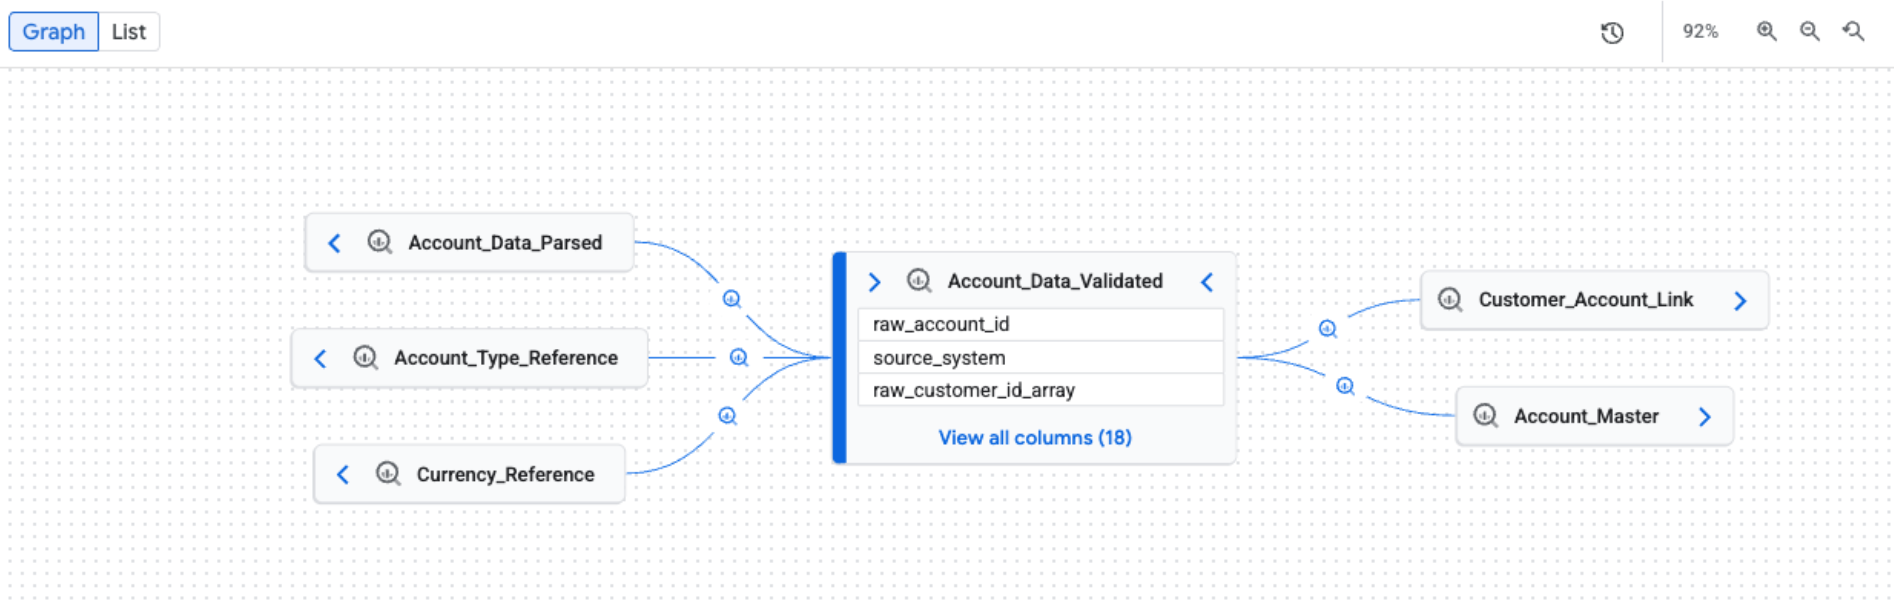
- Lignage : suivi des transformations jusqu'au niveau de la colonne, alimenté automatiquement par BigQuery, Cloud Data Fusion, Datastream et les jobs Spark, et consultable en vue graphe ou en liste.
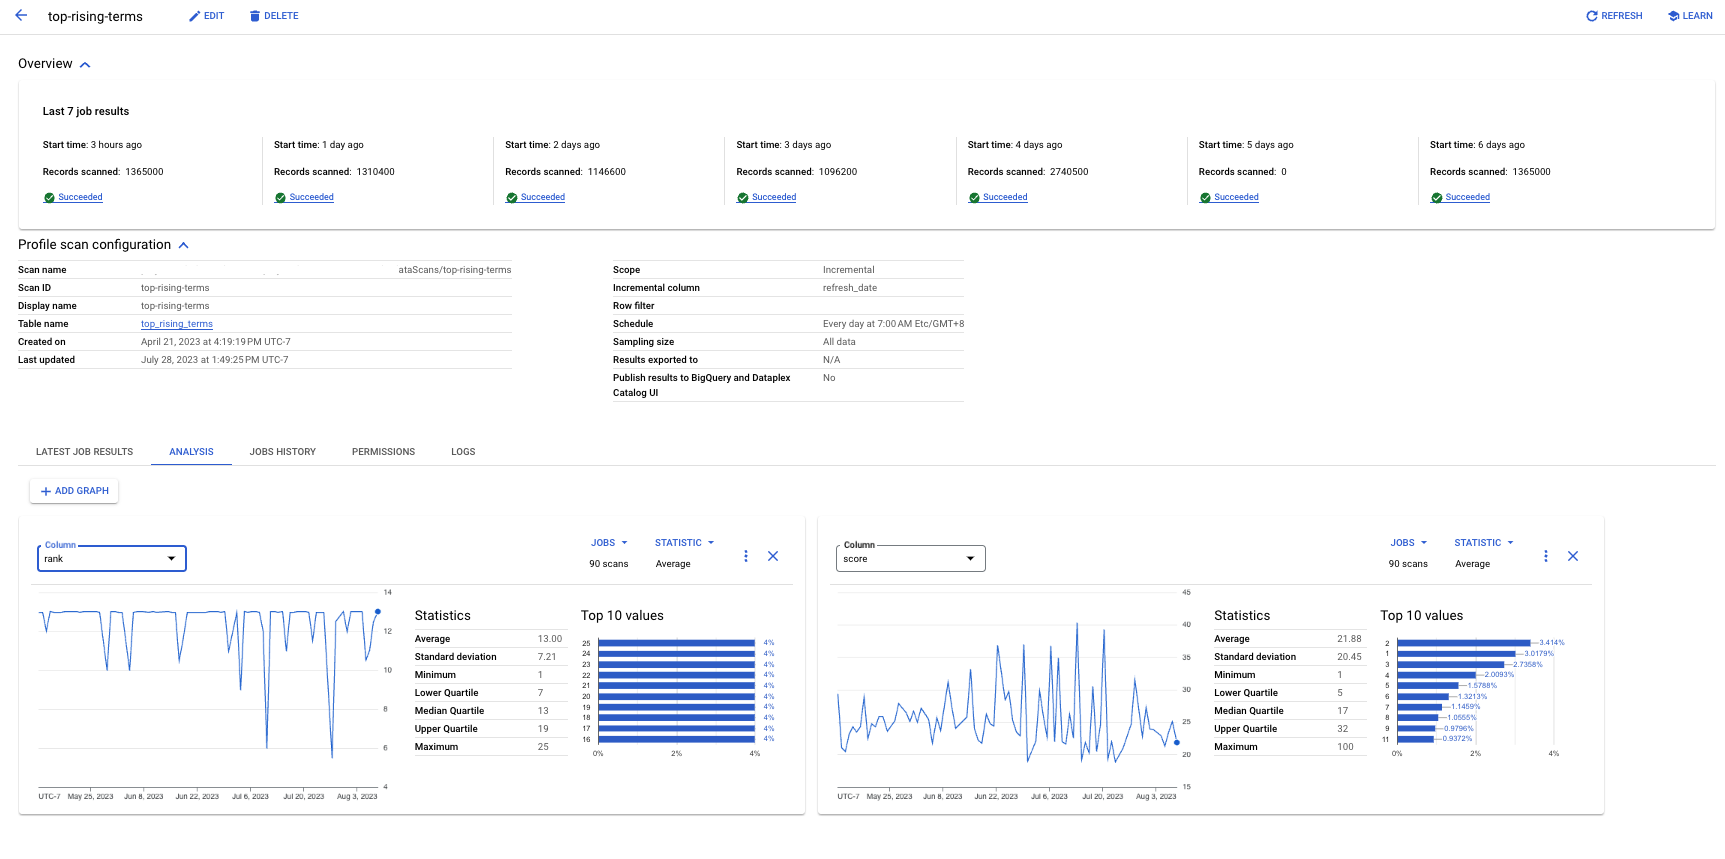
- Qualité et profil : des scans planifiés ou à la demande calculent des statistiques par colonne et vérifient des règles de qualité ; les résultats peuvent être publiés dans le catalogue et servir de signal de confiance.
- Sens métier : glossaires d'entreprise pour normaliser le vocabulaire, descriptions de tables et de colonnes générées par Gemini puis relues, produits de données qui empaquettent un ensemble d'actifs avec leur contrat et leur propriétaire.
- Restitution : recherche sémantique en langage naturel dans la console, serveurs MCP et API Context (
LookupContext) pour fournir ce contexte à une application ou à un agent. - Produits de données (data products) : un ensemble d'assets choisis et documentés — tables, vues, modèles — publié pour être trouvé et partagé, avec ses règles d'accès ; les assets d'un produit sont dans la même région que lui. Les lakes et zones (regroupement des données par domaine) existent dans l'API, sans être décrits dans la documentation actuelle.
- Facturation : à l'unité de calcul (Data Compute Unit, DCU), en palier standard (découverte) ou premium (lignage, qualité, profil), plus le stockage des métadonnées. 100 DCU-heures de palier standard sont offertes chaque mois. Les fonctions assistées par Gemini sont facturées avec Gemini dans BigQuery.
À quoi ça sert
- Répondre à « où est la donnée dont j'ai besoin, d'où vient-elle et peut-on s'y fier ? » sans passer par un tableur de recensement tenu à la main.
- Analyse d'impact avant un changement de schéma : le lignage au niveau colonne montre ce qui casse en aval.
- Contrôle continu de la qualité : règles versionnées, scans planifiés, alertes sur les écarts.
- Ancrer des agents et des applications d'IA générative sur des définitions vérifiées plutôt que sur des schémas recopiés dans un prompt — c'est ce dont se servent les agents de données BigQuery.
À éviter comme outil de contrôle d'accès : Knowledge Catalog décrit et gouverne les métadonnées, mais les droits restent portés par IAM, les policy tags et la sécurité au niveau ligne ou colonne de BigQuery. Pour le chiffrement et la détection de données sensibles, c'est Sensitive Data Protection. Pour publier des données hors de l'organisation, avec abonnement et contrôle de l'export, c'est le partage BigQuery (voir Partager des données) : Knowledge Catalog sert la découverte interne, et indexe les datasets partagés.
Dans la console
Alternatives en logiciel libre
- DataHub : catalogue et lignage au niveau colonne, avec un modèle de métadonnées extensible ; l'équivalent le plus complet.
- OpenMetadata : catalogue, qualité des données, glossaire métier et lignage, avec une intégration native de nombreuses sources.
- Apache Atlas : catalogue et lignage de l'écosystème Hadoop, toujours répandu sur les plateformes existantes.
- Great Expectations : contrôle de qualité des données par règles, l'équivalent des scans de qualité.
- OpenLineage : format et collecteurs de lignage ouverts, que DataHub, OpenMetadata et Marquez savent consommer.