Google Kubernetes Engine
- Les nœuds tirent depuis Artifact Registry les images des conteneurs au démarrage de chaque Pod.
- Les requêtes des clients arrivent sur l'adresse publique du service.
- Une ressource Gateway ou Ingress programme un load balancer Google Cloud, qui répartit le trafic directement vers les Pods.
- Les Pods atteignent la base par son adresse IP privée, sur le même réseau VPC que les nœuds.
- Journaux et métriques système partent vers Cloud Logging et Managed Service for Prometheus.
- Le plan de contrôle, géré par Google, planifie les Pods et commande l'ajout ou le retrait de nœuds.
Ce que c'est
Kubernetes managé : Google exploite le plan de contrôle, applique les mises à jour et intègre le cluster au reste du projet — réseau VPC, IAM, Artifact Registry, Cloud Logging.
- Plan de contrôle géré. Serveur d'API, ordonnanceur, contrôleurs et base d'état sont tenus par Google, qui en assure les mises à niveau. L'état du cluster est stocké soit dans des instances etcd sur les VM du plan de contrôle, soit dans Spanner ; dans les deux cas le cluster sert l'API etcd. Un frais de gestion de 0,10 $ par cluster et par heure s'applique quels que soient le mode et la taille du cluster ; le palier gratuit couvre 74,40 $ de crédits par mois et par compte de facturation, soit un cluster zonal ou Autopilot.
- Mode Autopilot. Google gère l'infrastructure entière : nœuds, dimensionnement, sécurité. On déclare des Pods, GKE provisionne la capacité correspondante. Le cluster est forcément régional, inscrit dans un canal de publication, en VPC natif, avec Workload Identity Federation, Shielded GKE Nodes et GKE Sandbox activés d'office. La plateforme de calcul container-optimized, par défaut depuis la version 1.32.3-gke.1927002, redimensionne les nœuds en cours d'exécution. La facturation est au Pod — processeur, mémoire et stockage éphémère demandés — sauf pour les charges qui réclament du matériel précis (accélérateurs, série de machines), facturées au nœud avec une prime de gestion.
- Mode Standard. On crée et administre des pools de nœuds : groupes de nœuds de configuration identique (type de machine, image, disques SSD locaux, VM Spot, architecture Arm). Chaque nœud porte l'étiquette
cloud.google.com/gke-nodepool; on crée, met à niveau et supprime un pool sans toucher au reste du cluster, et lesnodeSelectoret taints dirigent les Pods vers le bon pool. Le cluster est zonal ou régional, et les nœuds sont facturés comme des instances Compute Engine. - Mise à l'échelle. Trois mécanismes se superposent : l'autoscaling horizontal des Pods sur les métriques, l'autoscaling vertical qui ajuste les demandes de ressources, et l'autoscaler de cluster qui ajoute ou retire des nœuds quand des Pods restent en attente ou que des nœuds se vident. Le provisionnement automatique de nœuds crée au besoin des pools entiers. Les ComputeClasses décrivent, en mode Standard comme en Autopilot, le matériel qu'une charge exige et la manière de le remplacer en cas de pénurie.
- Réseau. Les clusters sont VPC natifs : les Pods et les Services reçoivent leurs adresses depuis des plages d'alias de sous-réseau, ce qui les rend routables dans le VPC — la planification des plages d'adresses est donc à faire avant la création. GKE Dataplane V2, fondé sur eBPF, applique les règles réseau et donne la visibilité sur les flux. L'exposition passe par un Service
LoadBalancer(couche 4) ou par Gateway et Ingress (couche 7), qui programment un load balancer Google Cloud pointant directement sur les Pods. La résolution interne s'appuie sur kube-dns ou Cloud DNS. - Versions et canaux. Un cluster s'inscrit dans un canal de publication qui fixe le rythme des mises à niveau : Rapid (1 à 2 semaines après la sortie amont, hors SLA), Regular (le défaut, environ 2 mois plus tard), Stable (3 à 4 mois après Regular) et Extended, qui prolonge la durée de vie d'une version mineure. Les clusters Autopilot sont forcément inscrits dans un canal ; pour les clusters Standard, l'absence de canal déconseillé est dépréciée et disparaîtra le 14 juin 2027. Les fenêtres et exclusions de maintenance décident du moment des mises à niveau, jamais de leur principe : un correctif de sécurité critique est appliqué dans tous les canaux.
En mode Standard, on paie la capacité des nœuds, occupée ou non. Des demandes de ressources trop larges dans les manifestes se paient donc en nœuds sous-utilisés : c'est là que l'écart de facture avec Autopilot se creuse.
À quoi ça sert
- Héberger un ensemble de microservices conteneurisés avec un contrôle fin sur le placement, le réseau et les ressources.
- Faire tourner des charges que le serverless ne prend pas : applications avec état, StatefulSets, opérateurs, démons par nœud, protocoles hors HTTP.
- Entraîner et servir des modèles sur GPU et TPU, avec des pools dédiés et des VM Spot pour les travaux interruptibles.
- Porter une application déjà écrite pour Kubernetes, sur site ou chez un autre fournisseur, sans réécrire les manifestes.
- Servir de socle à une plateforme interne : Config Connector pour piloter les ressources Google Cloud depuis le cluster, Cloud Deploy pour la promotion entre environnements, Binary Authorization pour n'admettre que des images vérifiées.
À éviter pour une application web isolée ou une poignée de services HTTP sans exigence particulière : le frais de cluster, la gestion des versions et la charge d'exploitation ne se justifient pas face à Cloud Run, qui couvre le même besoin sans cluster. À éviter aussi de choisir le mode Standard par réflexe : il ne se justifie que si l'on a réellement besoin d'agir sur les nœuds — accès privilégié, démons système, matériel imposé, applications du Marketplace.
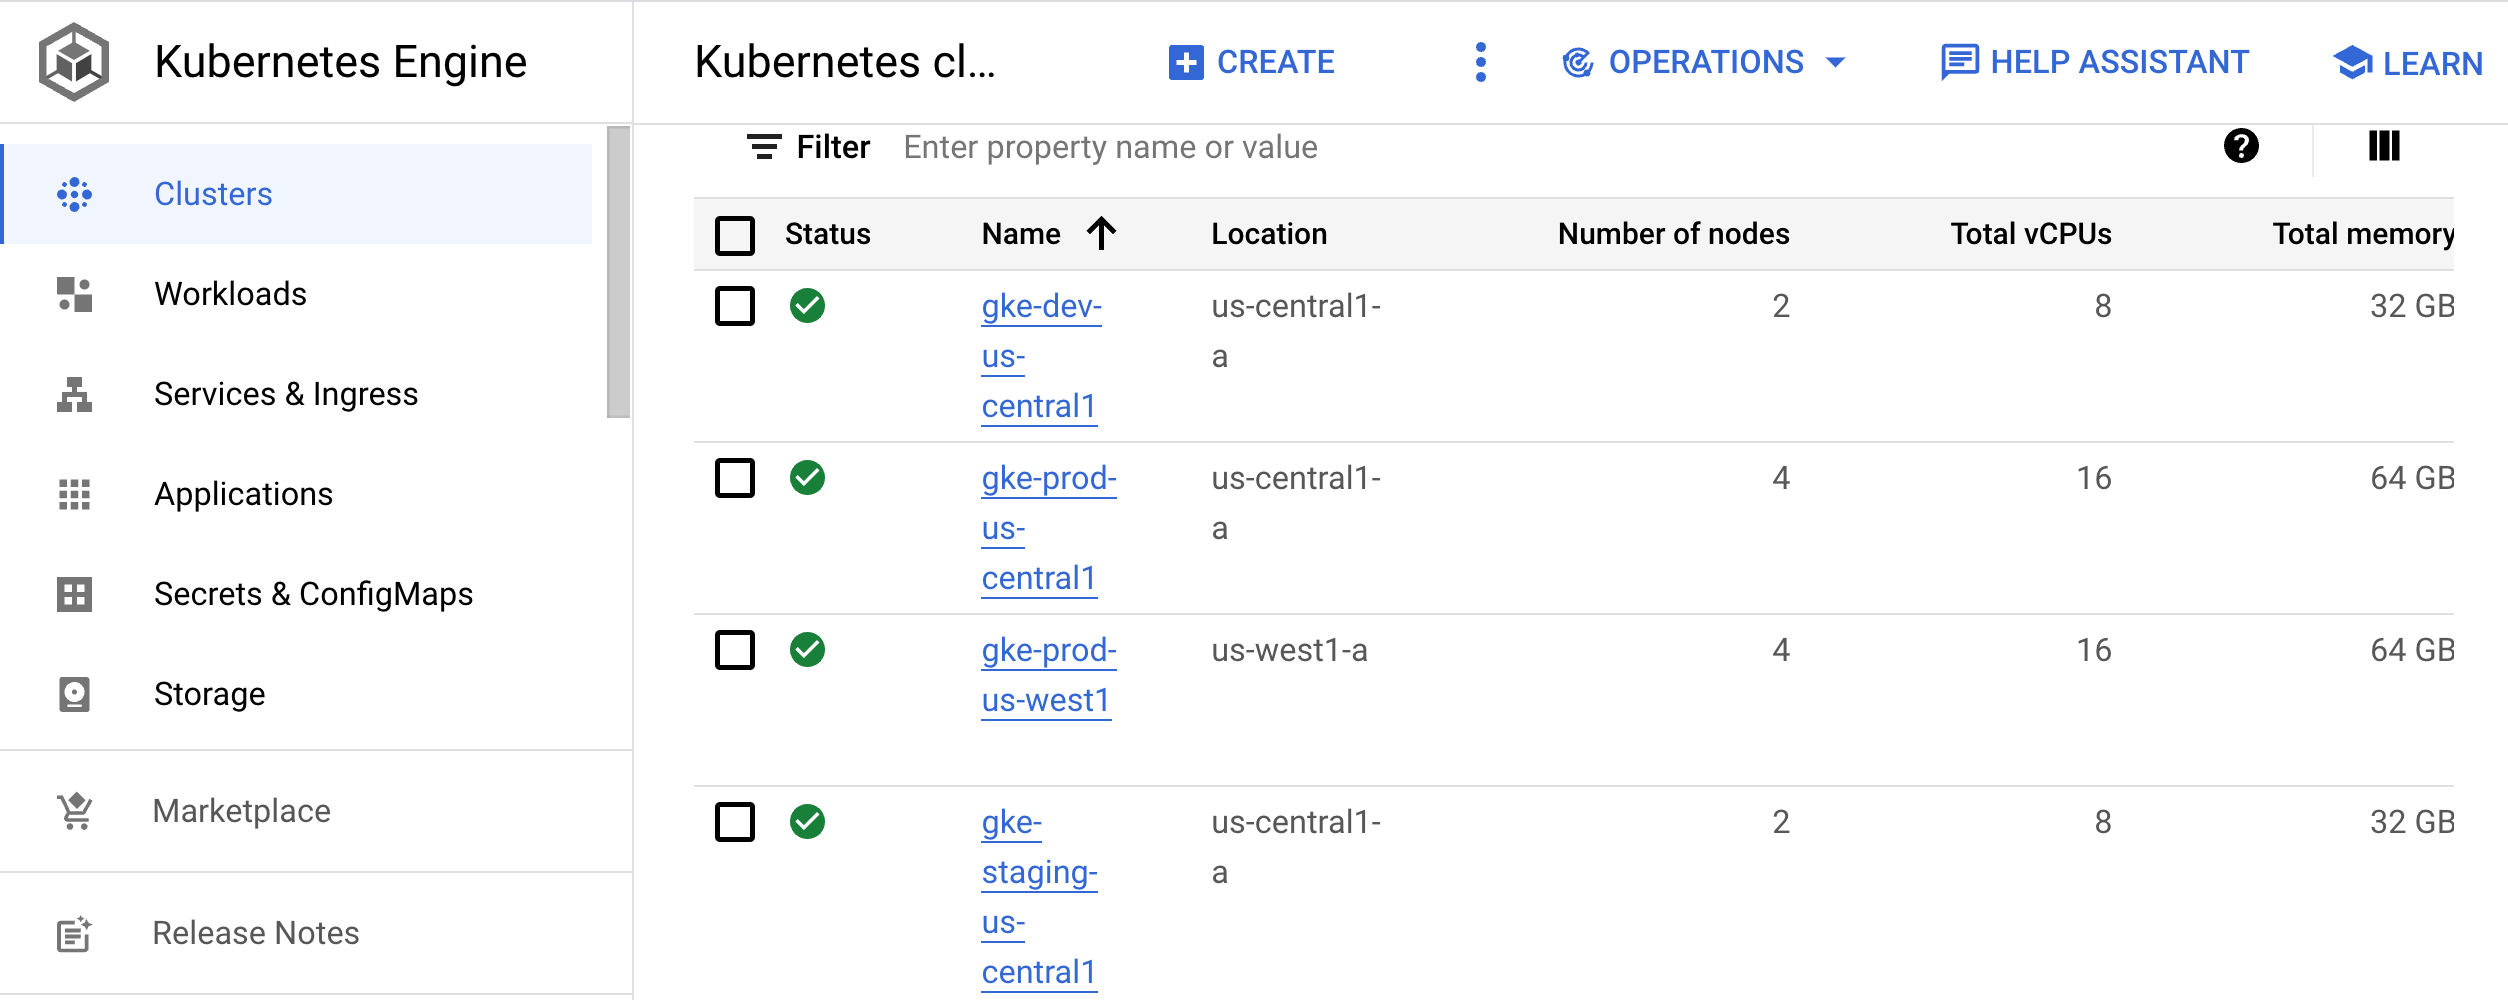
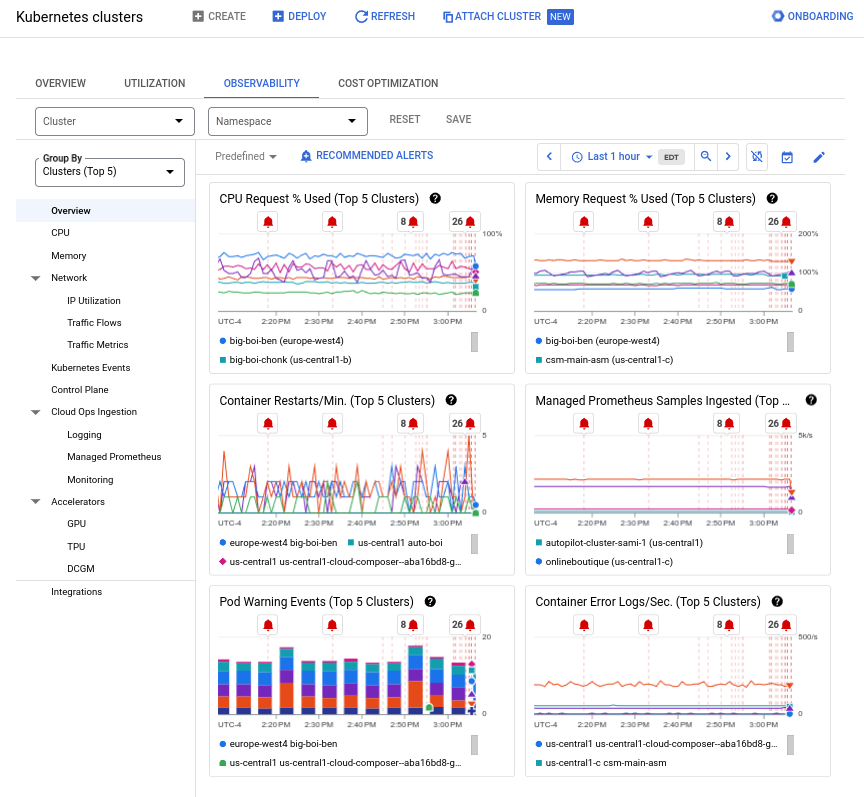
Dans la console
Alternatives en logiciel libre
- Kubernetes lui-même, installé avec kubeadm, kOps ou Cluster API : le même produit, dont il faut alors exploiter le plan de contrôle.
- k3s et MicroK8s : distributions Kubernetes allégées, pour un cluster de petite taille, un poste de développement ou l'embarqué.
- Talos Linux : système d'exploitation dédié à Kubernetes, entièrement piloté par API, dans l'esprit de Container-Optimized OS.
- OpenShift OKD et Rancher : distributions complètes avec console, gestion multi-clusters et outillage intégré, proches de l'expérience GKE Enterprise.
- Karpenter et Cluster Autoscaler : provisionnement automatique de nœuds, l'équivalent de l'autoscaler et des ComputeClasses.