Gemini Enterprise Agent Platform
- Lecture du jeu d'entraînement, directement ou via un dataset géré
- Le job récupère son code et son conteneur, et y dépose les artefacts du modèle
- Un pipeline enchaîne préparation, entraînement, évaluation et déploiement à chaque nouvelle version
- Le modèle entraîné est importé dans le registre, qui en garde les versions
- Déploiement d'une version sur un endpoint : machines et accélérateurs réservés au service du modèle
- L'application appelle l'endpoint en ligne (REST ou gRPC) pour chaque inférence
Ce que c'est
Plateforme unifiée d'apprentissage automatique et d'agents : elle couvre le cycle de vie complet, de l'accès aux modèles de fondation jusqu'au déploiement et à la surveillance en production. La documentation l'organise en quatre piliers.
- Build — construire. Agent Development Kit (ADK), cadre modulaire et indépendant du modèle ; Agent Studio, atelier visuel à faible code ; Agent Garden, bibliothèque d'agents et de modèles de départ ; Model Garden (voir Model Garden) ; RAG Engine et Vector Search pour brancher des données privées sur un modèle ; Managed Agents API, pilotée par configuration, qui exécute l'agent dans un bac à sable géré.
- Scale — mettre à l'échelle. Agent Runtime est le runtime managé où l'on déploie un agent ; Sessions conserve l'état d'une conversation, Memory Bank la mémoire persistante d'un utilisateur d'une session à l'autre, Code Execution exécute du Python généré dans un bac à sable.
- Govern — gouverner. Agent Registry catalogue agents, outils et serveurs MCP ; Agent Identity donne une identité propre à chaque agent ; Agent Gateway est le point d'application des règles sur les appels d'outils ; s'y ajoutent les politiques de protection du contenu et l'analyse de vulnérabilités.
- Optimize — évaluer et affiner. Service d'évaluation (autoraters multi-tours, évaluation en ligne sur le trafic réel), simulation de conversations, traçage unifié, optimisation automatique des instructions.
Le cycle ML classique reste au cœur de la plateforme : datasets gérés, Managed Training (jobs d'entraînement sur infrastructure gérée, PyTorch, TensorFlow, scikit-learn, XGBoost, entraînement distribué et réglage d'hyperparamètres), Model Registry qui versionne les modèles, endpoints pour l'inférence en ligne et batch inference pour l'inférence asynchrone, Pipelines pour enchaîner les étapes, Feature Store, Model Monitoring, notebooks Colab Enterprise et Workbench.
La facturation suit les ressources consommées : temps de calcul des jobs d'entraînement, nœuds d'un endpoint tant que le modèle y est déployé, jetons pour les modèles gérés appelés à l'API.
Un modèle déployé sur un endpoint est facturé à l'heure de nœud, même sans trafic : ce sont des machines réservées. Retirer le modèle (undeploy) arrête la facturation ; retirer les modèles des endpoints de test fait partie du ménage de fin de projet.
À quoi ça sert
- Entraîner, versionner et servir des modèles maison, avec une chaîne MLOps reproductible (pipelines, registre, évaluation, surveillance).
- Appeler les modèles Gemini et les autres modèles du catalogue depuis une application, sans gérer de serveur d'inférence.
- Construire des agents : outillage (ADK, Agent Studio), exécution (Agent Runtime, sessions, mémoire), gouvernance (identité, passerelle) et évaluation.
- Brancher des données privées sur un modèle en RAG, via RAG Engine, Vector Search ou Agent Search.
À éviter quand les données sont déjà dans un entrepôt et que le besoin s'exprime en SQL : BigQuery ML entraîne et appelle les modèles sans sortir de l'entrepôt (voir BigQuery). Pour servir un modèle ouvert à coût maîtrisé sur une infrastructure que l'on administre déjà, un déploiement vLLM sur GKE revient souvent moins cher qu'un endpoint géré. Pour donner un assistant clé en main aux salariés, sans développement, préférer Gemini Enterprise app.
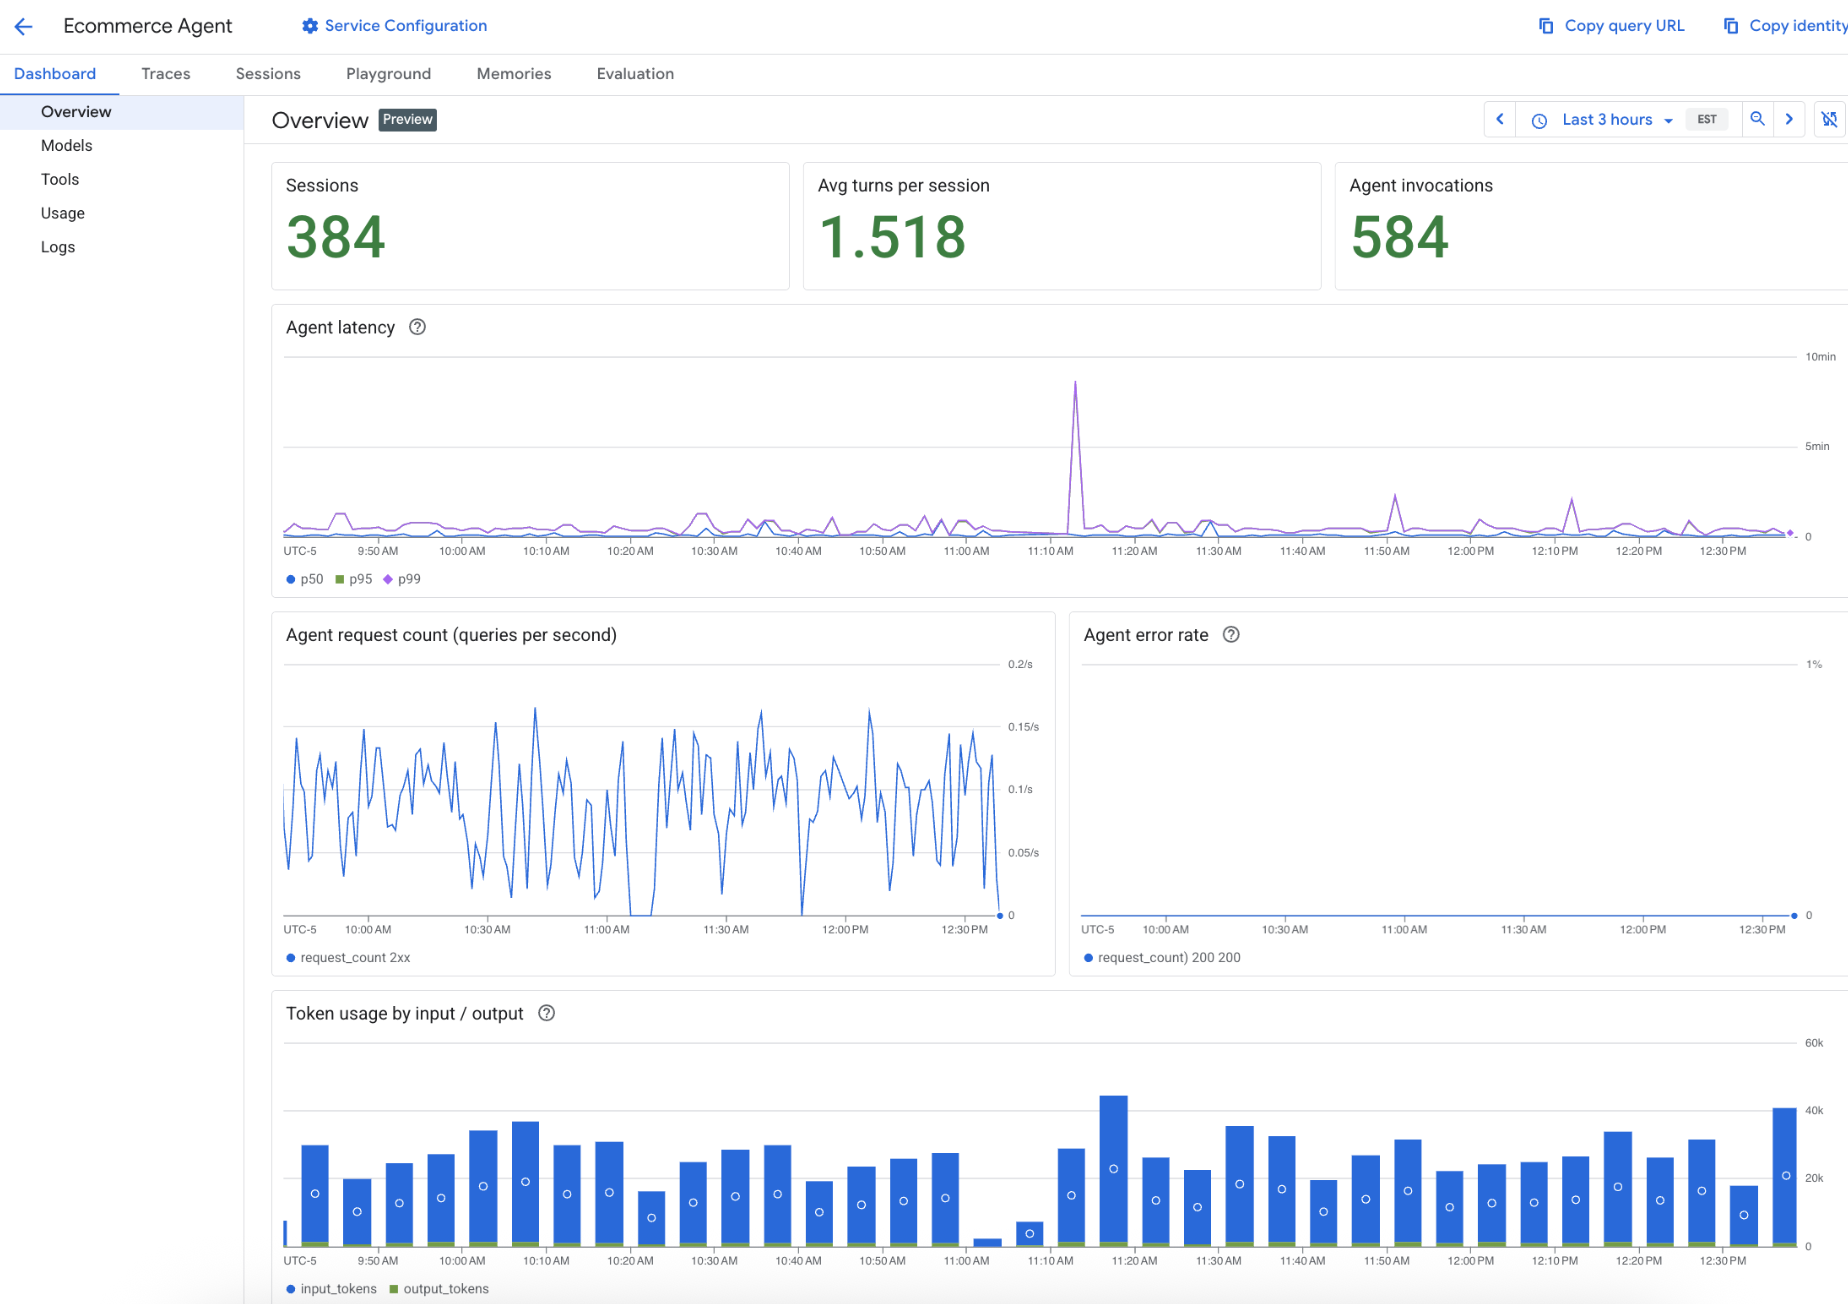
Dans la console
Alternatives en logiciel libre
- Kubeflow : la pile ML sur Kubernetes — Kubeflow Pipelines répond aux pipelines, Katib au réglage d'hyperparamètres, KServe au service des modèles.
- MLflow : suivi des expériences, registre de modèles et packaging ; l'équivalent d'Experiments et de Model Registry.
- Ray (Ray Train, Ray Serve, Ray Tune) : entraînement distribué et service de modèles, la brique la plus proche de Managed Training.
- KServe, BentoML : serveurs d'inférence sur Kubernetes, pour l'équivalent d'un endpoint.
- vLLM : moteur de service pour les grands modèles de langage, avec continuous batching et paged attention ; Ollama pour le même usage sur un poste ou un petit serveur.
- LangChain, LlamaIndex, Haystack : cadres d'orchestration d'agents et de RAG, face à ADK et RAG Engine.
- Feast : feature store open source.