Error Reporting
- L'exception non gérée d'un service managé part sur stderr avec sa trace de pile et devient une entrée de journal.
- Une application qui écrit du JSON place sa trace dans le champ stack_trace, exception ou message, avec la gravité ERROR.
- Error Reporting relit en continu les entrées qui portent une trace de pile et les regroupe par cause plutôt que par occurrence.
- Une bibliothèque cliente peut aussi appeler l'API directement, sans passer par les journaux, quand l'erreur est rattrapée dans le code.
- Un groupe qui apparaît, ou qui repart après avoir été marqué résolu, notifie les canaux Cloud Monitoring déclarés.
Ce que c'est
Agrégateur d'erreurs applicatives de Google Cloud Observability, le nom d'ensemble qui réunit Cloud Monitoring, Cloud Logging, Cloud Trace, Error Reporting, Cloud Profiler et Managed Service for Prometheus. Il lit en continu les journaux, repère les exceptions et les rassemble en groupes d'erreurs : une ligne par cause, pas une ligne par occurrence.
- Regroupement. La clé est la portion significative de la trace de pile, normalisée pour absorber les variations (numéros de ligne voisins, adresses, identifiants). Un groupe porte son premier et son dernier exemplaire, son nombre d'occurrences dans le temps, les versions et les ressources touchées.
- Deux voies d'entrée. Le plus souvent, rien à faire : toute entrée de journal de gravité
ERRORcontenant une trace de pile est reprise. Pour un message texte sans trace, on force le traitement en posant@typeàtype.googleapis.com/google.devtools.clouderrorreporting.v1beta1.ReportedErrorEvent. L'autre voie est l'appel explicite de l'API Error Reporting depuis une bibliothèque cliente, utile quand l'exception est rattrapée et ne remonte pas aux journaux. - Champs utiles. Dans une charge utile JSON, la trace se place dans
stack_trace,exceptionoumessage— évalués dans cet ordre.serviceContext.serviceetserviceContext.versionséparent les environnements et les versions ; à défaut de trace de pile,context.reportLocation(fichier, ligne, fonction) tient lieu de localisation. - Couverture. Go, Java, Node.js, PHP, Python, Ruby et .NET, sur App Engine standard et flexible, les fonctions Cloud Run, Cloud Run, Compute Engine, GKE et Apps Script. Pour les applications mobiles Android et iOS, Google renvoie vers Firebase Crashlytics.
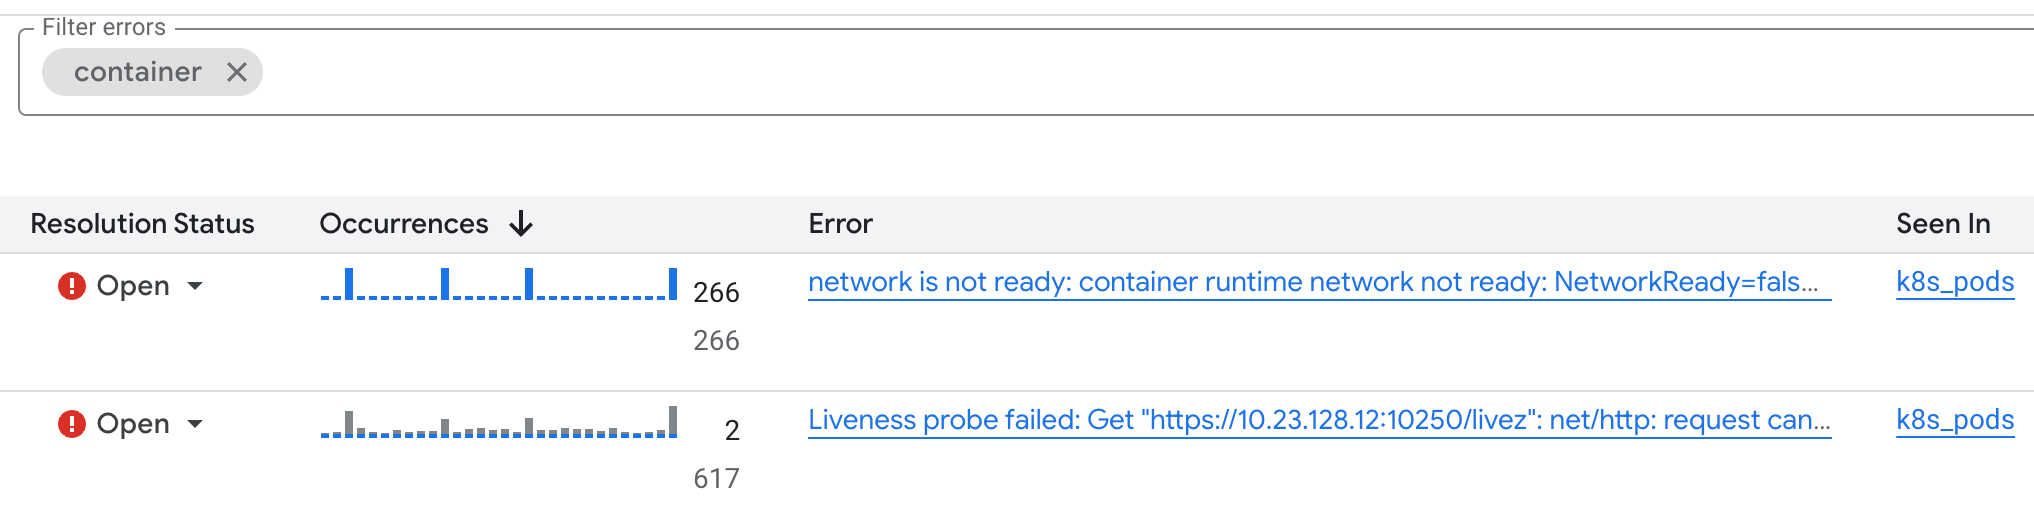
- Cycle de vie. Un groupe est ouvert, résolu ou mis en sourdine. Un exemplaire qui survient dans un groupe résolu le rouvre automatiquement — c'est ce qui signale une régression.
- Notifications par les canaux de notification de Cloud Monitoring : e-mail, application mobile de la console, Slack, webhook. Elles portent sur l'apparition d'un groupe, pas sur un seuil.
- Facturation. Error Reporting n'est pas facturé ; seule l'ingestion des journaux correspondants l'est, côté Cloud Logging.
Renseigner
serviceContext.versionavec la version déployée transforme la liste des groupes en tableau de bord de livraison : une erreur qui n'apparaît que sur la dernière version se voit immédiatement, et le marquage « résolu » devient un vrai suivi.
À quoi ça sert
- Voir d'un coup d'œil les erreurs nouvelles après une mise en production, au lieu de fouiller les journaux.
- Hiérarchiser les corrections par nombre d'occurrences et par nombre de ressources touchées, plutôt que par ordre d'arrivée.
- Détecter une régression : un groupe marqué résolu qui se rouvre tout seul.
- Alerter l'astreinte à la première apparition d'une erreur, sans attendre qu'un seuil de taux d'erreur soit franchi.
- Relier une erreur à son contexte : entrée de journal d'origine, trace distribuée, version du service.
À éviter comme outil de suivi de taux d'erreur : Error Reporting compte des occurrences, il ne calcule pas de ratio ni de SLO. Une alerte sur « plus de 1 % de réponses 5xx » se construit dans Cloud Monitoring. À éviter aussi pour les erreurs côté client d'une application web ou mobile : ni les exceptions JavaScript du navigateur, ni les plantages Android et iOS n'y arrivent — Crashlytics ou un collecteur dédié couvre ce terrain. Enfin, ce n'est pas un outil de gestion de tickets : l'état d'un groupe se limite à ouvert, résolu ou en sourdine, sans assignation ni commentaire.
Dans la console
Alternatives en logiciel libre
- GlitchTip (MIT) : suivi d'erreurs compatible avec les SDK Sentry, regroupement par trace de pile, états de résolution et notifications — l'équivalent libre le plus direct. Sentry lui-même est publié sous licence FSL, qui n'est pas une licence libre.
- Errbit (MIT) : collecteur d'erreurs compatible avec le protocole Airbrake, avec regroupement, notifications et suivi de résolution.
- OpenTelemetry (Apache 2.0) : les exceptions enregistrées comme événements de span, exploitables ensuite dans n'importe quel backend de traces.
- Loki (AGPL v3) ou OpenSearch (Apache 2.0) avec des règles d'extraction : approche par les journaux, sans regroupement automatique mais sans instrumentation supplémentaire.
- Prometheus (Apache 2.0) et Alertmanager (Apache 2.0) : compteurs d'exceptions exposés par l'application, pour la partie alerte sur volume d'erreurs.