Document AI
- Dépôt des factures PDF dans un bucket
- Une table d'objets BigQuery référence les fichiers du bucket et leurs métadonnées
- ML.PROCESS_DOCUMENT appelle le processeur par un modèle distant déclaré en SQL
- Les entités extraites reviennent en colonnes typées, jointes aux tables existantes
- Requêtes SQL sur les montants, les dates et les fournisseurs
Ce que c'est
Plateforme d'extraction de données documentaires. On crée un processeur dans un projet et une région, puis on lui envoie des documents ; il renvoie un objet Document normalisé : texte, mise en page (pages, blocs, paragraphes, lignes, jetons, tableaux), entités typées et coordonnées de chaque élément.
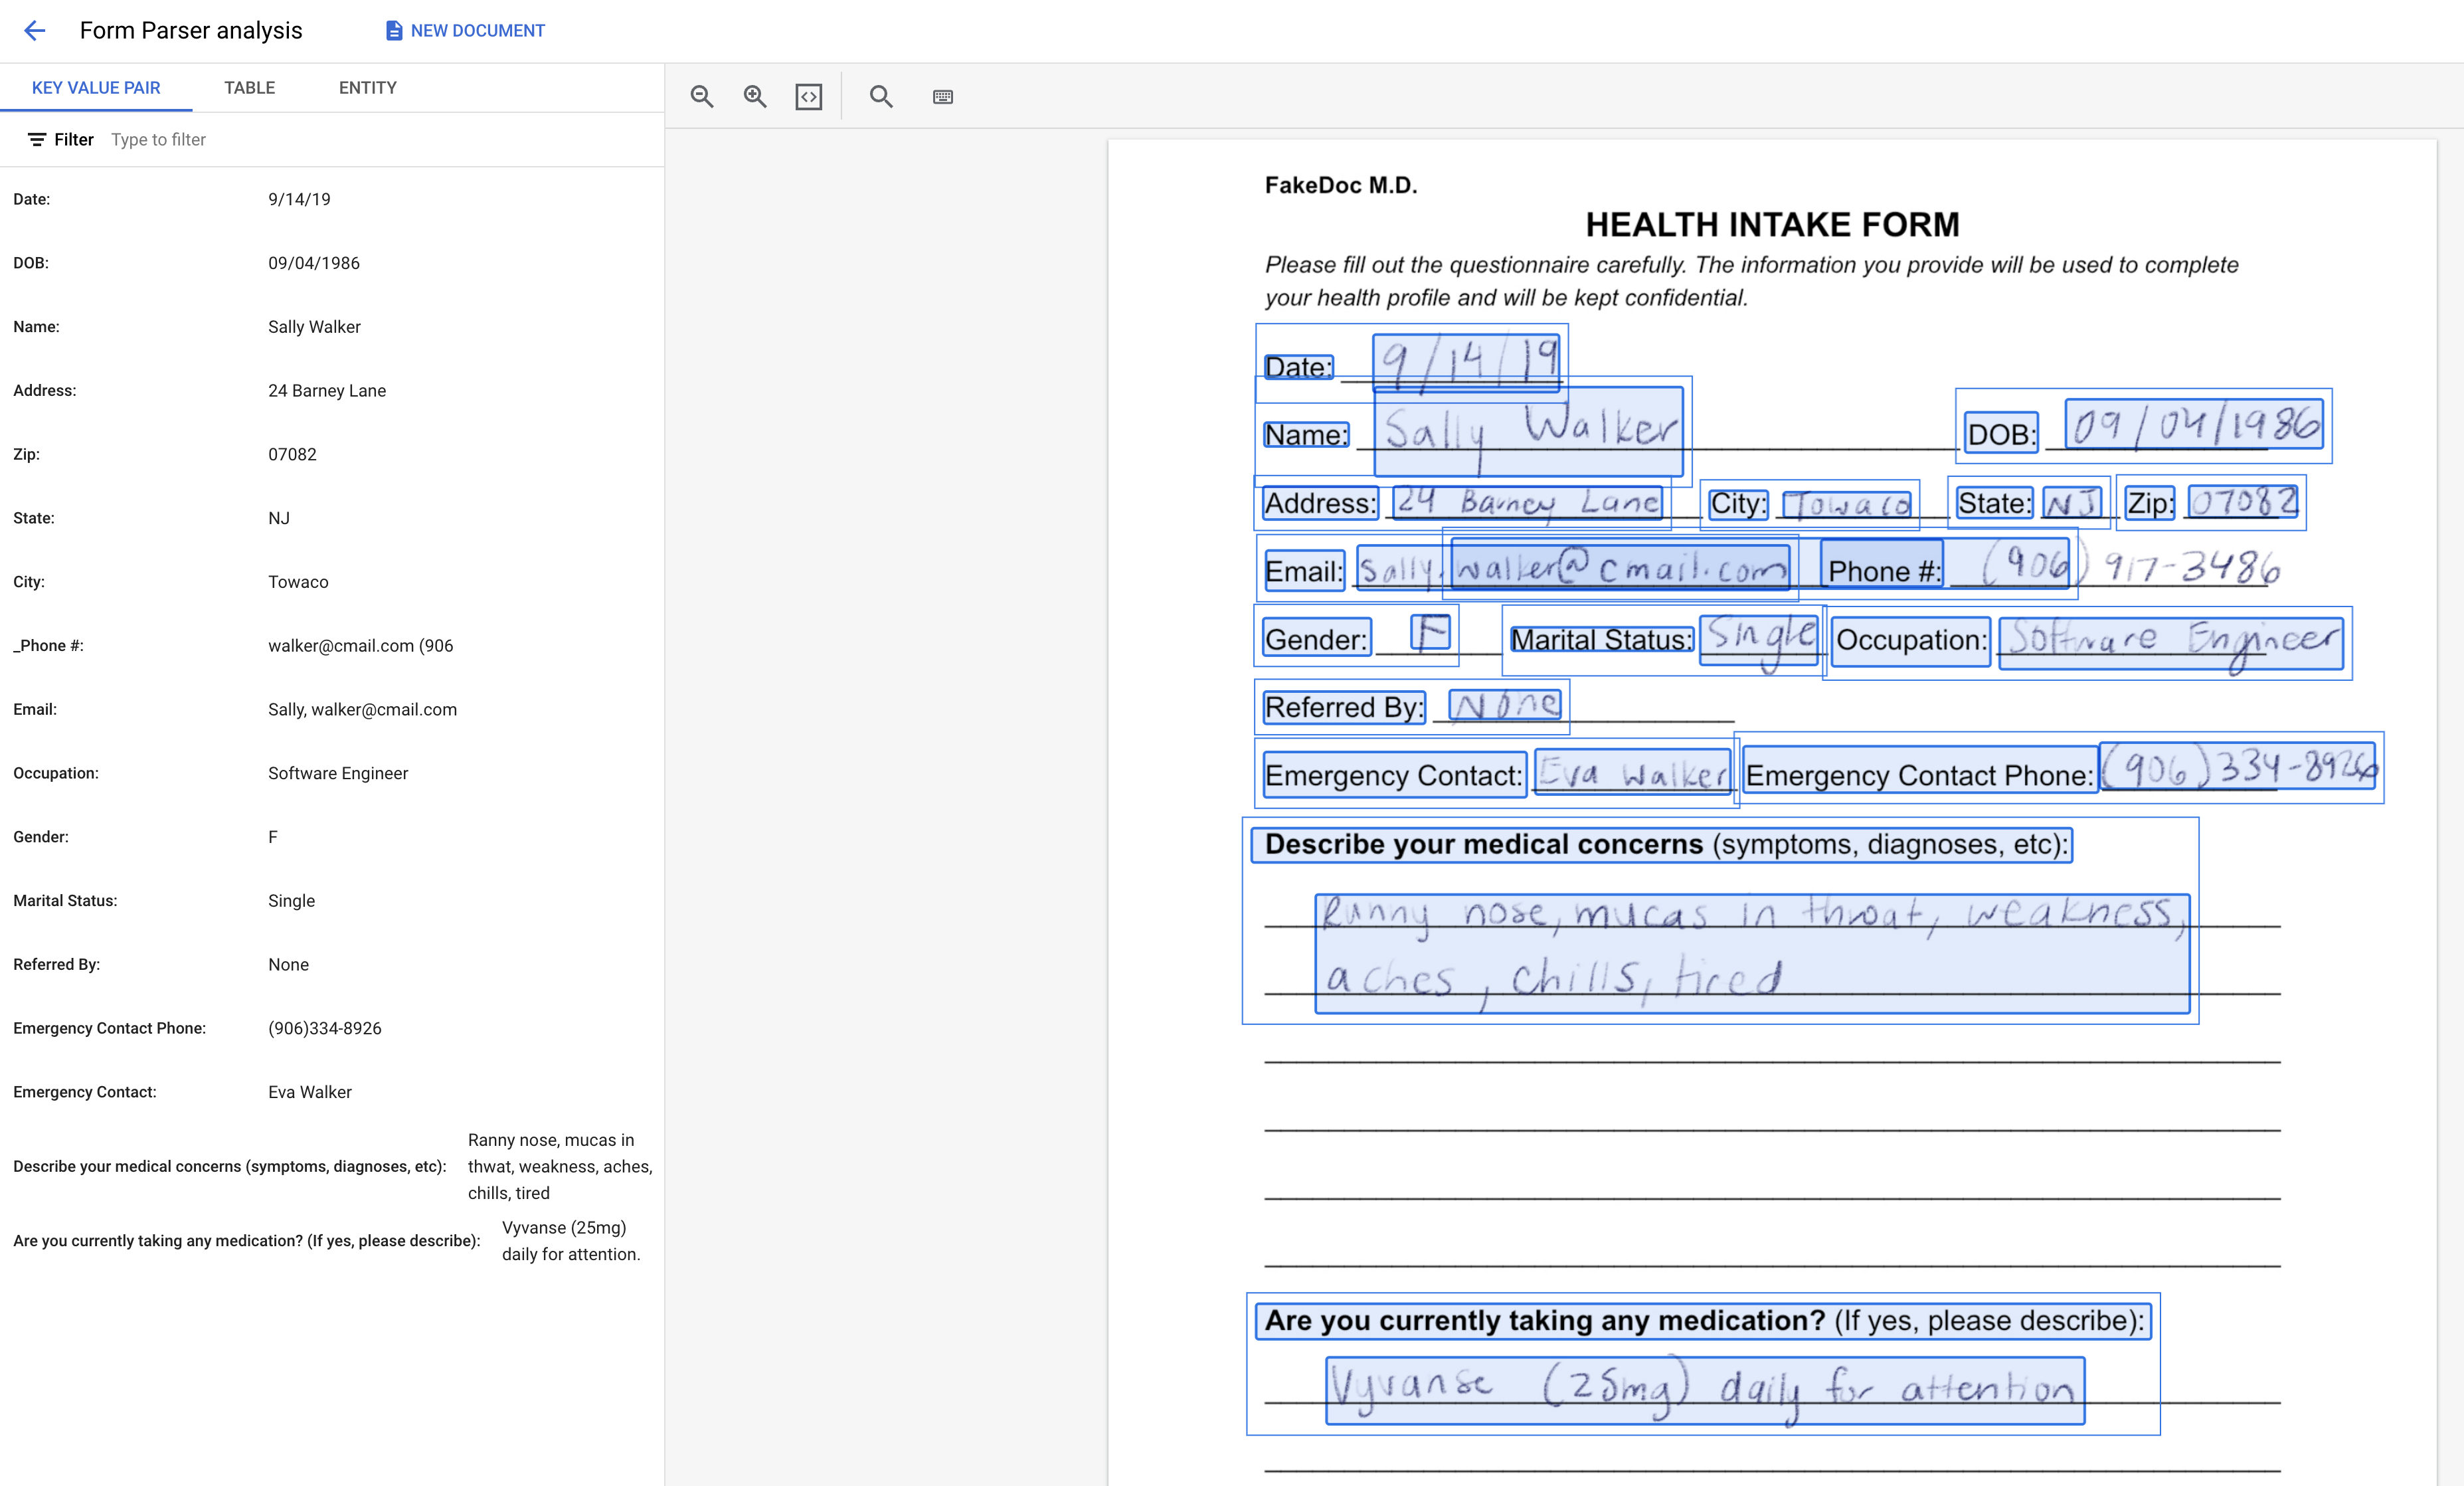
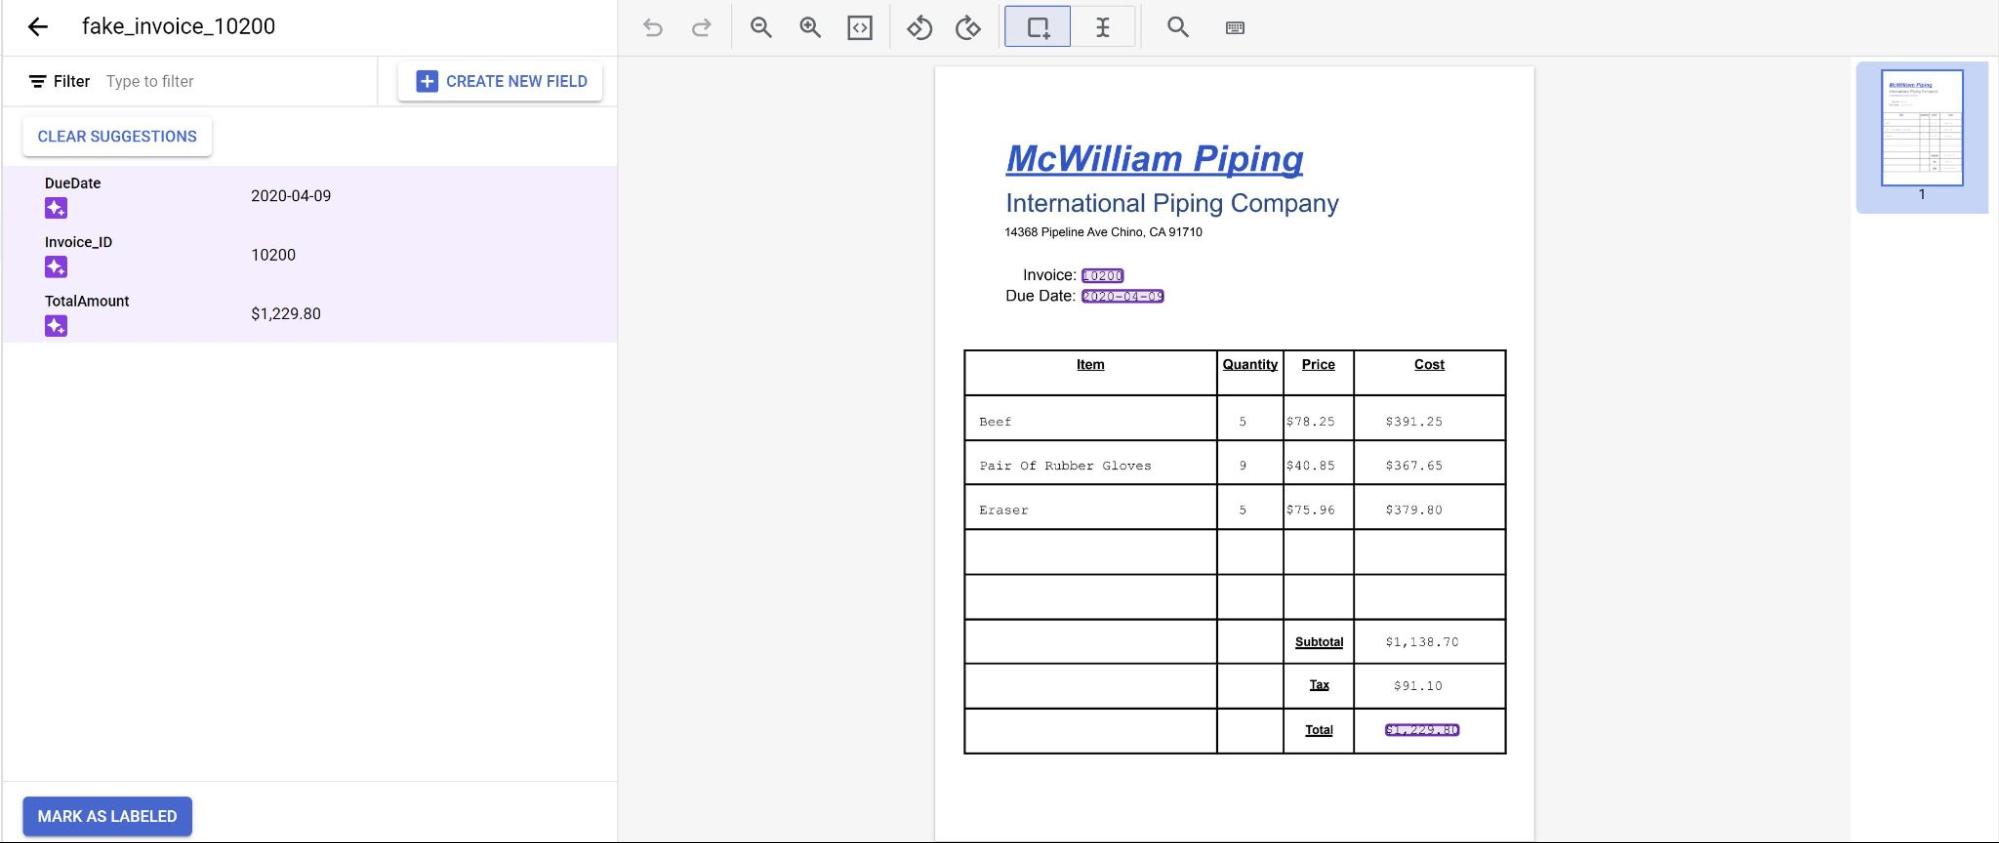
- Familles de processeurs. Numériser : Enterprise Document OCR, plus de 200 langues, manuscrit compris, avec évaluation de la qualité du scan. Structurer : Form Parser (paires clé/valeur et tableaux), Layout Parser (découpage en fragments pour du RAG). Extraire : Custom Extractor, bâti sur Gemini, avec un schéma de document défini par l'utilisateur et affinable sur des exemples annotés. Classer : Custom Classifier et Custom Splitter, pour trier et découper un lot hétérogène. Prêts à l'emploi : facture, note de frais, bulletin de paie, relevé bancaire, formulaire W2, pièces d'identité.
- Deux modes d'appel.
processen synchrone : un fichier de 40 Mo au plus (20 Mo pour le Layout Parser), 15 pages pour la plupart des processeurs, 30 en mode sans image.batchProcessen opération longue : jusqu'à 5 000 fichiers et 1 Go par requête, lus dans Cloud Storage et écrits dans un bucket de sortie ; le plafond de pages dépend du processeur (500 pour l'OCR et le Layout Parser, 200 pour l'Invoice Parser et le Custom Extractor). Les lots aboutissent en général en 12 à 24 heures et sont annulés au-delà de 24 heures. - Entrées : PDF, TIFF, GIF, JPEG, PNG, BMP, WebP, et HTML, DOCX, PPTX, XLSX pour le Layout Parser. Les scans doivent être à 200 dpi au minimum, 300 dpi de préférence.
- Intégration SQL : un modèle distant BigQuery déclaré avec
remote_service_type = 'CLOUD_AI_DOCUMENT_V1'rend le processeur appelable depuisML.PROCESS_DOCUMENTsur une table d'objets. - Capacité : les processeurs génératifs sont servis sur un palier provisioned garanti et un palier best effort sans engagement de service ; la capacité réservée s'achète à l'heure.
- Facturation à la page traitée, selon le processeur : 1,50 $ les 1 000 pages pour l'OCR (1 000 pages gratuites par mois), 30 $ les 1 000 pages pour le Custom Extractor et le Form Parser, 10 $ pour le Layout Parser, 5 $ pour les classifieurs. Les processeurs spécialisés se facturent au document, par tranches de 10 pages : 0,10 $ pour une facture ou une note de frais. Un processeur personnalisé déployé coûte en plus 0,05 $ l'heure d'hébergement.
Un processeur personnalisé déployé est facturé même sans trafic — environ 438 $ par an et par version. Annuler le déploiement des versions qui ne servent plus.
À quoi ça sert
- Automatiser une chaîne comptable : factures fournisseurs, notes de frais, relevés, rapprochement avec l'ERP.
- Instruire des dossiers : prêts, assurances, ressources humaines, avec vérification de pièces d'identité.
- Numériser et rendre cherchable un fonds d'archives papier.
- Préparer un corpus pour du RAG : le Layout Parser découpe en fragments qui respectent la structure du document.
- Extraire des champs en SQL depuis BigQuery, sans pipeline dédié.
À éviter pour du texte dans une photo de scène, une enseigne ou une capture d'écran : Vision AI est prévu pour cela et coûte moins cher. À éviter aussi pour quelques dizaines de documents aux champs simples, ou pour une extraction dont le schéma change souvent : un appel direct à un modèle Gemini avec un PDF et un schéma JSON donne le même résultat sans processeur à créer ni à déployer. Document AI reste préférable quand il faut les coordonnées de chaque champ dans la page (surlignage, contrôle humain, piste d'audit), une mise en page fidèle avec tableaux et cases à cocher, un lot de plusieurs milliers de fichiers en une requête, un tarif à la page, la résidence des données en Union européenne, ou un processeur prêt à l'emploi sur un document normalisé.
Dans la console
Alternatives en logiciel libre
- OCRmyPDF (MPL 2.0) sur Tesseract (Apache 2.0) : couche de texte ajoutée à un PDF scanné, la brique de numérisation.
- PaddleOCR avec PP-Structure (Apache 2.0) : OCR, analyse de mise en page et reconnaissance de tableaux ; le plus proche du Form Parser.
- Docling (MIT) et unstructured (Apache 2.0) : conversion de PDF, DOCX et HTML en documents structurés et en fragments pour du RAG, à la place du Layout Parser.
- LayoutParser (Apache 2.0) : détection des régions d'une page par modèles de vision, avec des modèles préentraînés sur des corpus documentaires.
- Donut (MIT) : extraction de champs de bout en bout, sans OCR préalable, à affiner sur ses propres documents.
- Label Studio (Apache 2.0) : annotation des documents d'entraînement, à la place de l'atelier d'annotation intégré.