Dataflow
- Le DAG lance le job à partir d'un modèle et attend la fin de son exécution
- Job par lots : lecture des fichiers, et dépôt du code et des dépendances du pipeline dans un bucket de préparation
- Job en continu : lecture de l'abonnement Pub/Sub, les messages sont acquittés une fois traités
- Écriture des résultats dans BigQuery par la Storage Write API
- Écriture des agrégats calculés par fenêtre, pour une lecture par clé à faible latence
Ce que c'est
Service d'exécution de pipelines Apache Beam, entièrement géré, qui traite les données par lots et en continu avec le même modèle de programmation.
- Rôle du service. Le pipeline est écrit avec un SDK Beam (Java, Python, Go) ; le runner Dataflow envoie le code et ses dépendances dans un bucket Cloud Storage, crée un job, puis alloue un pool de VM de travail (workers) et les supprime à la fin. Aucune instance n'est à provisionner.
- Parallélisme et élasticité : autoscaling horizontal du nombre de workers selon le volume entrant, et rééquilibrage dynamique du travail entre workers pour éviter qu'une partition lente ne retienne tout le job.
- Autoscaling vertical (Dataflow Prime) : le service détecte les workers à court ou en excès de mémoire et les remplace par des workers mieux dotés. Seule la mémoire varie, entre 6 et 16 Gio par worker par défaut, bornes modifiables par resource hint. Actif par défaut sur les jobs en continu Prime ; en batch, il s'active par option, n'agrandit qu'après quatre erreurs de mémoire insuffisante (out of memory) et ne réduit jamais. L'autoscaling horizontal est suspendu pendant l'opération et jusqu'à dix minutes après. Il n'est pas disponible dans un périmètre VPC Service Controls.
- Streaming Engine : pour les pipelines en continu, le brassage (shuffle) et la gestion de l'état sortent des VM et passent dans le service. Les workers consomment moins de vCPU, de mémoire et de disque, et l'autoscaling réagit plus finement. Activé par défaut pour les SDK Python et Go récents.
- Garanties : traitement exactement une fois par défaut ; un mode at-least-once réduit le coût et la latence pour les pipelines qui tolèrent les doublons.
- Zones et instantanés : avec Streaming Engine ou Dataflow Shuffle, les workers se répartissent sur toutes les zones de la région et sont recréés ailleurs si une zone tombe ; certaines ressources internes du job restent zonales, et le job peut alors échouer. Un instantané (snapshot) d'un job en continu sauvegarde l'état du pipeline (fenêtres ouvertes, agrégats), avec en option un instantané Pub/Sub de l'abonnement source (
gcloud dataflow snapshots create --snapshot-sources=true). Un nouveau job lancé avec--create_from_snapshotreprend cet état et relit Pub/Sub à partir de l'instantané : c'est la reprise après une panne de zone quand la logique dépend des données déjà traitées (longues fenêtres glissantes, compteurs en fenêtre globale). Le nouveau job tourne dans la région de l'instantané, sur Streaming Engine, et passe le même contrôle de compatibilité qu'une mise à jour. L'instantané Dataflow expire après 7 jours par défaut (30 au plus), celui de Pub/Sub au plus tard 7 jours après sa création, moins l'âge du plus vieux message non acquitté ; le job est en pause pendant la prise. Voir Streaming pour drainer, annuler ou mettre à jour un job. - Façons de lancer un pipeline : code Beam, modèles (Flex, ou classiques déconseillé que la documentation écarte pour un nouveau modèle) qui paramètrent un pipeline déjà compilé, bibliothèque de modèles fournis par Google (Pub/Sub → BigQuery, Cloud Storage → BigQuery, capture de changements...), ou notebooks JupyterLab pour développer pas à pas.
- Facturation : à la seconde, sur les ressources du job — vCPU et mémoire des workers, disque persistant, GPU éventuels — plus le volume brassé par Dataflow Shuffle en batch et les unités de calcul Streaming Engine en continu. FlexRS remise d'environ 40 % le vCPU et la mémoire des jobs par lots, en échange d'un démarrage différé dans une fenêtre de six heures.
À quoi ça sert
- Pipelines de streaming : lecture de Pub/Sub, fenêtrage, agrégats, enrichissement, écriture dans BigQuery ou Bigtable.
- ETL par lots avec des transformations qui ne s'expriment pas bien en SQL : formats exotiques, dédoublonnage complexe, appels à des services externes.
- Réplication et mouvement de données entre systèmes, souvent par un modèle fourni sans écrire une ligne de code.
- Inférence de modèles de machine learning au fil de l'eau sur un flux.
À éviter pour un simple transfert d'un sujet vers une table sans transformation : l'abonnement BigQuery ou l'abonnement Cloud Storage de Pub/Sub fait la même chose sans job à exploiter. À éviter aussi quand les traitements sont déjà écrits en Spark (préférer Managed Service for Apache Spark), ou quand la transformation porte sur des données déjà dans BigQuery et s'écrit en SQL.
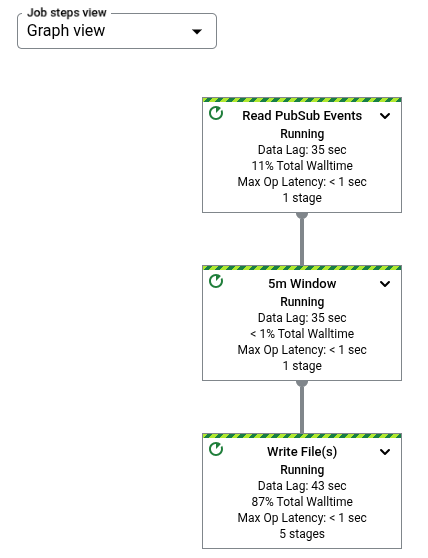
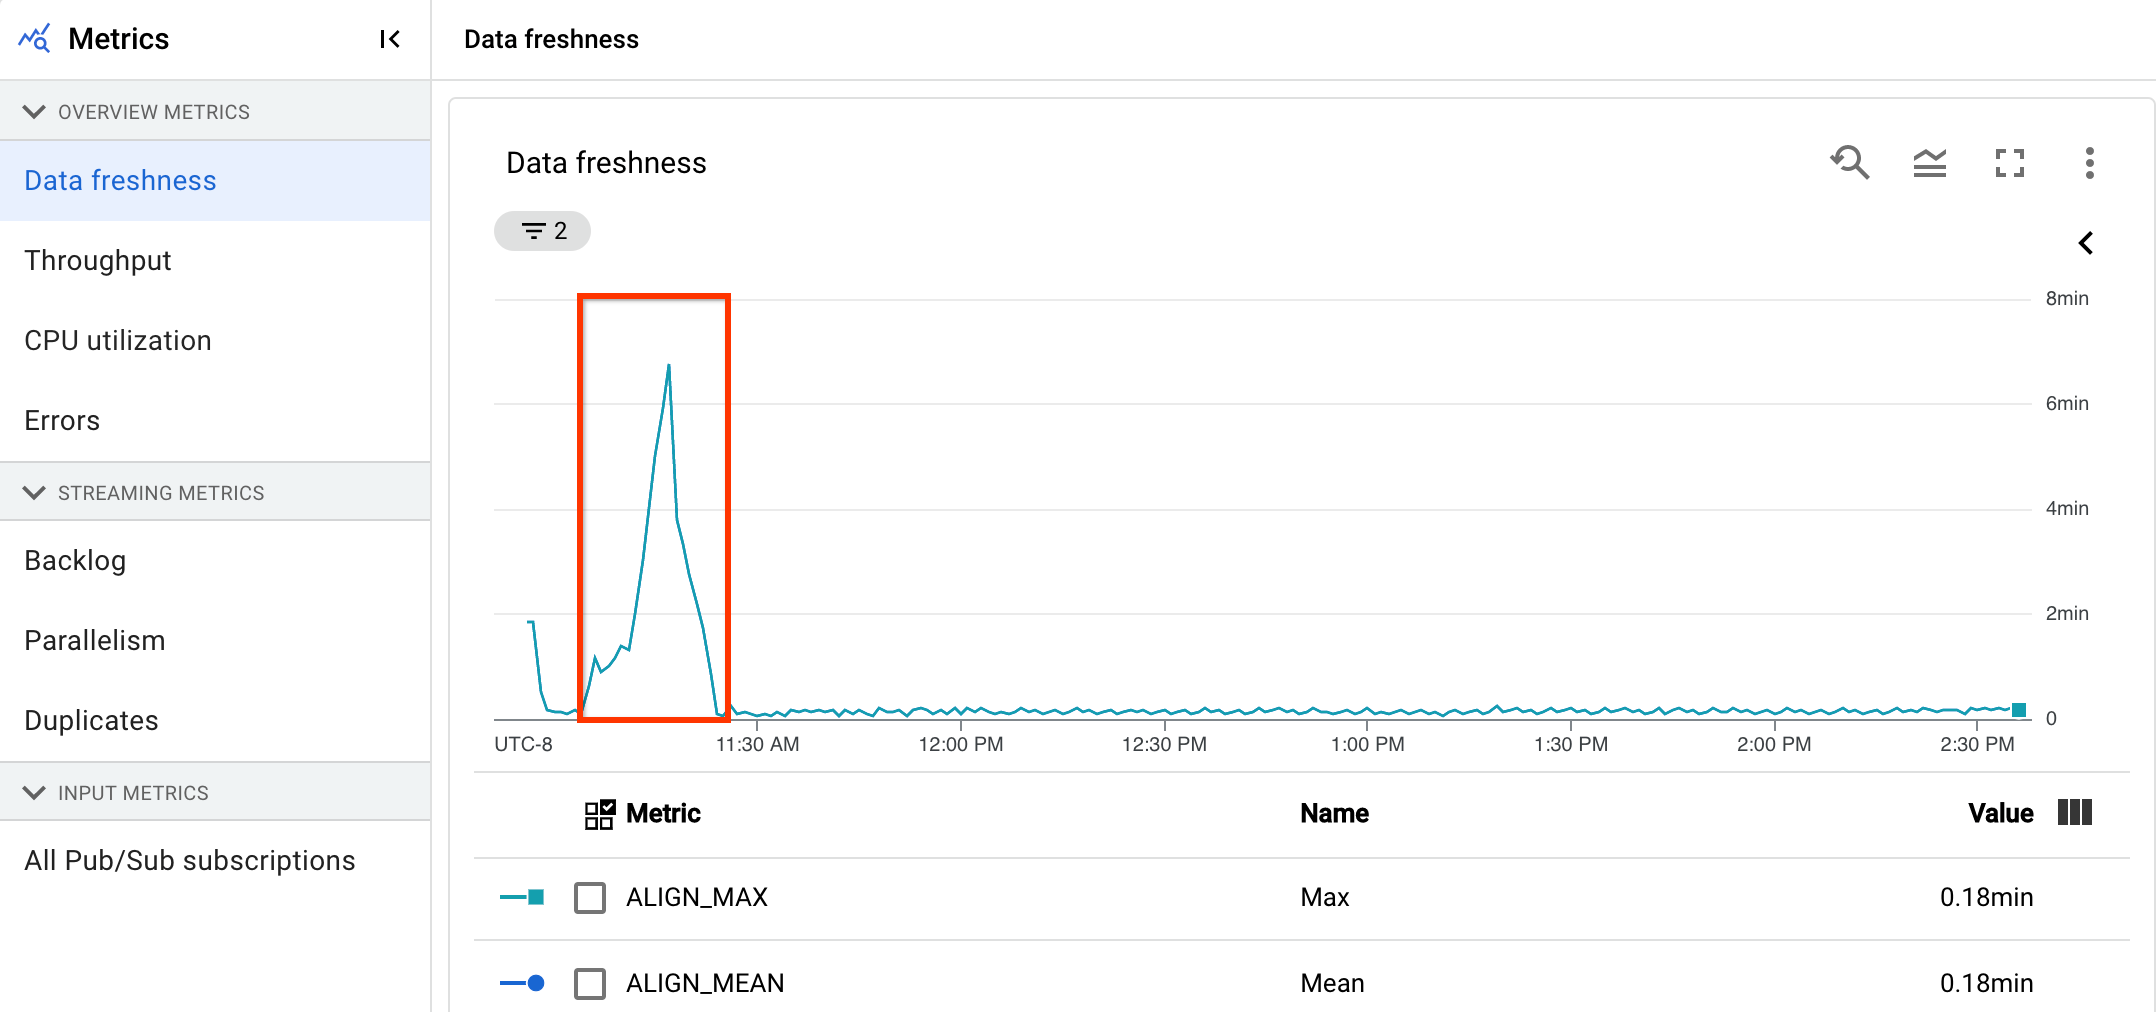
Un pipeline en continu se surveille d'abord par deux métriques : la fraîcheur des données (âge du plus vieil élément non encore traité) et le retard du système. Une fraîcheur qui croît linéairement signale que le débit du pipeline est inférieur au débit entrant.
Dans la console
Alternatives en logiciel libre
- Apache Beam lui-même : le pipeline ne change pas, seul le runner change — Flink, Spark ou le runner direct.
- Apache Flink : traitement de flux avec état, fenêtrage et points de reprise ; la référence pour le streaming autogéré.
- Apache Spark Structured Streaming : streaming par micro-lots, dans un écosystème Spark existant.
- Kafka Streams : bibliothèque de transformation de flux, quand tout transite déjà par Kafka.
- Apache NiFi : acheminement et transformation de données par flux configurés graphiquement, plutôt qu'en code.