Agents de données BigQuery
- L'analyste pose sa question dans l'onglet Agents de BigQuery ; l'agent choisit les sources à interroger
- Une application appelle le même agent par l'API Conversational Analytics, avec ou sans état de conversation
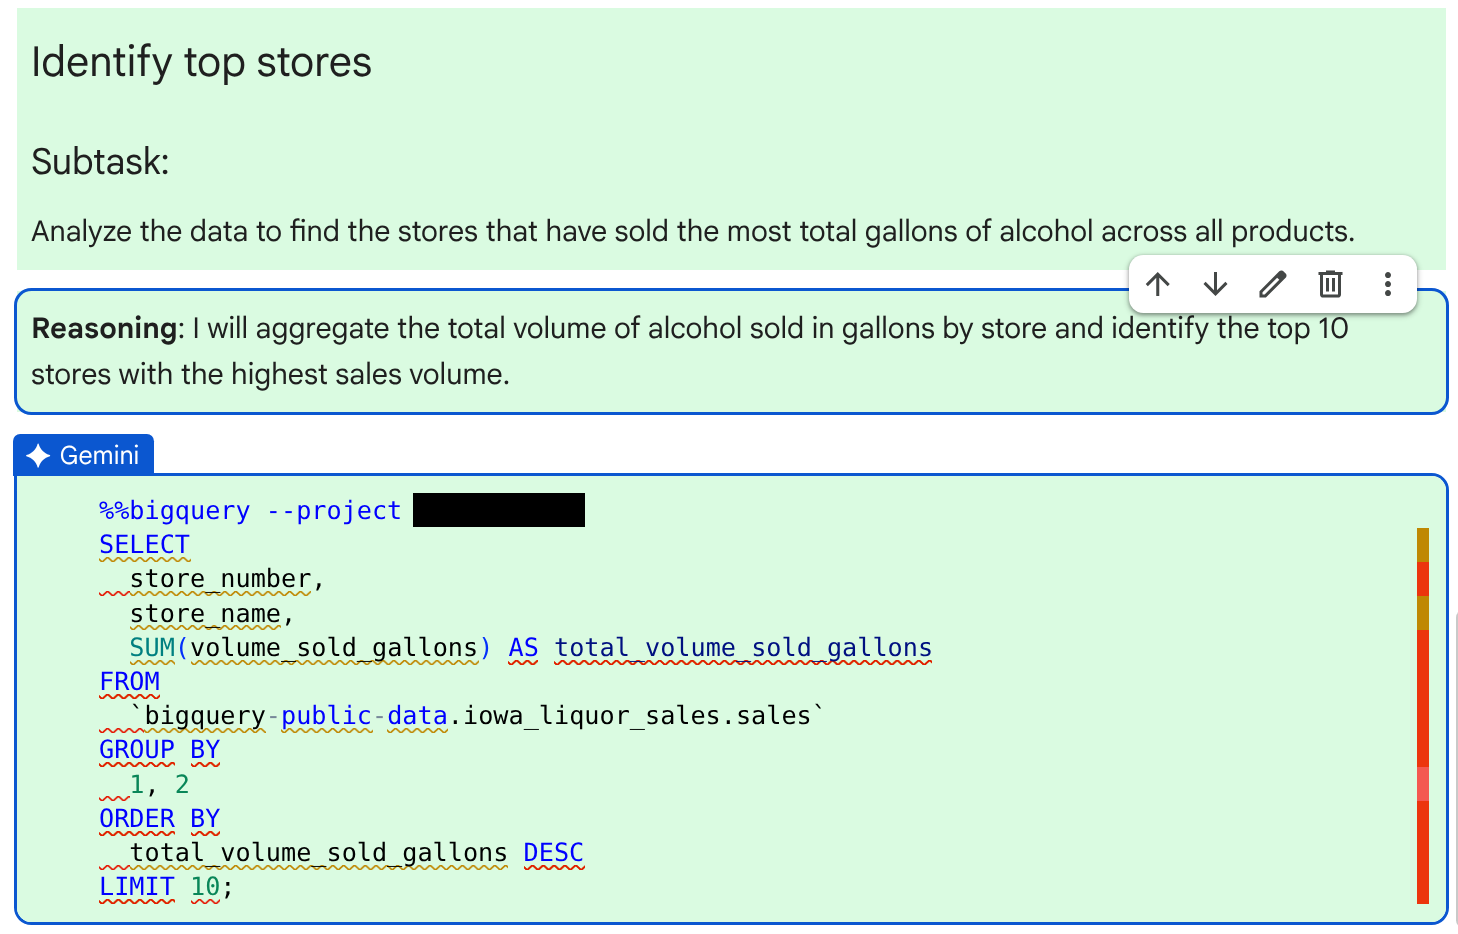
- L'agent génère puis exécute du GoogleSQL sur les sources de connaissances déclarées
- Les termes du glossaire métier aident l'agent à interpréter les mots de la question
- L'agent d'ingénierie des données écrit et corrige les fichiers SQLX du dépôt à partir de prompts
- Les pipelines produits alimentent les tables que les agents de données interrogent ensuite
Ce que c'est
Une famille d'agents assistés par Gemini intégrés à BigQuery, qui prennent une consigne en langage naturel et produisent du SQL, du Python ou du code de pipeline. Ils s'activent avec Gemini dans BigQuery, sur l'API geminidataanalytics.googleapis.com.
- Agent de données : l'objet central de l'analytique conversationnelle. Il est attaché à un ensemble de sources de connaissances — tables, vues, graphes de propriétés, fonctions définies par l'utilisateur — et porte son contexte : métadonnées de tables et de champs rédigées pour l'usage visé, consignes d'interprétation (synonymes, filtres et regroupements par défaut), requêtes vérifiées qui fixent la logique métier, termes de glossaire propres à l'agent ou importés de Knowledge Catalog. On les gère dans l'onglet Agent catalog de la page Agents de la console, et on peut les partager.
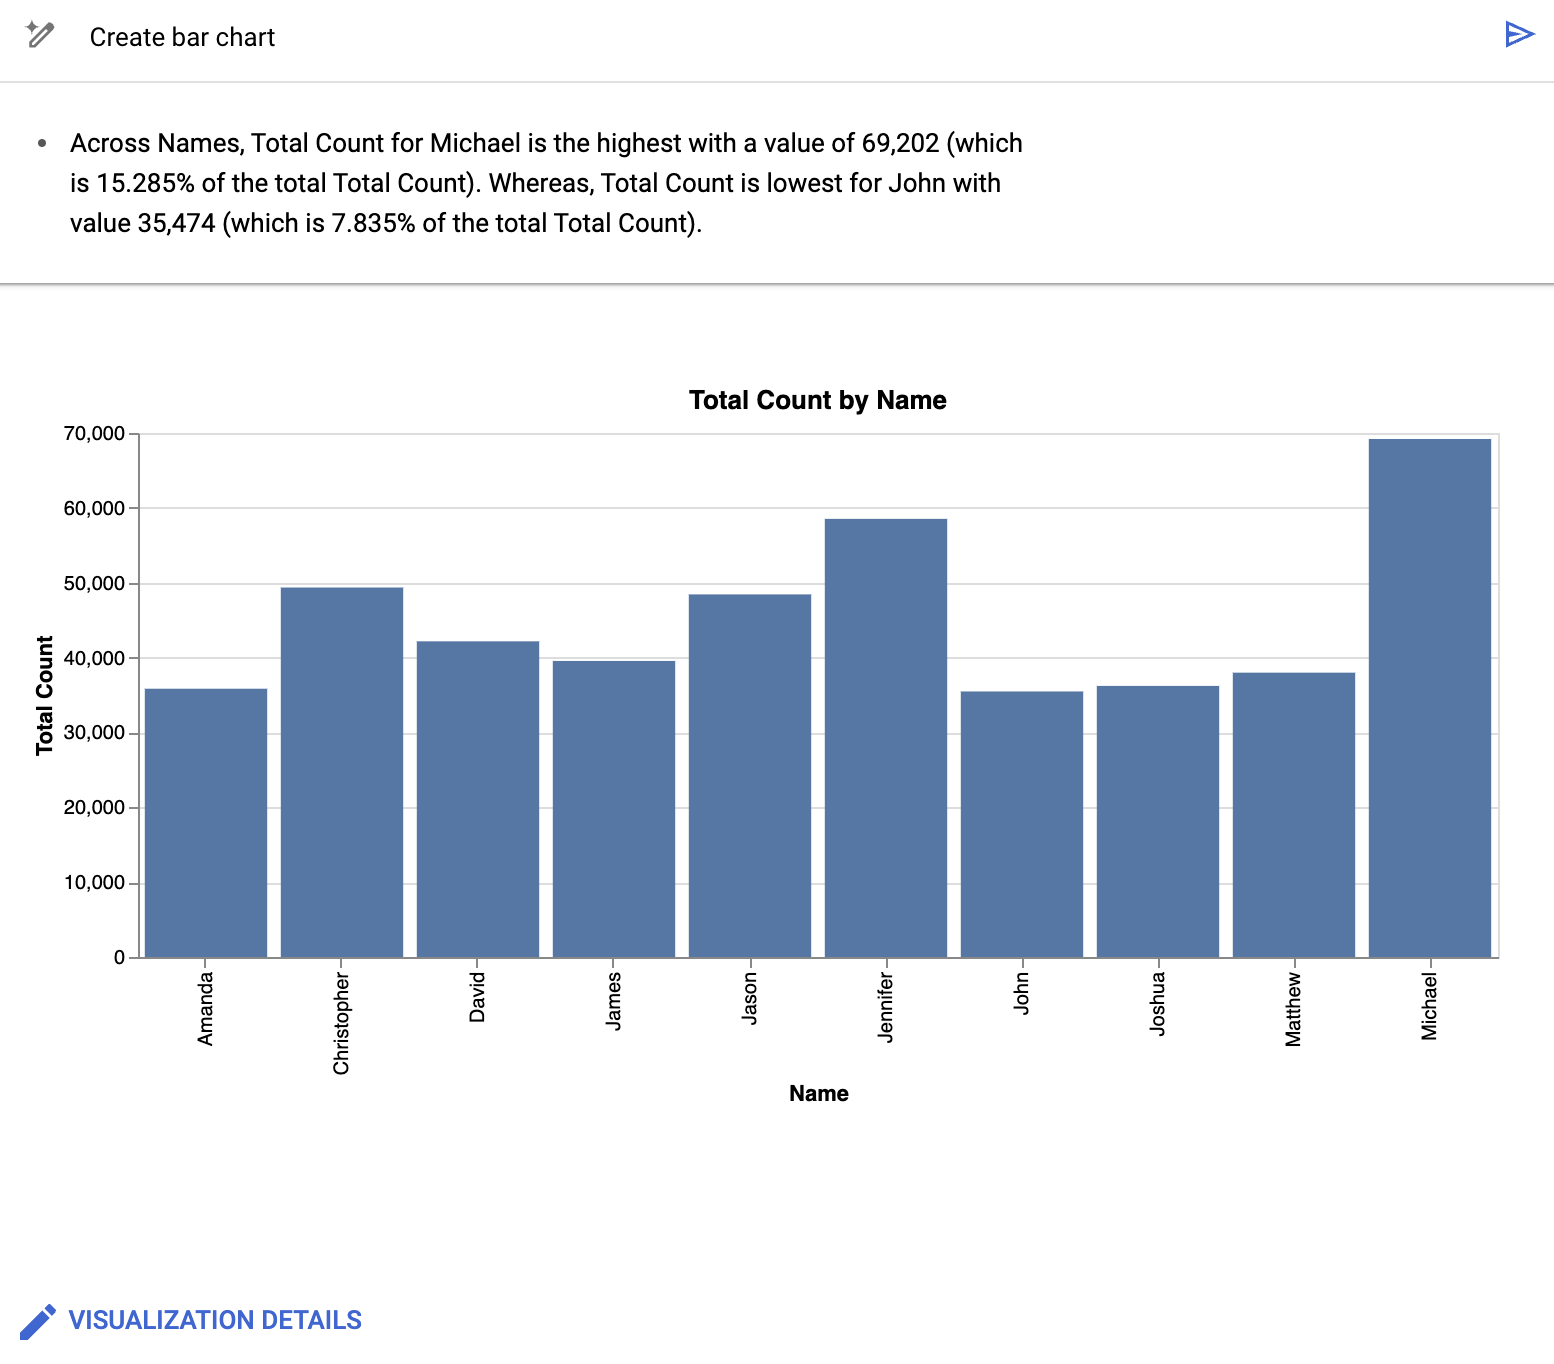
- Conversations : des échanges persistants avec un agent ou directement avec une source. La réponse mêle texte, code, graphiques générés et le raisonnement suivi ; elle peut appeler les fonctions d'IA de BigQuery (
AI.FORECAST,AI.GENERATE,AI.CLASSIFY,ML.DESCRIBE_DATA…). Une conversation directe avec une source, sans agent, se passe de ce contexte et répond moins précisément. - API Conversational Analytics : la même capacité exposée aux applications, en Python ou en HTTP, sur des sources BigQuery, Looker, Data Studio, AlloyDB, Spanner et Cloud SQL ; c'est la cible de migration de l'API Data QnA déconseillé , dépréciée.
- Data Engineering Agent : construit et modifie des pipelines de données à partir de prompts. Il écrit le code dans un dépôt Dataform, renseigne au passage les descriptions de champs et analyse la cause d'une exécution en échec. Il ne lance pas les pipelines : la revue et la planification restent manuelles.
- Data Science Agent : dans un notebook Colab Enterprise adossé à BigQuery, il enchaîne exploration, préparation et modélisation.
- Autres assistances : insights de données (questions et requêtes générées à partir des métadonnées d'une table ou d'un dataset, graphe de relations), data canvas (exploration en langage naturel sur un canevas), préparation de données (suggestions de transformations), génération et explication de SQL et de Python.
- Facturation : au titre de Gemini pour Google Cloud ; les requêtes déclenchées sont facturées par BigQuery comme n'importe quelle requête.
À quoi ça sert
- Ouvrir l'accès aux données à des métiers qui n'écrivent pas de SQL, sur un périmètre cadré par un agent et ses requêtes vérifiées.
- Démarrer une exploration sur un jeu de données inconnu : insights et data canvas donnent des questions et des requêtes de départ.
- Incorporer une interface de questions-réponses sur les données à une application maison, par l'API plutôt qu'en réimplémentant l'agent.
- Faire écrire la première version d'un pipeline Dataform, ou diagnostiquer une exécution en échec.
À éviter pour un chiffre qui engage : la réponse d'un agent est plausible, pas certifiée. Pour un indicateur officiel, passer par une requête relue et versionnée dans Dataform, exposée dans un tableau de bord. À éviter aussi sur un projet soumis à des exigences de conformité que Gemini pour Google Cloud ne couvre pas — elles sont plus étroites que celles de BigQuery seul.
Activer Gemini dans BigQuery donne au service l'accès aux données et à l'historique des requêtes du projet. Les contenus ne servent pas à entraîner les modèles, mais l'activation se décide au niveau du projet : la cloisonner revient à séparer les projets.
Les requêtes vérifiées sont le levier le plus efficace sur la justesse des réponses : quelques requêtes exactes valent mieux qu'une longue consigne en prose.
Dans la console
Alternatives en logiciel libre
- Vanna.ai (licence MIT) : génération de SQL à partir de questions, ancrée sur un index de schémas, de documentation et de requêtes exemples — le même principe que les requêtes vérifiées.
- DB-GPT : plateforme d'agents sur bases de données, avec génération de SQL, visualisations et connecteurs multiples.
- Cube : couche sémantique ouverte qui définit mesures et dimensions une fois pour toutes ; le socle à mettre sous un agent pour qu'il ne réinvente pas les définitions.
- LangChain et LlamaIndex avec leurs outils SQL : les briques pour construire soi-même un agent sur un entrepôt.
- Jupyter AI : assistance conversationnelle dans un notebook, l'équivalent libre du Data Science Agent.
- OpenMetadata ou DataHub pour le contexte métier, en amont de l'agent.