Cloud Trace
- La requête entre dans le service de tête, dont le SDK OpenTelemetry ouvre le span racine et fabrique le contexte de trace.
- L'appel aval transporte l'en-tête traceparent : le service appelé rattache ses propres spans à la même trace.
- Les spans terminés partent en OTLP vers le collecteur, qui échantillonne, enrichit avec les attributs de ressource et met en lot.
- Le service aval exporte vers le même collecteur ; l'identifiant de trace suffit à recoller les deux moitiés de l'appel.
- Le collecteur écrit par l'API Telemetry ; les spans atterrissent dans le bucket d'observabilité _Trace du projet.
- Le champ de trace porté par chaque entrée de journal fait le lien entre un span lent et les messages émis pendant son exécution.
Ce que c'est
Service de traçage distribué de Google Cloud Observability, le nom d'ensemble qui réunit Cloud Monitoring, Cloud Logging, Trace, Error Reporting, Cloud Profiler et Managed Service for Prometheus. Il reçoit les spans produits par les applications, les rassemble en traces et donne à voir le chemin complet d'une requête à travers les services.
- Modèle. Une trace est un arbre de spans. Chaque span porte un nom, un début, une fin, un span parent et des attributs (jusqu'à 1 024) : code HTTP, requête SQL, nom de la file, modèle appelé. La propagation entre services se fait par l'en-tête W3C
traceparent. - Instrumentation. La voie recommandée est OpenTelemetry : SDK du langage, instrumentation automatique des bibliothèques courantes, export en OTLP. Les anciennes bibliothèques clientes Trace restent utilisables, mais Google oriente les nouveaux projets vers OpenTelemetry, plus simple et non spécifique à un fournisseur.
- Ingestion. Deux portes d'entrée : l'API Telemetry (
telemetry.googleapis.com), qui accepte l'OTLP tel quel, et l'API Cloud Trace historique. Entre l'application et l'API, on place généralement le collecteur OpenTelemetry construit par Google — sur GKE, Compute Engine ou en conteneur auxiliaire — pour échantillonner et enrichir au même endroit pour tous les services. - Traces automatiques. Cloud Run, les fonctions Cloud Run et App Engine standard produisent des spans sans instrumentation ; ces spans-là ne sont pas facturés.
- Stockage. Les spans arrivent dans un bucket d'observabilité
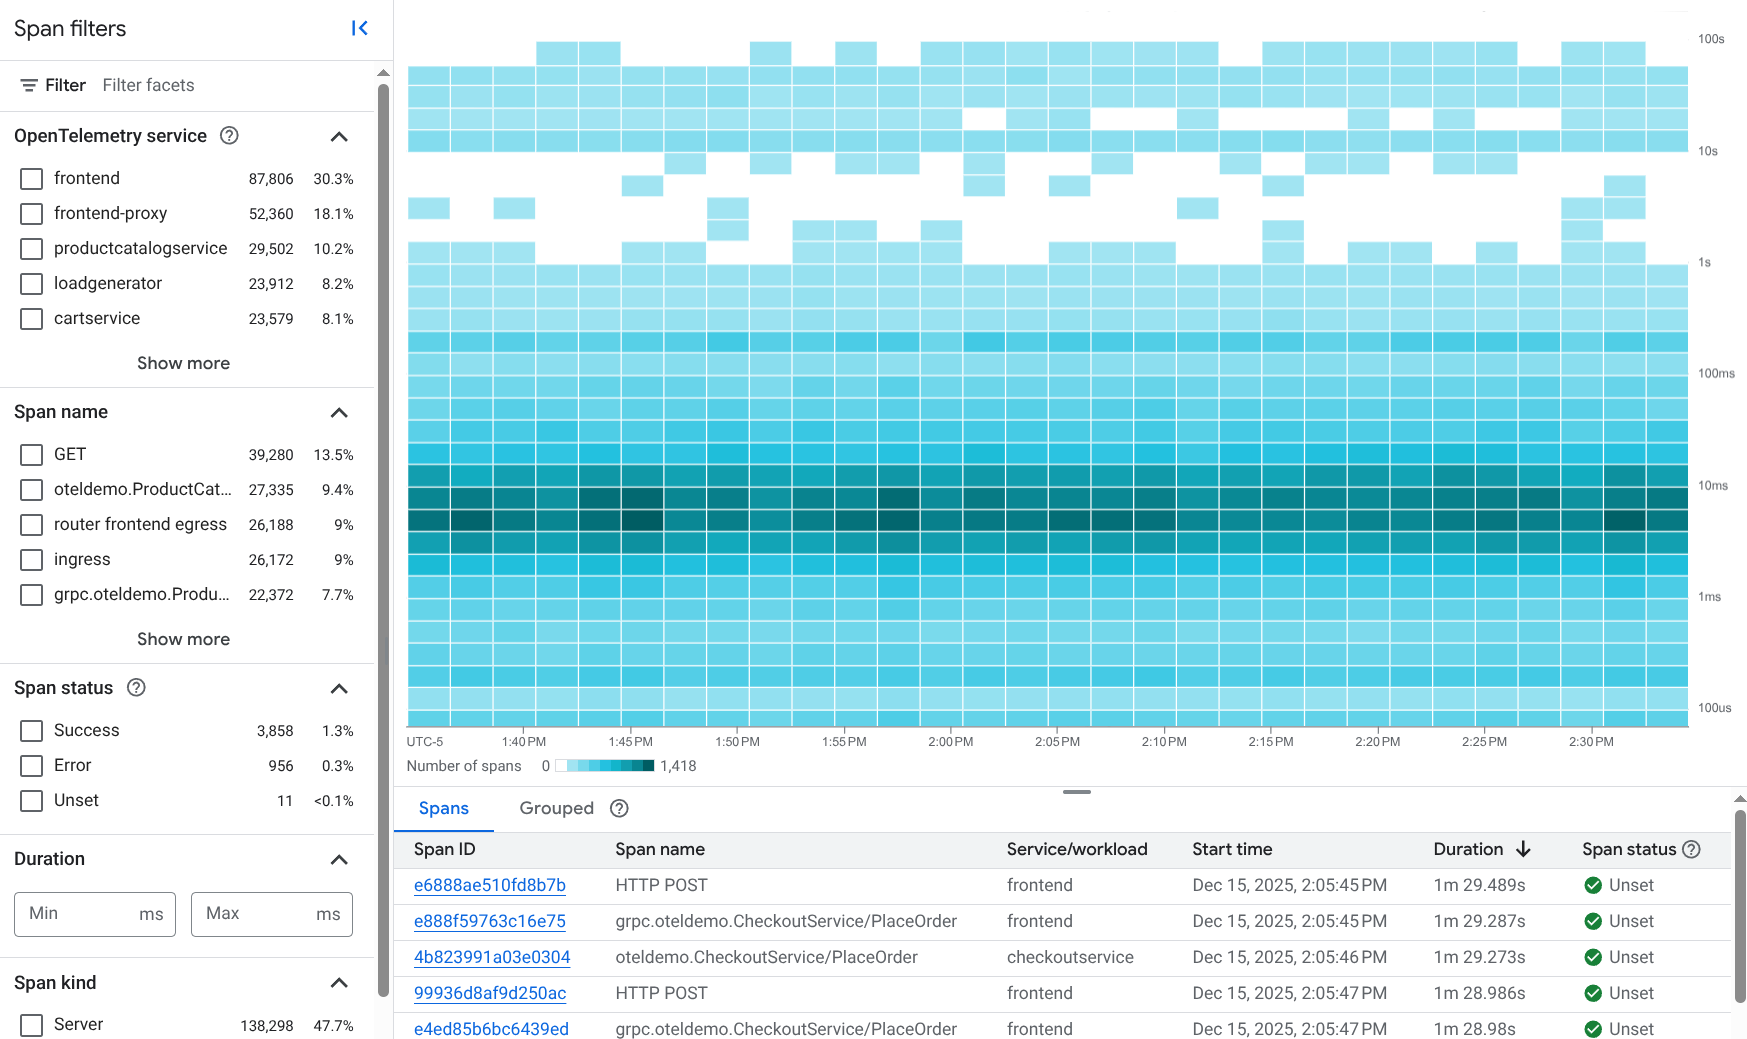
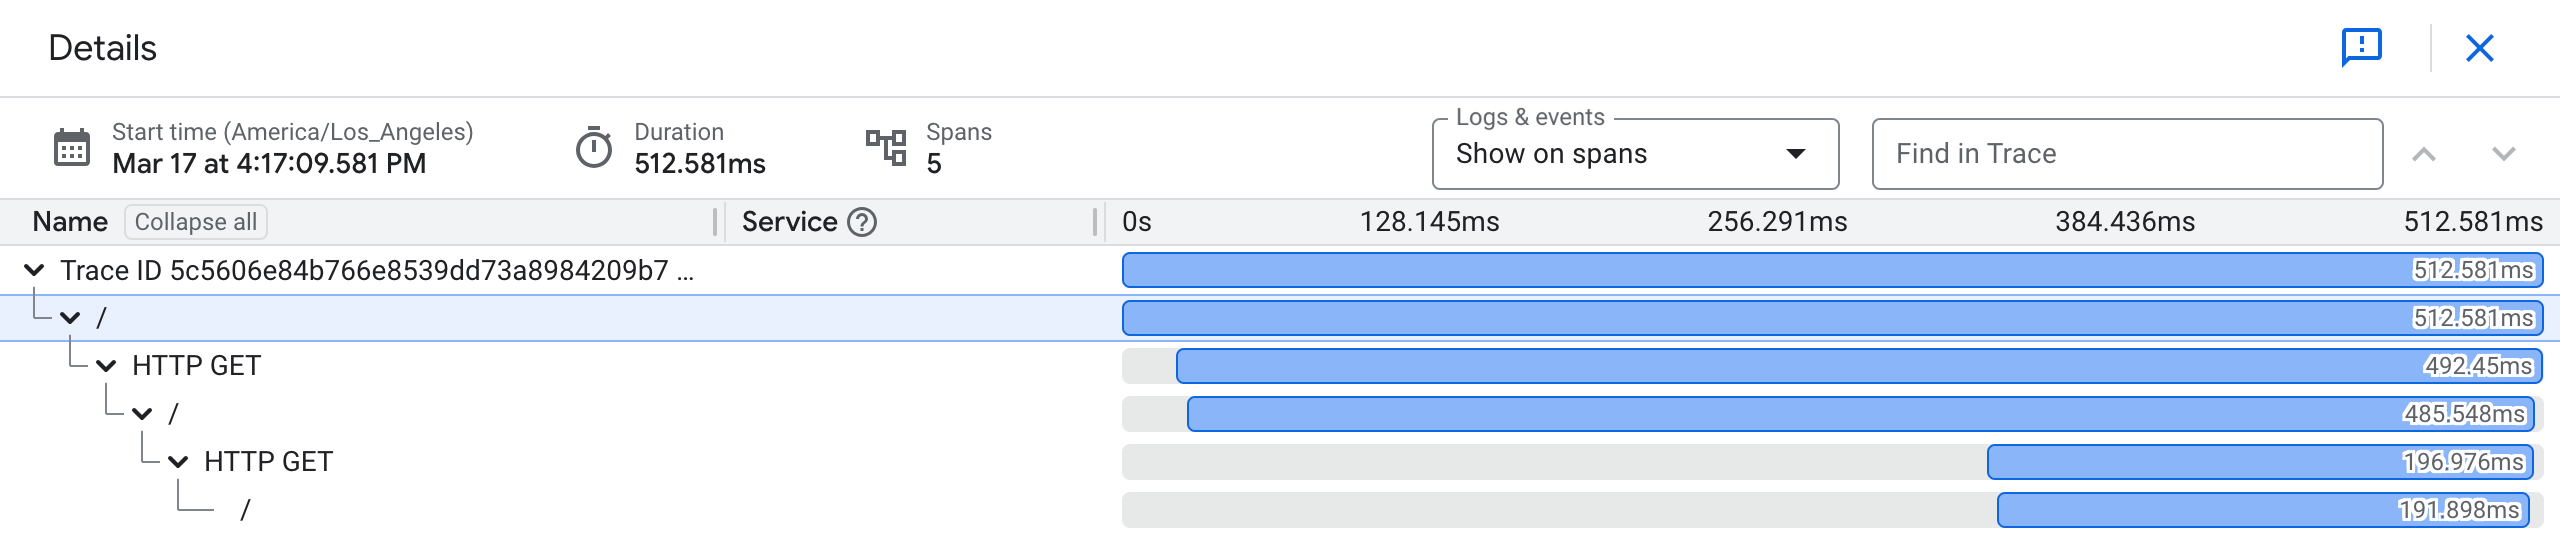
_Tracecréé d'office, avec un jeu de donnéesSpanset une vue_AllSpans, et une rétention de 30 jours. Un jeu de données BigQuery lié permet de les interroger en SQL et de les joindre à d'autres tables. - Exploration. L'explorateur de traces affiche un nuage de points latence/temps, des filtres par attribut, un graphe des dépendances entre services et le détail chronologique d'une trace, avec les entrées de journal du même contexte.
- Facturation au span ingéré, avec une franchise mensuelle par compte de facturation. Les spans produits automatiquement par les services managés n'entrent pas dans le compte.
Les puits de traces (trace sinks) déconseillé sont en fin de vie : ils n'acceptent ni création ni modification, et le service ferme le 18 février 2027. L'export d'analyse passe par le jeu de données BigQuery lié au bucket
_Trace.
À quoi ça sert
- Situer une lenteur dans une chaîne d'appels : quel service, quel appel de base de données, quelle attente de file.
- Comparer les percentiles de latence d'un point de terminaison avant et après une mise en production, filtre par version à l'appui.
- Repérer les appels en cascade et les requêtes N+1, que les seules métriques agrégées ne montrent pas.
- Relier une trace lente aux journaux émis pendant son exécution, et inversement, par l'identifiant de trace porté dans les deux.
- Suivre les appels d'une application d'IA générative : les conventions sémantiques d'OpenTelemetry décrivent les appels de modèle et les étapes d'agent comme des spans ordinaires.
À éviter comme source de mesure continue : échantillonner des traces sert à diagnostiquer, pas à compter. Un taux d'erreur, un débit ou un percentile suivi en permanence se calcule en métrique (Cloud Monitoring, Managed Service for Prometheus), avec une rétention bien plus longue que 30 jours. À éviter aussi pour mesurer où un processus unique passe son temps CPU : c'est le terrain de Cloud Profiler, qui travaille à l'intérieur du span et non entre les services.
Dans la console
Alternatives en logiciel libre
- OpenTelemetry (Apache 2.0) : la spécification, les SDK et le collecteur que Cloud Trace consomme directement. Changer de backend ne demande alors que de changer d'exportateur.
- Jaeger (Apache 2.0) : collecte, stockage et interface de traces distribuées ; l'équivalent le plus direct de l'explorateur de traces.
- Grafana Tempo (AGPL v3) : stockage de traces sur objet, sans index, interrogé par TraceQL et intégré aux tableaux de bord Grafana.
- Zipkin (Apache 2.0) : le traceur historique, simple à déployer, toujours utilisé pour les architectures modestes.
- SigNoz (MIT pour le cœur) : traces, métriques et journaux dans une même interface, avec ClickHouse en stockage.
- Apache SkyWalking (Apache 2.0) : APM orienté agents automatiques pour la JVM et .NET, avec analyse topologique des services.
- Pixie (Apache 2.0) : capture eBPF du trafic d'un cluster Kubernetes, sans modifier le code — une réponse différente à la même question.
Documentation
- Documentation
- Vue d'ensemble
- Instrumentation OpenTelemetry
- Mise en place en Python
- Collecteur OpenTelemetry sur GKE
- Trouver et filtrer les traces
- Analyser une latence
- Filtres de traces
- Stockage des traces
- Analyse en SQL
- Schéma des spans
- API REST
- Bibliothèques clientes
- Dépannage
- Quotas et limites
- Dépréciations
- Tarifs
- Notes de version