Cloud Service Mesh
- Le plan de contrôle géré injecte un proxy Envoy en conteneur auxiliaire dans chaque Pod du maillage et lui pousse sa configuration par l'API xDS.
- Chaque proxy reçoit aussi un certificat : l'identité du service, et non l'adresse IP du Pod, devient la base des autorisations.
- Le trafic extérieur entre dans le maillage par la passerelle d'entrée, un déploiement de proxys exposé par un load balancer.
- La passerelle applique les règles de routage : hôte, chemin, en-têtes, pourcentage de trafic par version.
- Les appels entre services passent de proxy à proxy, chiffrés en mTLS, avec répartition de charge, nouvelles tentatives et coupe-circuit.
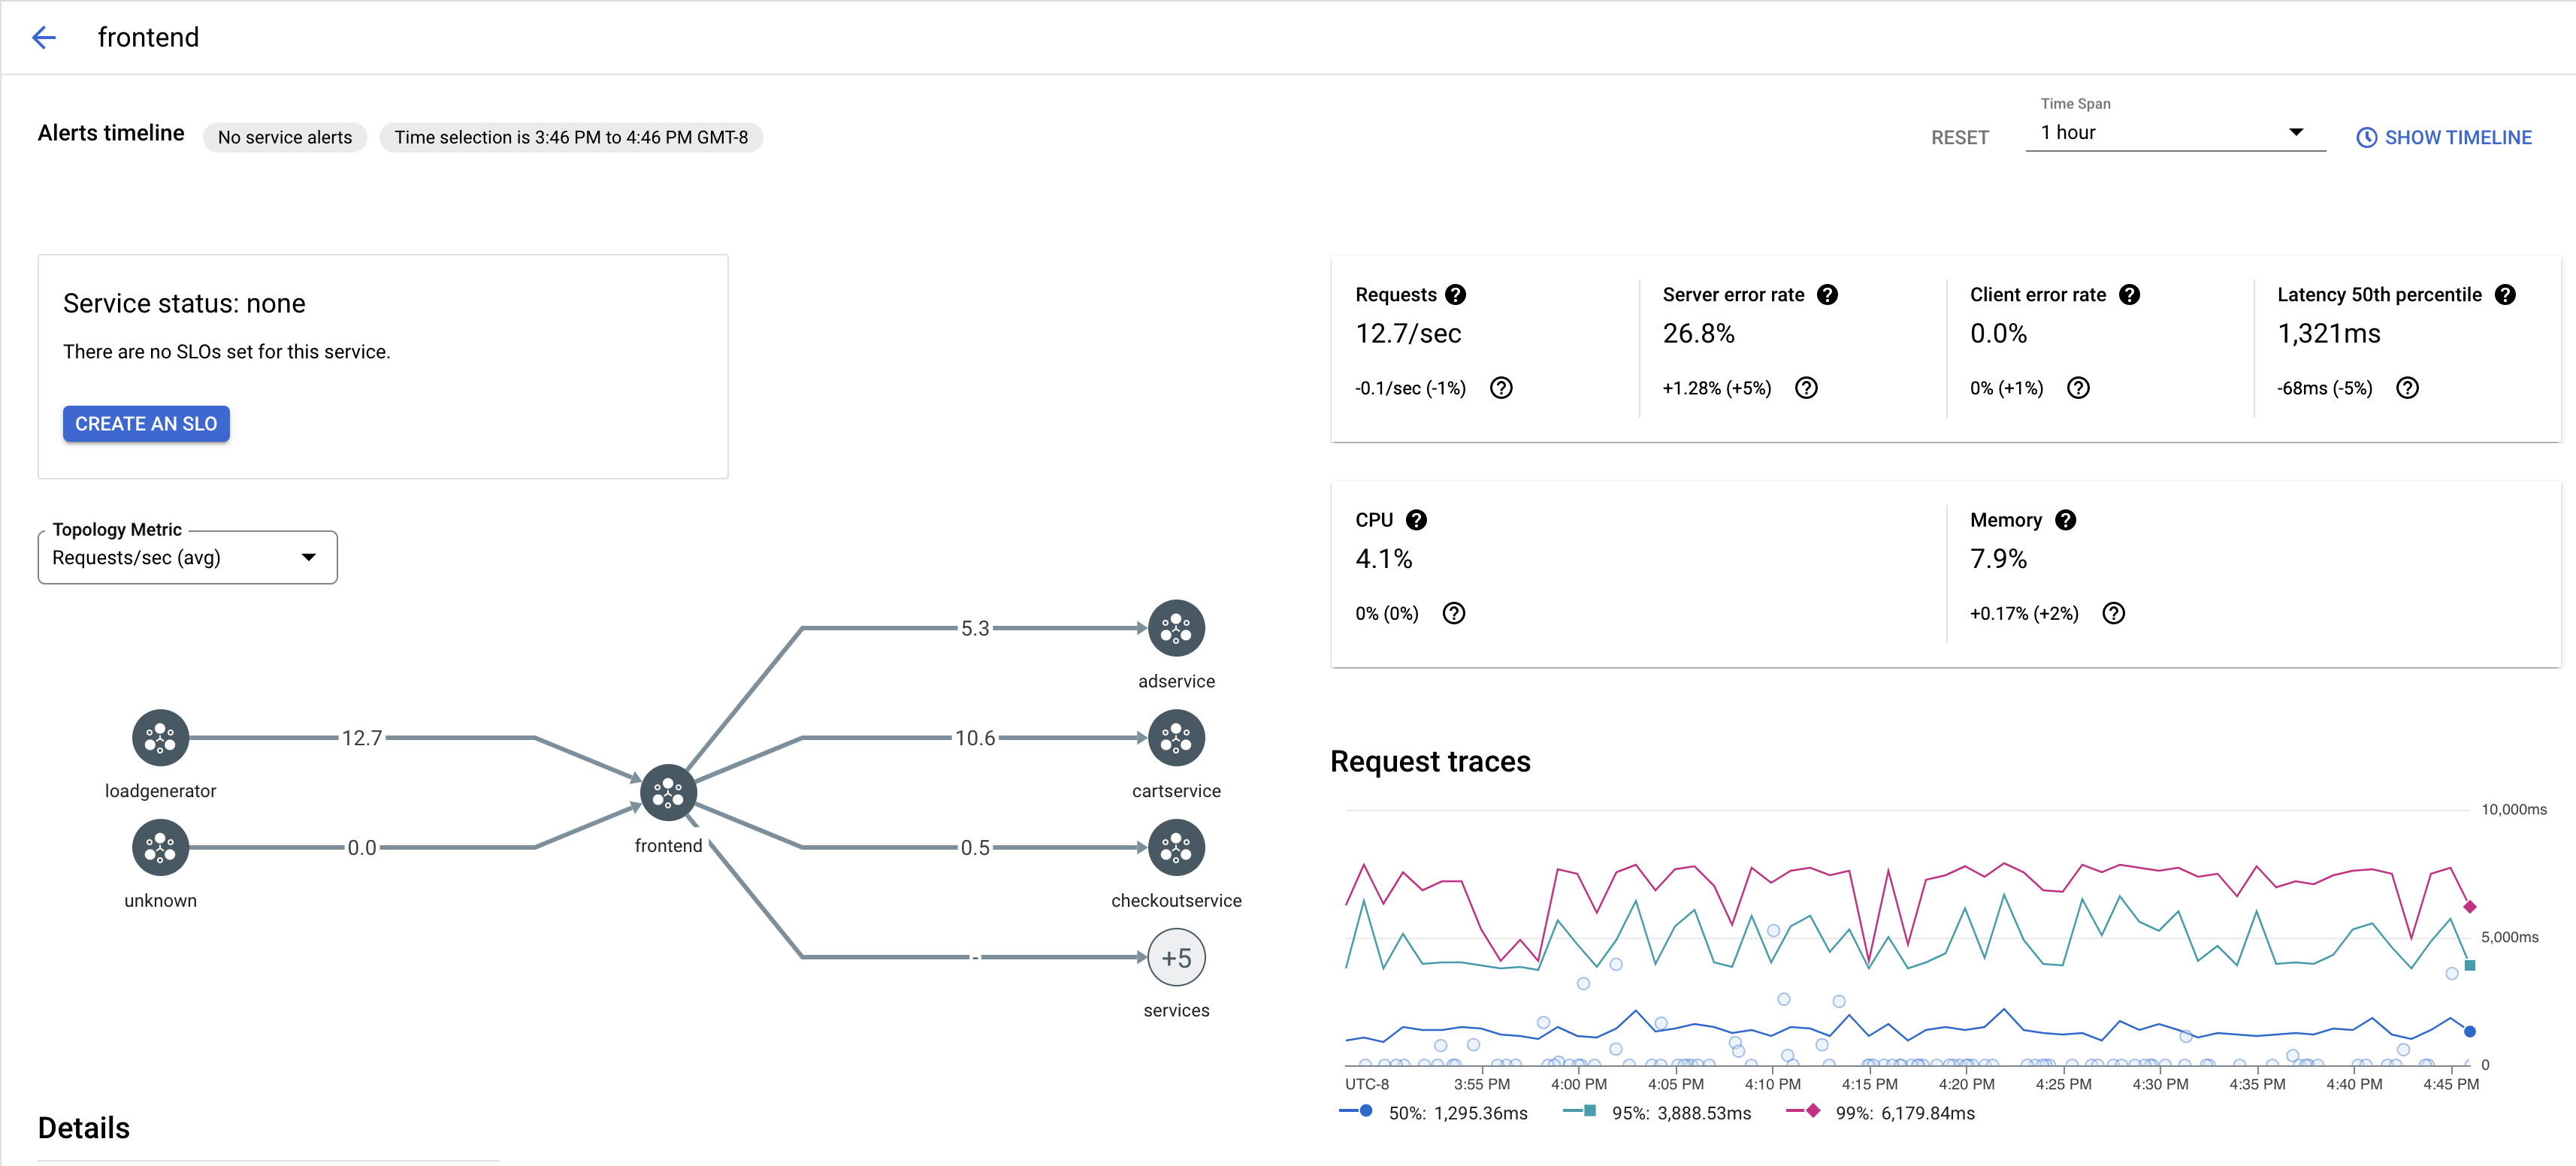
- Les proxys remontent métriques, traces et journaux : graphe de topologie, taux d'erreur, latence et SLO dans la console.
Ce que c'est
Maillage de services managé, issu de la fusion d'Anthos Service Mesh et de Traffic Director. Il prend en charge la communication entre services — routage, chiffrement, mesure — sans toucher au code des applications.
- Plan de contrôle et plan de données. Le plan de contrôle connaît l'inventaire des services et de leurs points de terminaison (adresses des Pods, VM d'un groupe d'instances géré) et pousse la configuration aux proxys. Le plan de données est fait de proxys Envoy déployés en conteneur auxiliaire à côté de chaque charge de travail, ou d'applications gRPC sans proxy qui parlent directement le protocole xDS ; les deux coexistent dans un même maillage.
- Deux jeux d'APIs. Sur GKE, la configuration s'écrit avec les APIs Istio open source (
VirtualService,DestinationRule,AuthorizationPolicy). Sur Compute Engine, elle s'écrit avec les APIs de routage de services propres à Google Cloud. Hors Google Cloud — Distributed Cloud, Kubernetes multicloud — seules les APIs Istio sont disponibles. - Déploiement. La forme recommandée est le maillage géré : Google exploite le plan de contrôle et, sur GKE, le plan de données — mises à niveau, dimensionnement, correctifs de sécurité compris. Le plan de contrôle dans le cluster reste possible hors Google Cloud, et est découragé sur Google Cloud. Sur les clusters Autopilot, le maillage géré s'active comme un module complémentaire.
- Gestion du trafic. Découverte de services, répartition de charge, déploiements canari et bleu-vert par pourcentages, routage fin sur l'hôte, le chemin ou les en-têtes, coupe-circuits, nouvelles tentatives et délais. Le même mécanisme couvre le trafic entrant (passerelles d'entrée), sortant (passerelles de sortie) et interne.
- Sécurité. L'authentification entre services repose sur des certificats mTLS plutôt que sur des jetons porteurs, ce qui chiffre tout le trafic TCP en transit et coupe court aux attaques par rejeu. Les règles d'autorisation s'expriment sur l'identité du service appelant, indépendamment de sa position réseau, et les journaux d'accès enregistrent cette identité en plus de l'adresse IP.
- Observabilité. Les métriques et journaux du trafic HTTP du maillage sont ingérés automatiquement : tableaux de bord de services préconfigurés dans la console, graphe des dépendances entre services, télémétrie détaillée dans Cloud Monitoring, Cloud Logging et Cloud Trace, et définition d'objectifs de niveau de service avec alertes.
Un conteneur auxiliaire par Pod n'est pas gratuit : chaque proxy consomme processeur et mémoire, et ajoute deux sauts réseau à chaque appel. Sur un petit nombre de services, le maillage coûte plus qu'il ne rapporte.
À quoi ça sert
- Chiffrer et authentifier tous les appels entre services d'une application découpée en microservices, sans modifier le code ni distribuer de secrets.
- Publier en douceur : router un pourcentage du trafic vers une nouvelle version, observer les erreurs et la latence, puis basculer ou revenir en arrière.
- Comprendre une application que personne ne maîtrise plus : le graphe de topologie montre qui appelle qui, à quel débit et avec quel taux d'erreur.
- Tenir des objectifs de niveau de service par service, avec alertes sur le budget d'erreur.
- Relier des charges hétérogènes — Pods GKE, VM Compute Engine, clusters hors Google Cloud — dans un seul maillage à la configuration commune.
À éviter tant que le nombre de services reste petit, ou quand tout tient sur Cloud Run : le chiffrement du transport, l'identité par compte de service et le découpage du trafic entre révisions y sont déjà là, sans proxy à exploiter. À éviter aussi comme seul moyen d'exposer une application à l'extérieur : une ressource Gateway ou un load balancer applicatif suffit s'il n'y a ni maillage interne, ni politique inter-services à appliquer.
Dans la console
Alternatives en logiciel libre
- Istio : le projet dont Cloud Service Mesh reprend les APIs et le plan de données Envoy ; l'équivalent exact, plan de contrôle à exploiter soi-même. Son mode ambient supprime le conteneur auxiliaire au profit d'un agent par nœud.
- Linkerd : maillage plus léger, avec son propre proxy en Rust ; mTLS et métriques en place par défaut, surface de configuration plus réduite.
- Envoy seul, piloté par un plan de contrôle maison en xDS : la même brique de base, sans l'abstraction du maillage.
- Cilium Service Mesh : maillage fondé sur eBPF, sans conteneur auxiliaire pour la couche 4, qui s'appuie sur le même plan de données réseau que GKE Dataplane V2.
- Kuma : maillage bâti sur Envoy, multi-zone, qui couvre Kubernetes et les machines virtuelles.