Cloud Profiler
- L'agent lié au service Java capture un profil de dix secondes quand le backend le lui demande, environ une fois par minute et par type de profil.
- Le même agent existe en bibliothèque Go, Node.js et Python : quelques lignes au démarrage du programme suffisent à l'activer.
- Une application hébergée ailleurs écrit dans le projet avec un compte de service, en renseignant elle-même le nom, la version et la zone du déploiement.
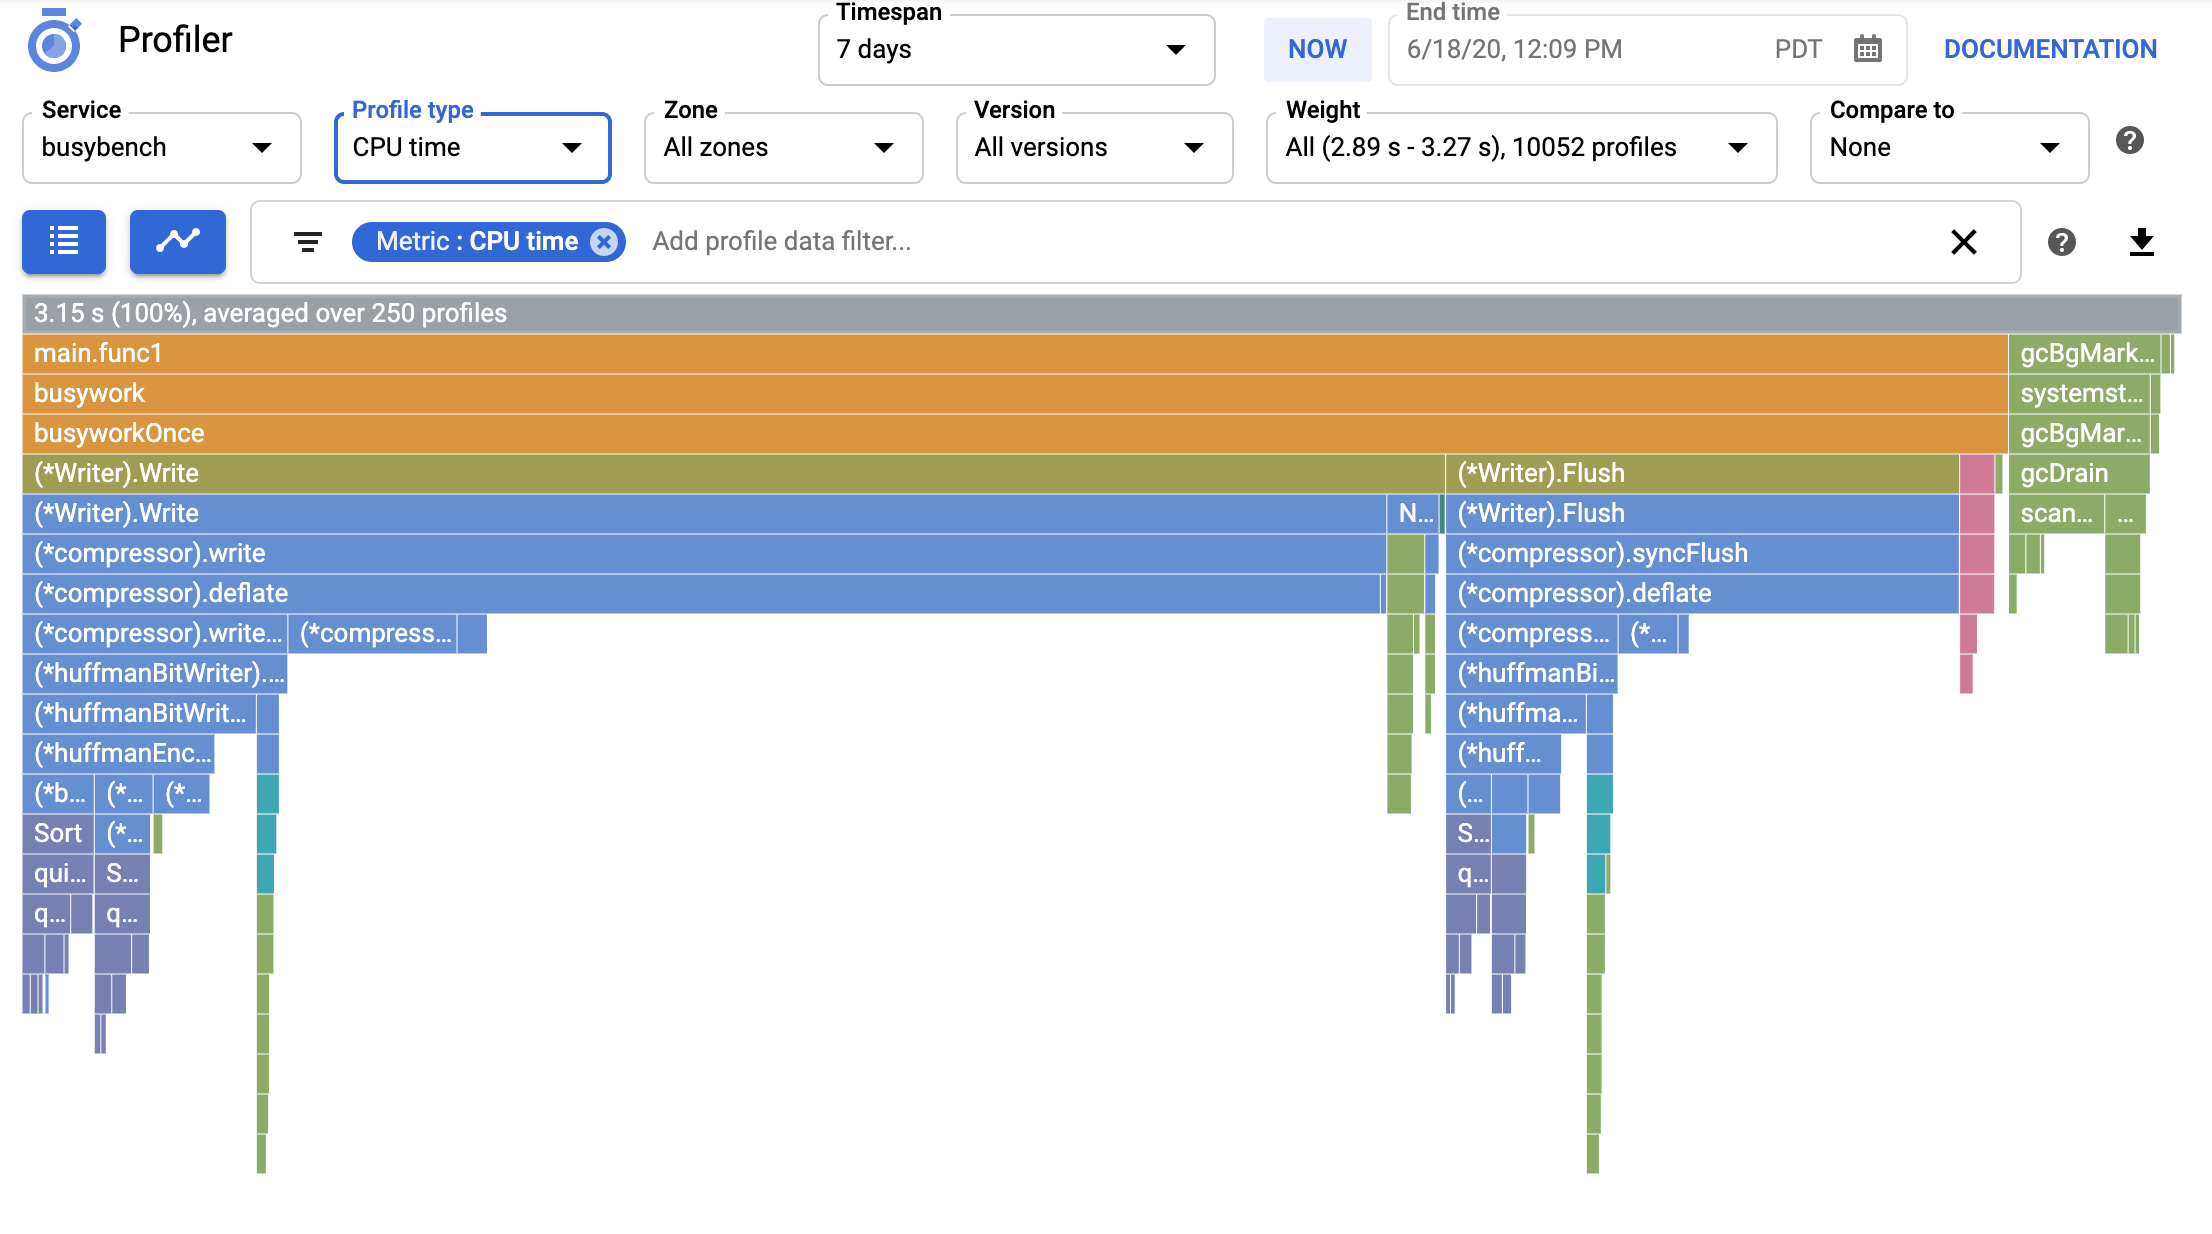
- La console agrège les profils d'un même déploiement sur l'intervalle choisi et les rend sous forme de graphe de flamme.
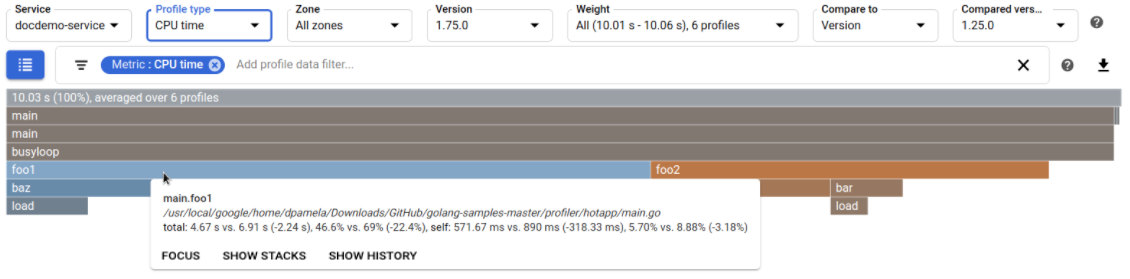
- Le mode comparaison superpose deux jeux de profils — deux versions, deux zones — et colore les fonctions qui ont changé de poids.
Ce que c'est
Profileur continu de Google Cloud Observability, le nom d'ensemble qui réunit Cloud Monitoring, Cloud Logging, Cloud Trace, Error Reporting, Profiler et Managed Service for Prometheus. Il prélève en permanence des échantillons de pile d'appels dans les processus de production et montre où le temps et la mémoire partent réellement.
- Profileur statistique. Un agent lié au processus reste inactif la plupart du temps. Le backend choisit un agent par déploiement et par type de profil environ une fois par minute et lui demande une capture de dix secondes ; les profils de tas et de threads, eux, sont pris instantanément. Le surcoût reste compatible avec un environnement de production.
- Agent en bibliothèque. Il s'ajoute au code : import et appel d'initialisation en Go, Node.js et Python, agent Java en
-agentpathpour la JVM. Rien à installer sur la machine. - Types de profils selon le langage : Go couvre le jeu le plus complet (temps CPU, tas, tas alloué, contention, threads), Java le temps CPU, le tas et le temps écoulé, Node.js le tas et le temps écoulé, Python le temps CPU et le temps écoulé. L'écart entre temps écoulé et temps CPU désigne une attente : verrou, entrée-sortie, appel réseau.
- Déploiement. Un profil est rangé par projet, nom de service, version et zone. Ces quatre champs sont renseignés automatiquement sur GKE, Compute Engine, Cloud Run et App Engine, et à la main ailleurs — y compris sur une machine hors de Google Cloud.
- Lecture. Le graphe de flamme empile les cadres d'appel, chaque barre étant proportionnelle au poids mesuré. On filtre par expression sur le nom des fonctions, on met en avant un cadre, et le mode comparaison superpose deux sélections (deux versions, deux zones, deux périodes) en colorant les régressions.
- Facturation. Profiler n'est pas facturé. Seuls les quotas d'API s'appliquent.
Un profil n'a de sens que rapproché d'une version : renseigner
service_versionavec la version réelle du déploiement transforme le comparateur en détecteur de régression de performance entre deux livraisons.
À quoi ça sert
- Trouver la fonction qui consomme le CPU d'un service en production, là où un profilage en environnement de test ne reproduit ni la charge ni les données réelles.
- Chercher l'origine d'une consommation mémoire qui croît, en comparant le tas alloué au tas vivant.
- Distinguer un code réellement coûteux d'un code qui attend : le temps écoulé bien supérieur au temps CPU désigne un verrou ou un appel bloquant.
- Vérifier après coup qu'une optimisation a produit l'effet attendu, en comparant deux versions du même service.
- Profiler une application qui tourne sur site ou chez un autre fournisseur, en écrivant dans un projet Google Cloud.
À éviter pour comprendre une latence répartie sur plusieurs services : Profiler regarde l'intérieur d'un processus, pas le chemin d'une requête — c'est le rôle de Cloud Trace. À éviter aussi comme outil de mesure continue : il n'émet ni métrique ni alerte, il ne répond qu'à la question « où passe le temps ». Enfin, il ne couvre pas les langages hors de la liste ci-dessus ni le code natif appelé depuis ces langages ; pour du C++, du Rust ou du profilage à l'échelle de la machine, il faut un profileur système.
Dans la console
Alternatives en logiciel libre
- Grafana Pyroscope (AGPL v3) : profilage continu en production, stockage des profils et comparaison entre versions — l'équivalent le plus proche, avec les mêmes graphes de flamme.
- Parca (Apache 2.0) : profilage continu d'un cluster par eBPF, sans agent dans le code, avec stockage des séries de profils.
- async-profiler (Apache 2.0) : profileur JVM par échantillonnage de piles, sans le biais des points de sécurité, référence côté Java.
- py-spy (MIT) et pprof (Apache 2.0) : profilage à la demande d'un processus Python ou Go déjà en cours, sans le redémarrer ; le format
pprofest celui que Profiler exporte. - perf (GPL v2) et bpftrace (Apache 2.0) : profilage au niveau du noyau Linux, pour le code natif et pour ce qui se passe hors du langage applicatif.
- FlameGraph (CDDL) : les scripts d'origine qui produisent les graphes de flamme à partir de piles échantillonnées.