Cloud Monitoring
- L'agent Ops installé sur la VM relève les métriques système, celles du matériel et celles des applications tierces qu'il reconnaît.
- Les services managés publient d'office leurs métriques — requêtes, latences, instances actives — sans agent ni configuration.
- Les métriques Prometheus du cluster arrivent par Managed Service for Prometheus et se lisent en PromQL dans le même projet.
- Une métrique basée sur les journaux compte les entrées qui correspondent à un filtre et devient une série temporelle comme les autres.
- La condition d'une règle d'alerte est franchie : un incident s'ouvre et part vers les canaux de notification déclarés.
- Une vérification de disponibilité interroge l'URL depuis plusieurs régions ; l'échec simultané de plusieurs sondes déclenche une alerte.
Ce que c'est
Service de métriques de Google Cloud Observability, le nom d'ensemble sous lequel Google réunit Monitoring, Cloud Logging, Cloud Trace, Error Reporting, Cloud Profiler et Managed Service for Prometheus. Il stocke les séries temporelles dans Monarch, la base de métriques qui sert aussi la surveillance interne de Google, et fournit les tableaux de bord, les alertes et les SLO qui vont avec.
- Modèle de données. Une série temporelle est identifiée par un type de métrique (
compute.googleapis.com/instance/cpu/utilization), une ressource surveillée (gce_instance,k8s_container,cloud_run_revision) et des étiquettes. Chaque point porte un type (jauge, delta, cumul) et une valeur (booléen, entier, réel, chaîne, distribution pour les histogrammes de latence). - Sources. Plus de 6 500 types de métriques Google Cloud sont collectés sans configuration et sans facturation. S'y ajoutent les métriques personnalisées écrites par l'application, les métriques OTLP, les métriques Prometheus, les métriques basées sur les journaux et les métriques remontées par l'agent Ops.
- Agent Ops. Agent unique pour les VM Linux et Windows : Fluent Bit pour les journaux, OpenTelemetry Collector pour les métriques et les traces, configuré en YAML. Il couvre les métriques système, les GPU et une quarantaine d'applications tierces (MySQL, PostgreSQL, NGINX, Kafka, Redis). Il se déploie à la création de la VM, par une règle d'agent, par
gcloudou par Terraform. - Champ d'application des métriques (metrics scope). Un projet de rattachement agrège les métriques de plusieurs projets pour les afficher dans une même vue. La limite recommandée est de 375 projets par champ d'application, 3 500 au maximum. Le champ d'application ne change ni où la donnée est reçue ni qui la paie.
- Interrogation. PromQL est le langage recommandé, y compris sur les métriques Google Cloud ; l'explorateur de métriques propose aussi une construction guidée et un mode SQL. Monitoring Query Language (MQL) est hors support et absent de la console ; les requêtes MQL restent exécutables par l'API.
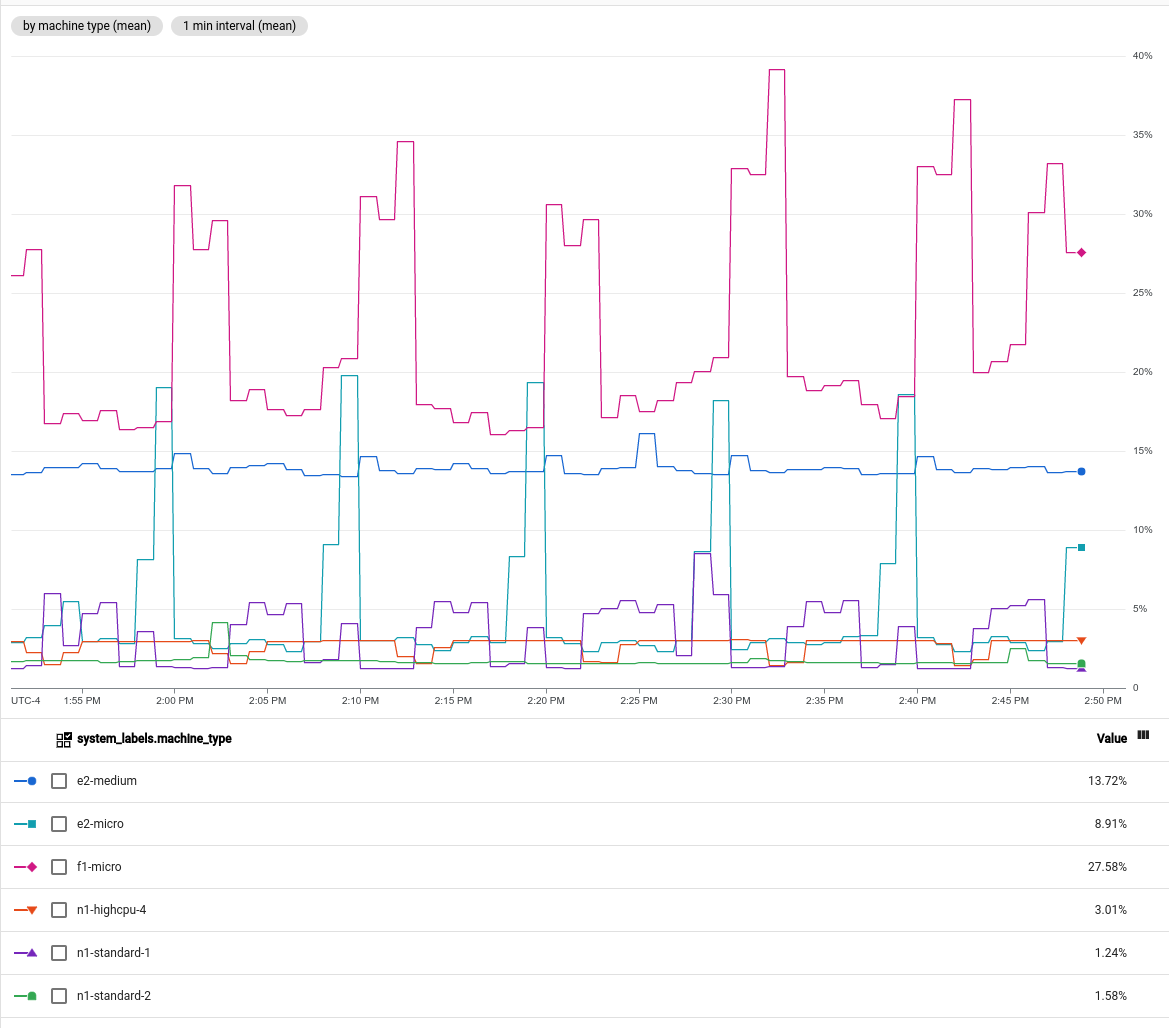
- Tableaux de bord. Tableaux prédéfinis par service, tableaux personnalisés en widgets (courbes, jauges, tableaux, heatmaps, treemaps, cartes de scores, journaux, incidents) avec variables de filtrage. Un tableau de bord se décrit en JSON et se versionne comme du code (API,
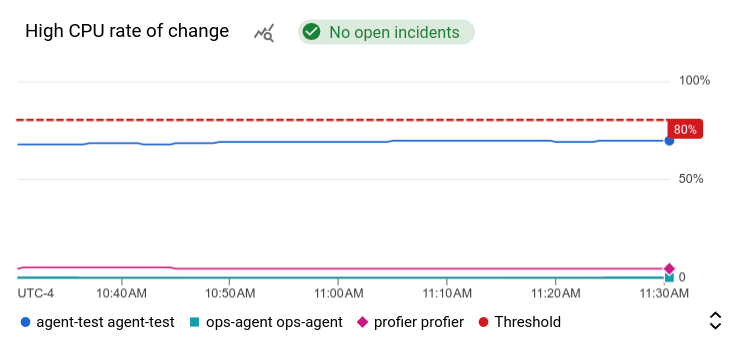
gcloud, Terraform). - Alertes. Une règle d'alerte associe une ou plusieurs conditions (seuil sur métrique, absence de métrique, requête PromQL, correspondance de journal, prévision) à des canaux de notification : e-mail, SMS, application mobile Cloud, Slack, PagerDuty, webhook, Pub/Sub, et Google Chat préversion . Une alerte s'ouvre au franchissement et se ferme au retour à la normale (l'API et les notifications la décrivent comme un objet
incident) ; la documentation de la règle, écrite en Markdown avec des variables, part dans la notification. - Disponibilité. Les vérifications de disponibilité interrogent une URL, une adresse IP ou une ressource depuis plusieurs régions, en public ou en privé. Les moniteurs synthétiques vont plus loin : une fonction Node.js exécute un scénario complet, y compris un parcours de navigateur avec Puppeteer.
- SLO. Un service (Cloud Run, GKE, App Engine, maillage de services ou service déclaré à la main) porte des SLI de disponibilité ou de latence, des SLO sur période calendaire ou glissante, et des alertes sur la vitesse de consommation du budget d'erreur.
- Facturation au volume ingéré : les métriques Google Cloud sont gratuites, les autres sont facturées à partir de 150 Mio par compte de facturation et par mois. Les métriques Prometheus sont comptées en échantillons. Les appels d'API en écriture ne sont pas facturés ; la lecture l'est au-delà d'un quota gratuit, sauf depuis la console.
La rétention n'est pas la même partout : six semaines pour les métriques Google Cloud, vingt-quatre mois pour les métriques personnalisées, externes et Prometheus, avec un ré-échantillonnage progressif. Une analyse sur plusieurs trimestres suppose donc soit une métrique personnalisée, soit un export vers BigQuery.
À quoi ça sert
- Voir l'état d'un service managé sans rien installer : Cloud Run, GKE, Cloud SQL et les autres publient leurs métriques d'office.
- Surveiller une flotte de VM (Compute Engine) et les serveurs applicatifs qu'elles hébergent, avec l'agent Ops et ses intégrations tierces.
- Porter l'astreinte : règles d'alerte, incidents, canaux de notification et documentation d'intervention attachée à la règle.
- Suivre un engagement de service par des SLO et alerter sur la consommation du budget d'erreur plutôt que sur chaque pic.
- Vérifier de l'extérieur qu'un site ou une API répond, depuis plusieurs continents, et mesurer un parcours complet avec un moniteur synthétique.
- Centraliser la vue de plusieurs projets d'un même environnement dans un champ d'application des métriques unique.
À éviter comme socle d'une supervision multi-cloud dont Google Cloud n'est qu'une partie : les métriques d'autres fournisseurs doivent y être poussées une à une, et un Prometheus ou un Grafana déjà en place ailleurs fera moins de travail. À éviter aussi pour l'analyse fine et rétrospective d'incidents : les métriques agrégées ne remplacent pas les journaux (Cloud Logging) ni les traces (Cloud Trace), et un tableau de bord n'explique pas une latence. Enfin, pour des métriques Prometheus produites en masse par des clusters, passer directement par Managed Service for Prometheus : le modèle de facturation à l'échantillon y est plus avantageux que la facturation à l'octet.
Dans la console
Alternatives en logiciel libre
- Prometheus (Apache 2.0) : collecte par scraping, base de séries temporelles et langage PromQL — celui-là même que Cloud Monitoring a adopté. L'équivalent le plus direct pour la partie métriques.
- Grafana (AGPL v3) : tableaux de bord et alertes sur des sources multiples ; c'est le pendant de la partie visualisation, et il sait interroger Cloud Monitoring directement.
- Alertmanager (Apache 2.0) : routage, regroupement, mise en sourdine et escalade des alertes de Prometheus, l'équivalent des canaux de notification et du cycle de vie des incidents.
- Thanos (Apache 2.0) et Grafana Mimir (AGPL v3) : rétention longue et requêtes globales sur plusieurs Prometheus, ce que Monarch fournit nativement ici.
- VictoriaMetrics (Apache 2.0) : base de séries temporelles compatible PromQL, réputée pour sa compacité, avec sa propre chaîne d'agents et d'alertes.
- Zabbix (AGPL v3) et Icinga 2 (GPL v2) : supervision d'infrastructure par agent et par sonde, proche de l'usage « flotte de VM » et des vérifications de disponibilité.
- Blackbox exporter (Apache 2.0) et Uptime Kuma (MIT) : sondes HTTP, TCP et DNS depuis l'extérieur, l'équivalent des vérifications de disponibilité.
- Pyrra (Apache 2.0) et Sloth (Apache 2.0) : déclaration de SLO et génération des règles Prometheus correspondantes, y compris les alertes de budget d'erreur.
Documentation
- Page produit
- Documentation
- Vue d'ensemble
- Tableaux de bord
- Explorateur de métriques
- Alertes
- Canaux de notification
- Vérifications de disponibilité
- Surveillance des SLO
- Champ d'application des métriques
- PromQL
- Métriques personnalisées
- Liste des métriques Google Cloud
- Agent Ops
- API REST
- Commandes gcloud
- Client Python
- Quotas et limites
- Tarifs
- Notes de version