Cloud Logging
- Les services managés écrivent leurs journaux sans agent : tout ce qui sort sur stdout et stderr devient une entrée, structurée si c'est du JSON.
- Une machine hors de Google Cloud écrit par l'API Logging, au travers de l'agent Ops ou d'un collecteur OpenTelemetry.
- Les journaux d'audit d'activité d'administration sont produits d'office par tous les services et ne peuvent pas être désactivés.
- Chaque entrée traverse le routeur, qui l'évalue contre les filtres d'inclusion et d'exclusion de tous les puits déclarés.
- Le puits _Default dépose l'entrée dans un bucket de journaux, conservée 30 jours ; Log Analytics y ajoute l'interrogation en SQL.
- Un puits vers BigQuery exporte en continu le sous-ensemble filtré qui doit être croisé avec d'autres tables ou gardé plus longtemps.
Ce que c'est
Service de journaux de Google Cloud Observability, le nom d'ensemble qui réunit Logging, Cloud Monitoring, Cloud Trace, Error Reporting, Cloud Profiler et Managed Service for Prometheus. Il ingère, route, stocke et interroge les entrées de journal de tous les services Google Cloud, des machines sur site et des applications instrumentées.
- Entrée de journal. Un objet structuré : horodatage, gravité, ressource surveillée, nom du journal, étiquettes, identifiants de trace et de requête, et une charge utile textuelle ou JSON. La taille maximale est d'environ 256 Kio, 512 Kio pour un journal d'audit. Une application qui écrit du JSON sur stdout obtient des champs indexés sans passer par une bibliothèque cliente.
- Routeur de journaux. Toute entrée écrite traverse le routeur avant d'être stockée. Un puits (sink) associe un filtre d'inclusion, des filtres d'exclusion et une destination : bucket de journaux, BigQuery, Cloud Storage, Pub/Sub ou un autre projet Google Cloud. Le routage lui-même n'est pas facturé, et un puits défini au niveau d'un dossier ou d'une organisation peut agréger les journaux de toute une arborescence.
- Buckets de journaux. Deux buckets existent d'office dans chaque projet :
_Required, qui reçoit les journaux d'audit d'activité d'administration et d'événements système, retenu 400 jours sans modification possible ni facturation, et_Default, qui reçoit tout le reste, retenu 30 jours par défaut et réglable de 1 à 3 650 jours. On crée autant de buckets régionaux que nécessaire, avec leur propre rétention et leurs propres clés de chiffrement. - Vues et champs d'application. Une vue de journaux restreint par filtre ce qu'un compte de service ou une équipe peut lire dans un bucket ; un champ d'application des journaux rassemble plusieurs vues, éventuellement de plusieurs projets, dans une seule recherche.
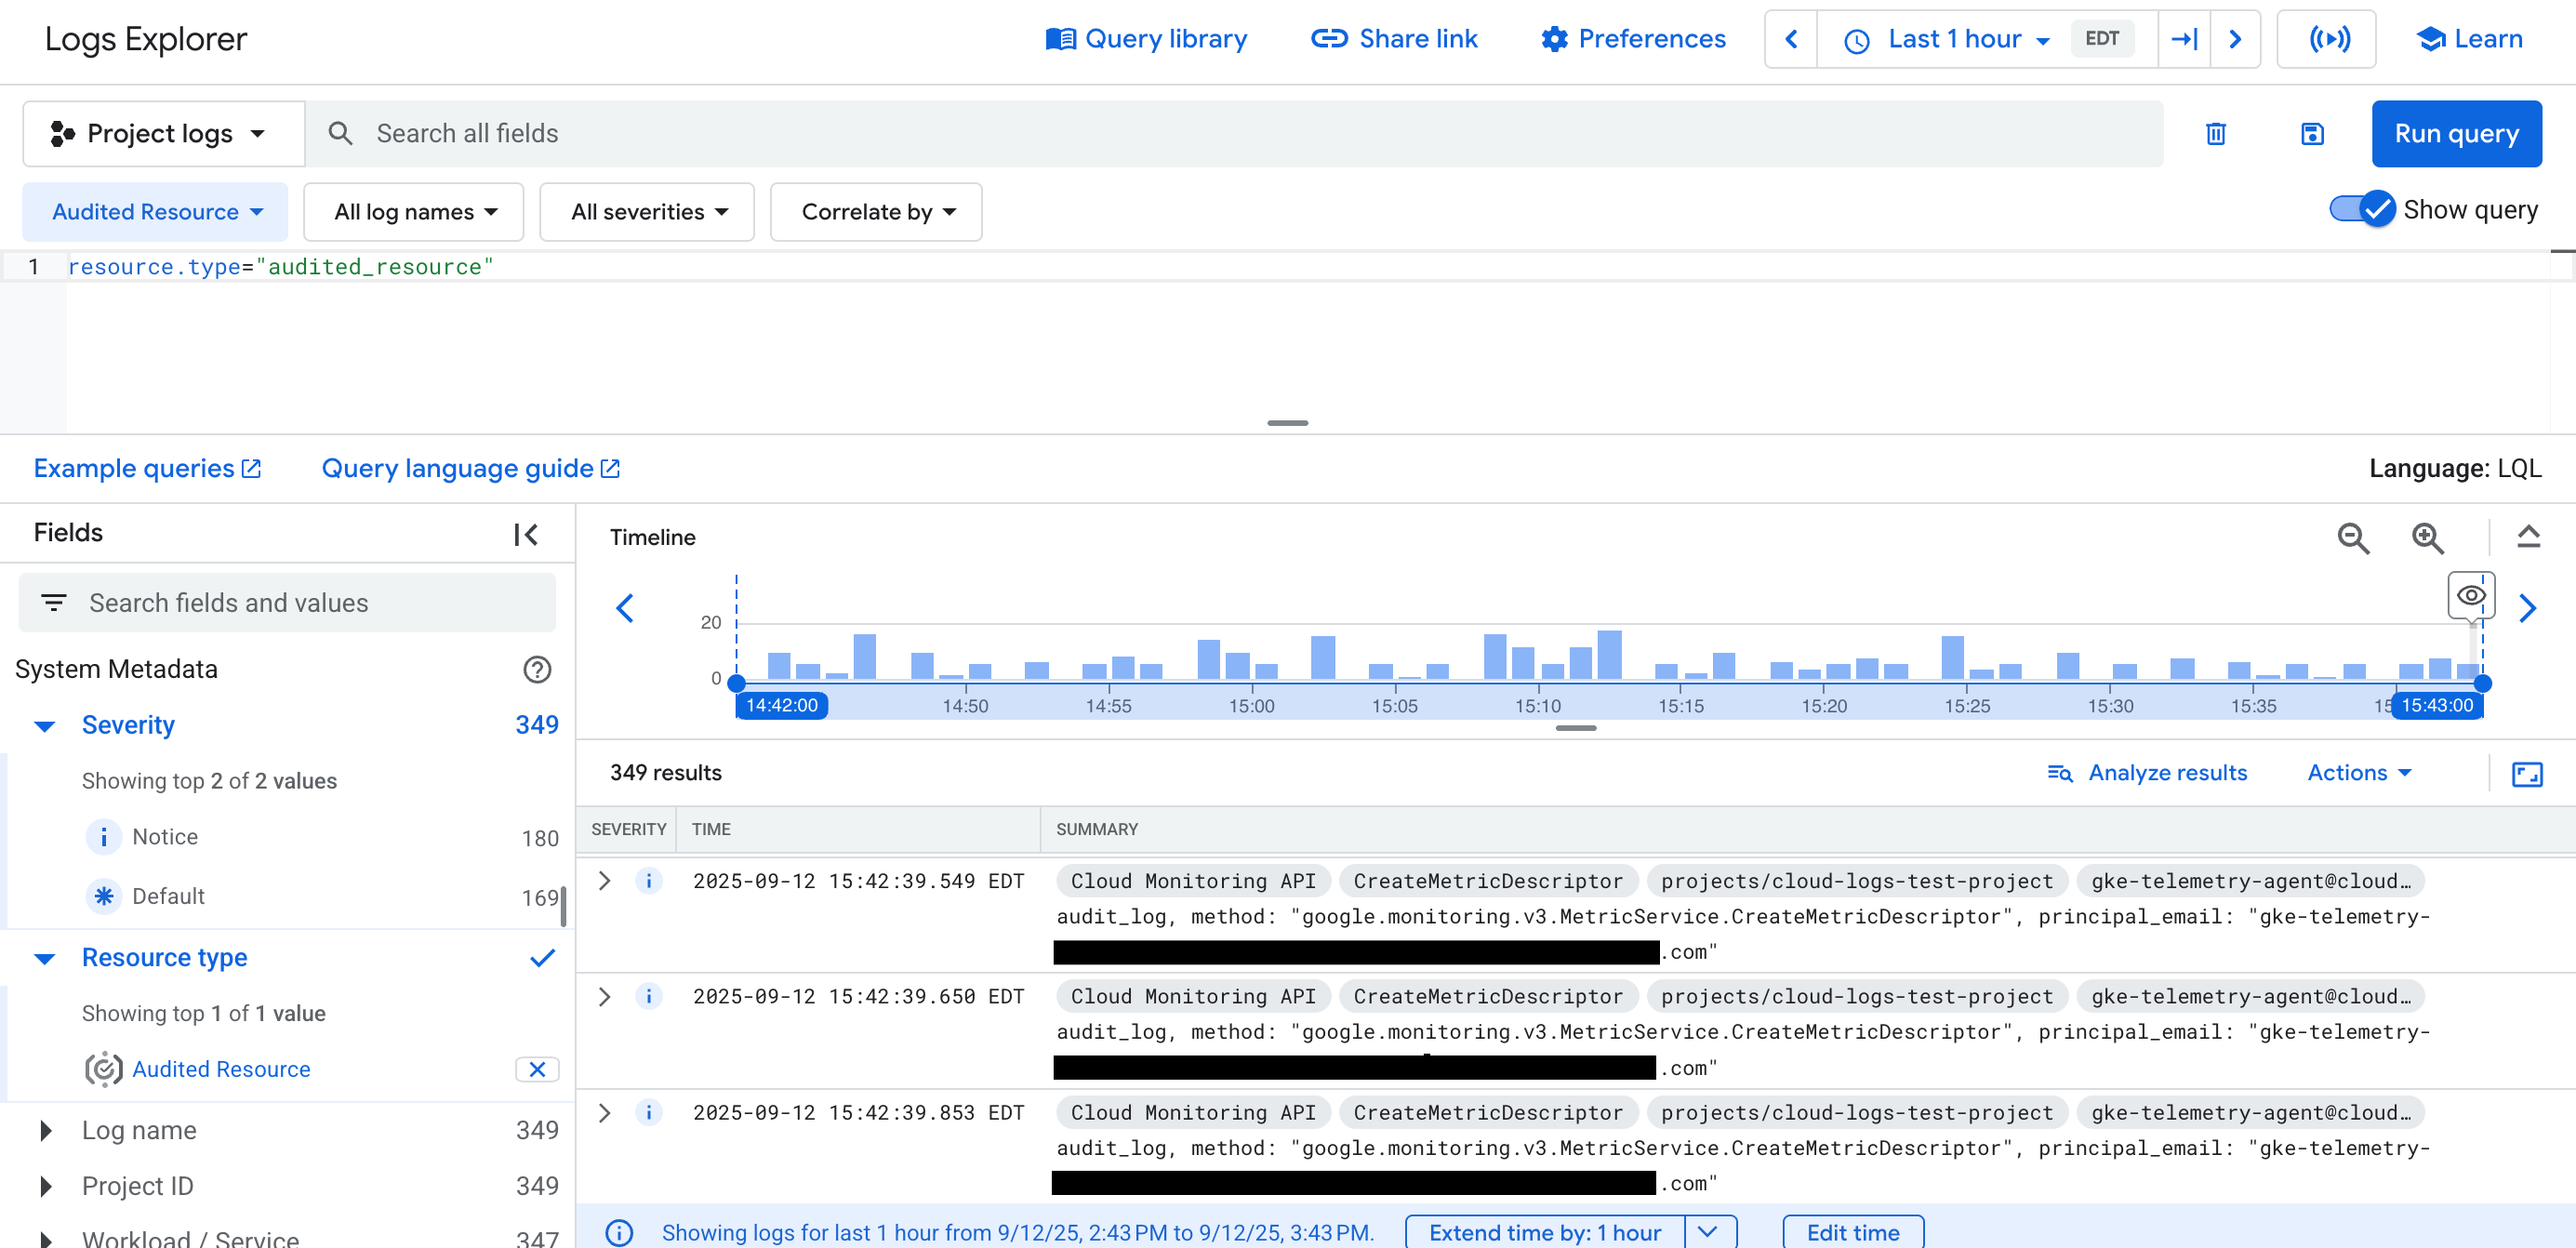
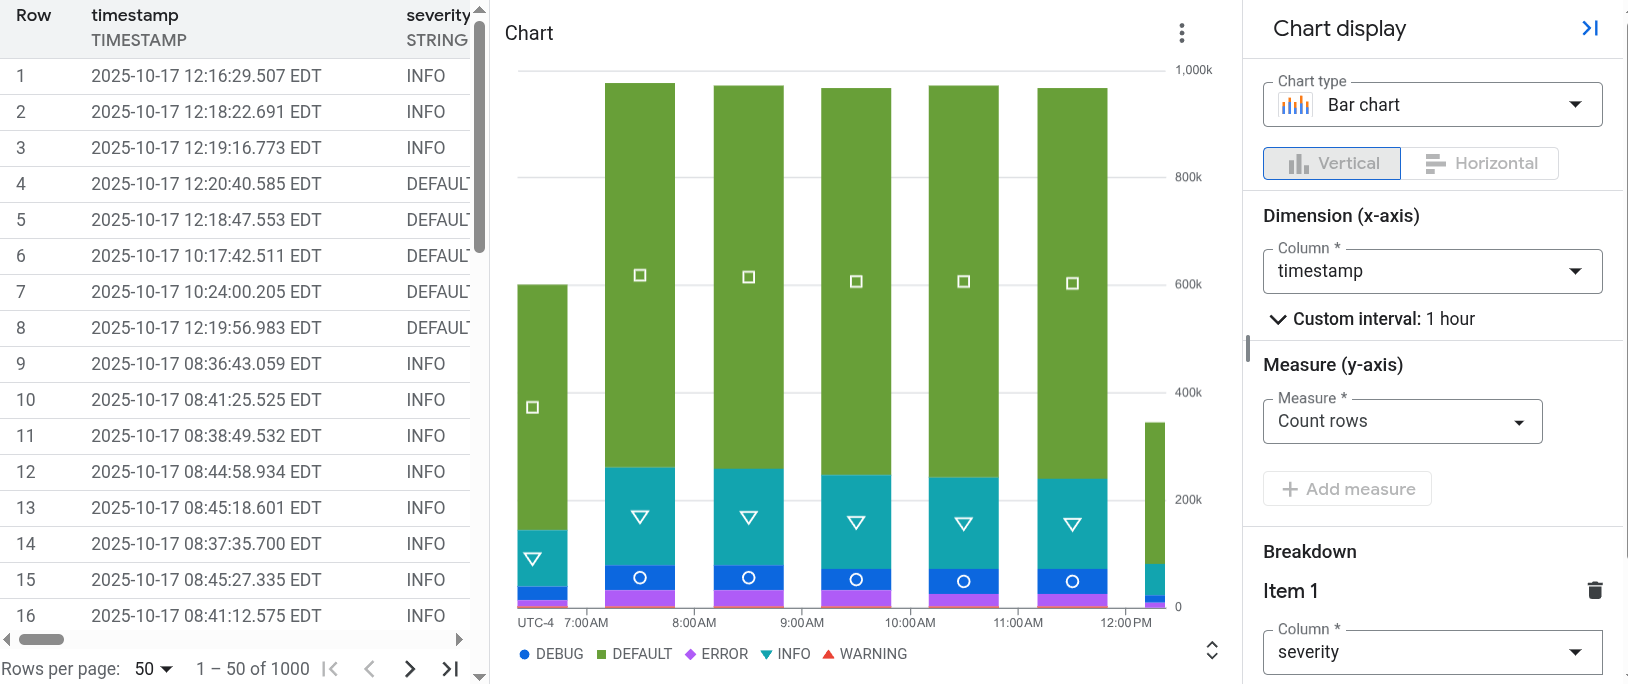
- Interroger. Le langage de requête Logging sert l'explorateur de journaux : comparaisons sur les champs, expressions régulières, recherche plein texte, opérateurs booléens. Observability Analytics (Log Analytics sur la page des tarifs) ajoute le SQL : un bucket mis à niveau devient interrogeable en SQL standard, sans surcoût de requête, et un jeu de données BigQuery lié permet ensuite de joindre les journaux à n'importe quelle autre table.
- Journaux d'audit. Quatre familles : activité d'administration (toujours activée, gratuite), accès aux données (à activer, volumineuse), événements système et refus de règle. Ce sont elles qui répondent à « qui a fait quoi, quand, sur quelle ressource ».
- Métriques basées sur les journaux. Un filtre devient un compteur ou une distribution consommable dans Cloud Monitoring, avec des étiquettes extraites par expression régulière. C'est la passerelle entre un message d'erreur et une règle d'alerte.
- Facturation au volume ingéré : les premiers 50 Gio par projet et par mois sont offerts, le reste est facturé à l'ingestion, stockage de 30 jours compris. Les requêtes et l'analyse ne coûtent rien ; seule la rétention au-delà de 30 jours ajoute un tarif mensuel par Gio.
Le levier de coût n'est pas la rétention mais l'ingestion. Un filtre d'exclusion posé sur le puits
_Default— sondes de disponibilité, journaux d'accès du load balancer,DEBUGdes bibliothèques bavardes — se voit immédiatement sur la facture, alors que raccourcir la rétention ne change presque rien.
À quoi ça sert
- Retrouver le message d'erreur d'une requête précise et remonter à la trace correspondante, les identifiants de trace et de span étant portés par l'entrée elle-même.
- Répondre à un audit : qui a modifié quelle ressource, avec quel compte, depuis quelle adresse, sans instrumentation à ajouter.
- Conserver longtemps un sous-ensemble réglementé de journaux, en les routant vers un bucket à longue rétention verrouillé ou vers Cloud Storage.
- Alimenter un SIEM ou un outil tiers par un puits vers Pub/Sub, sans coupler l'application à l'outil de destination.
- Croiser les journaux avec des données métier dans BigQuery : taux d'erreur par client, volumétrie par tenant, corrélation avec les déploiements.
- Transformer une occurrence de journal en métrique et en alerte, sans écrire de code dans l'application.
À éviter pour la télémétrie à haute fréquence : compter des événements par millions pour en tirer une valeur agrégée coûte beaucoup moins cher en métrique (Cloud Monitoring, Managed Service for Prometheus) qu'en entrées de journal. À éviter aussi comme entrepôt analytique : Log Analytics répond aux questions d'exploitation, mais un usage soutenu en jointures et en agrégations sur des mois de données appelle un puits vers BigQuery et des tables partitionnées. Enfin, ne pas y faire transiter de données sensibles en clair : un journal est lisible par tous les rôles de lecture du projet, et le masquage se fait avant l'écriture, pas après.
Dans la console
Alternatives en logiciel libre
- Grafana Loki (AGPL v3) : indexation par étiquettes plutôt que par contenu, stockage des blocs sur un objet — le modèle le plus proche du couple routeur + bucket, avec son langage LogQL.
- Fluent Bit et Fluentd (Apache 2.0) : collecte, analyse syntaxique et routage vers plusieurs destinations. Fluent Bit est d'ailleurs la moitié « journaux » de l'agent Ops.
- Vector (MPL 2.0) : collecteur et moteur de transformation de journaux, avec filtrage et échantillonnage en amont du stockage, l'équivalent des filtres d'exclusion d'un puits.
- OpenSearch (Apache 2.0) avec OpenSearch Dashboards : recherche plein texte et tableaux de bord, proche de l'explorateur de journaux pour qui veut de l'indexation complète.
- ClickHouse (Apache 2.0) : base en colonnes souvent employée comme entrepôt de journaux interrogé en SQL, l'équivalent de Log Analytics et de son jeu de données lié.
- OpenTelemetry Collector (Apache 2.0) : ingestion et routage OTLP des journaux, traces et métriques par une seule chaîne de traitement.
- Falco (Apache 2.0) et auditd (GPL v2) : production des événements de sécurité et d'audit que les journaux d'audit fournissent ici sans installation.
Documentation
- Page produit
- Documentation
- Vue d'ensemble
- Routage et stockage
- Buckets de journaux
- Configurer un puits
- Langage de requête
- Log Analytics
- Journaux d'audit
- Métriques basées sur les journaux
- Journalisation structurée
- Agent Ops
- API REST
- Commandes gcloud
- Bibliothèques clientes
- Client Python
- Quotas et limites
- Tarifs
- Notes de version