Cloud Data Fusion
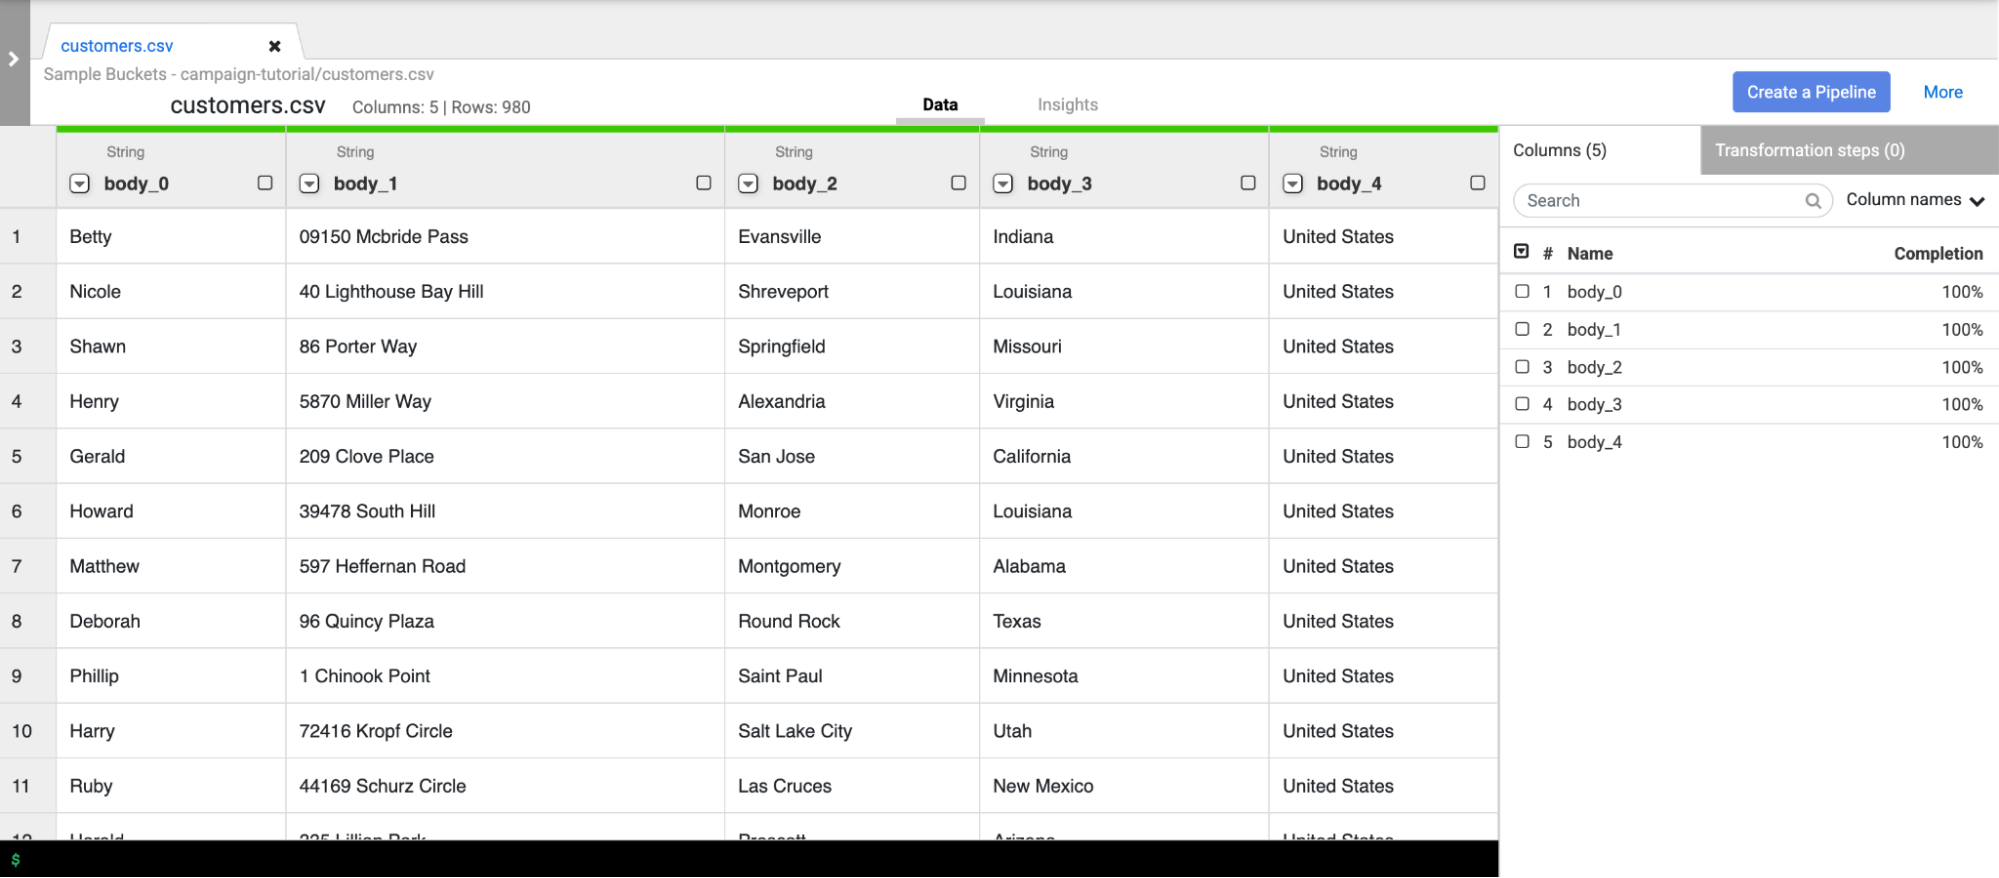
- Conception : le plugin source lit un échantillon, que Wrangler nettoie colonne par colonne
- Les fichiers déjà déposés dans le lac de données servent de seconde source au pipeline
- Au lancement, l'instance provisionne un cluster Managed Spark éphémère, lui soumet le pipeline compilé, puis le supprime
- À l'exécution, les tâches Spark relisent la source par le même plugin
- Écriture des lignes transformées dans les tables cibles
- Publication du lignage, au niveau du jeu de données et du champ, dans Knowledge Catalog
Ce que c'est
Service d'intégration de données graphique : on assemble un pipeline en reliant des nœuds (source, transformation, puits) dans une interface web, sans écrire de code. Il repose sur le projet libre CDAP.
- Instance : l'unité de déploiement, créée dans une région et dans une édition — Developer, Basic ou Enterprise. Les services qui gèrent le cycle de vie des pipelines tournent dans un projet locataire (tenant project) séparé, qui hérite de la configuration réseau du projet client.
- Deux plans : la console pilote l'instance elle-même (création, redémarrage, mise à niveau) ; le Studio est l'interface de conception et d'exécution des pipelines.
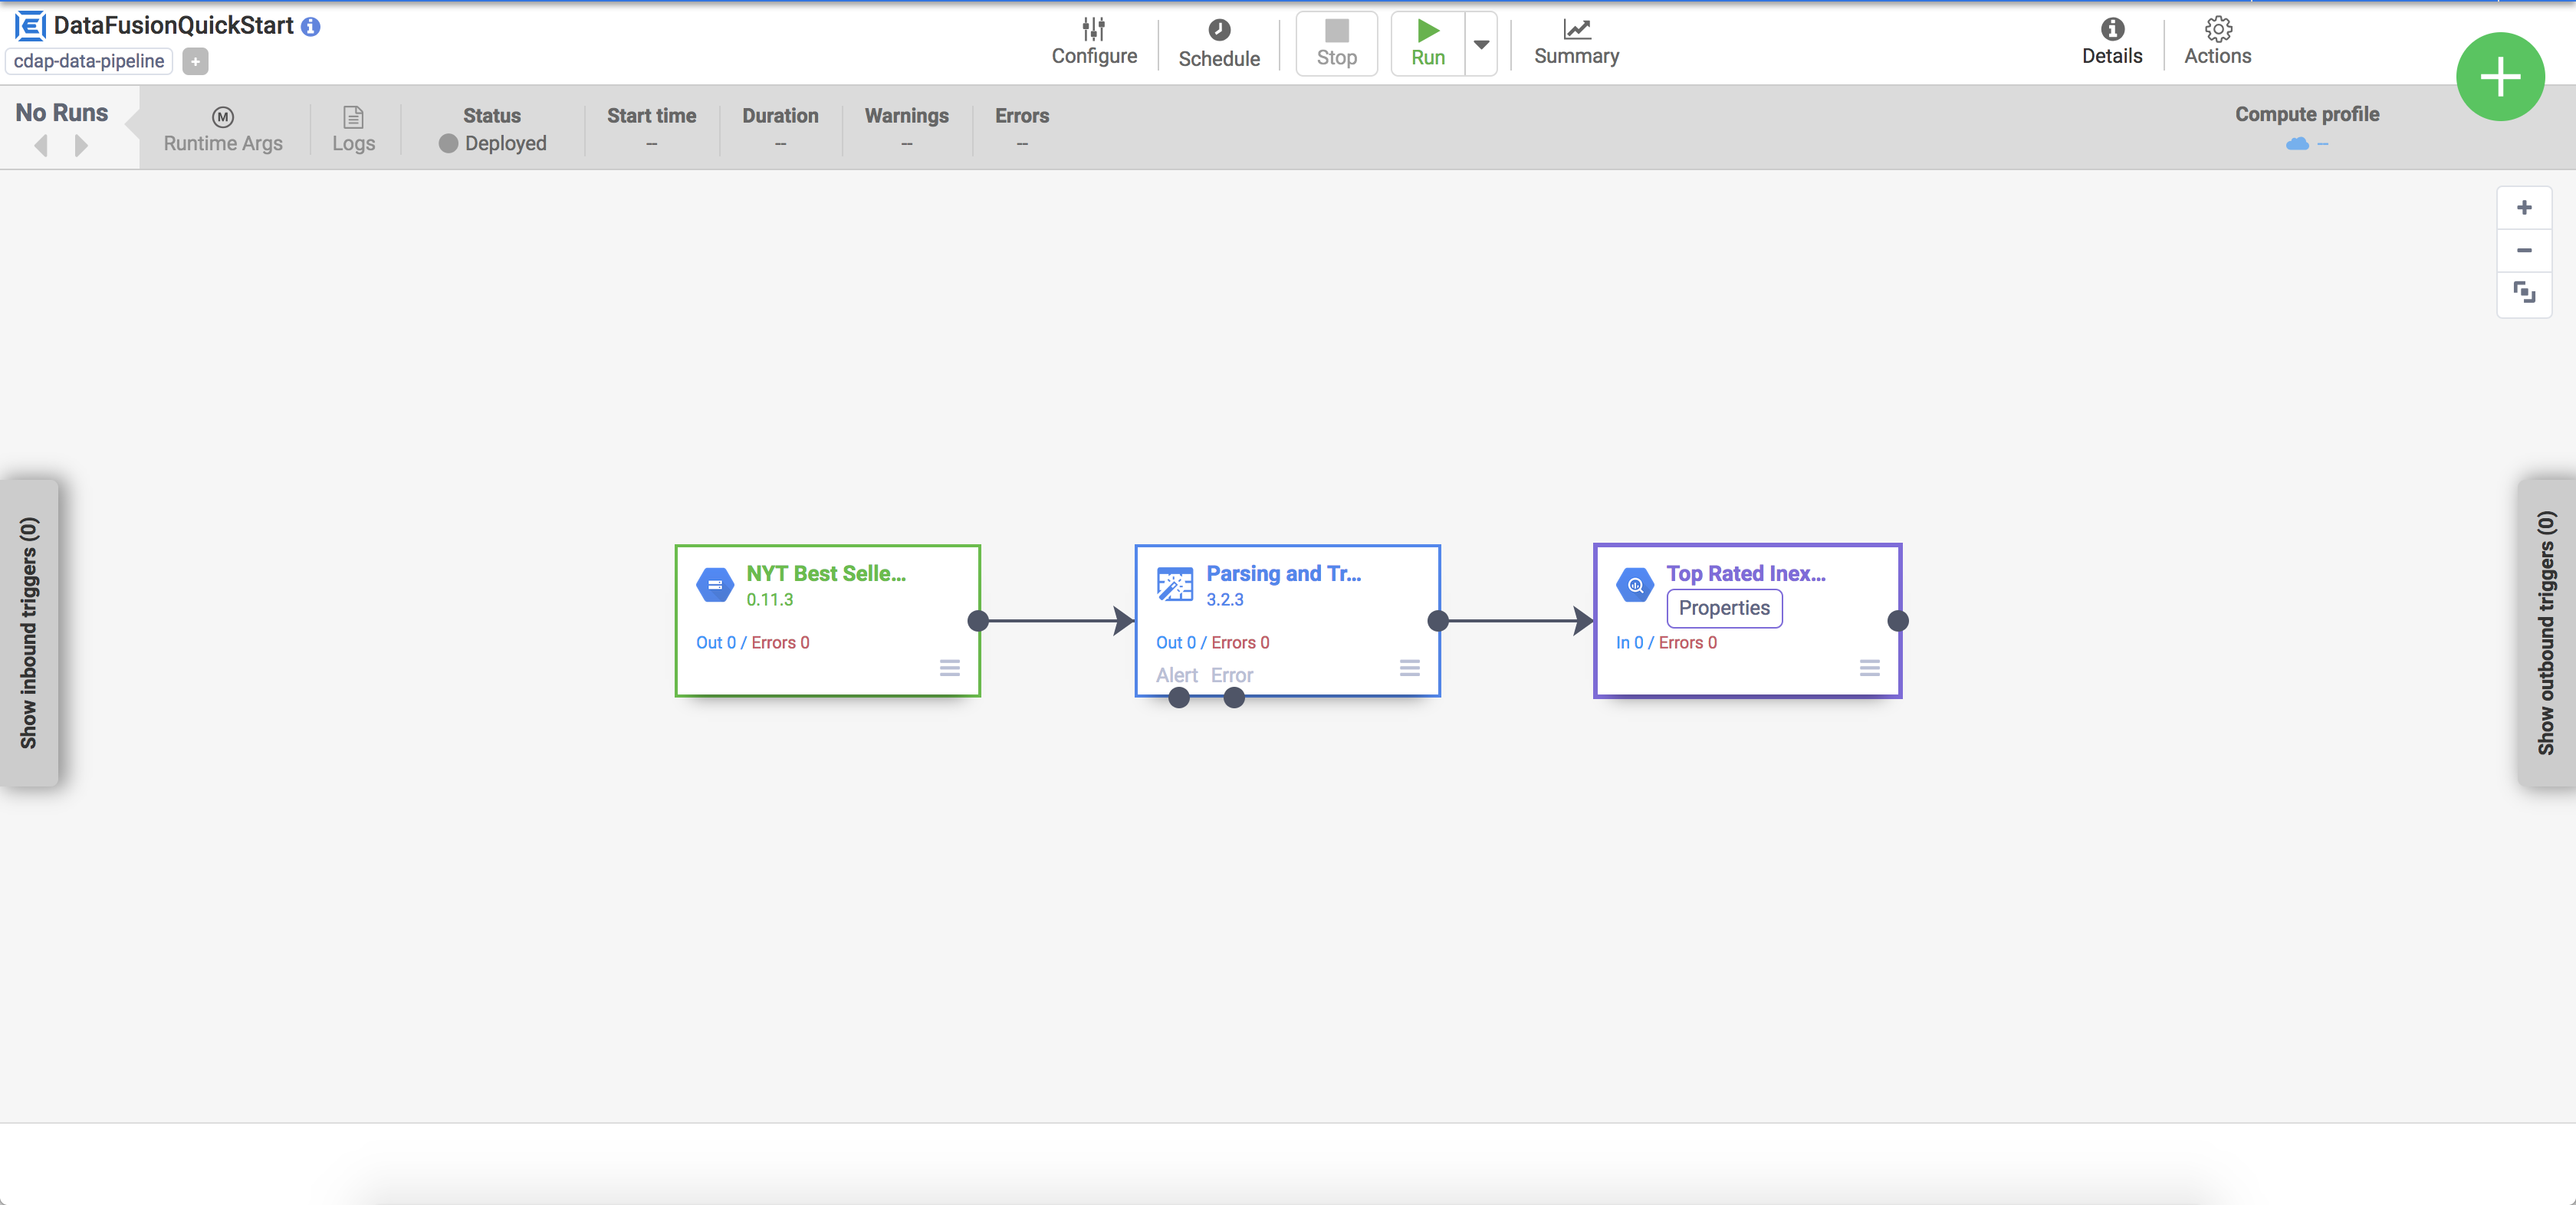
- Pipeline : un graphe orienté acyclique de nœuds. Chaque nœud est un plugin — source par lots ou en flux, transformation, agrégat, puits, collecteur d'erreurs, action. Le Hub liste les plugins disponibles et les pipelines d'exemple.
- Wrangler : préparation interactive sur un échantillon ; la suite de directives produite (la recette) devient un nœud de transformation du pipeline.
- Exécution : le pipeline est compilé en job Spark. Par défaut, Cloud Data Fusion provisionne un cluster Managed Service for Apache Spark éphémère dans le projet client, exécute le pipeline, puis supprime le cluster. Un profil de calcul décrit cet environnement (provisionneur, mémoire, nombre de nœuds). Les transformations peuvent aussi être poussées dans BigQuery (pushdown) plutôt qu'exécutées dans Spark.
- Namespaces : partitions logiques d'une instance, chacune avec ses pipelines, ses métadonnées et son compte de service.
- Facturation : à la minute, du moment où l'instance est créée à celui où elle est supprimée, au tarif de son édition ; l'exécution est facturée à part, au prix des clusters Spark et des autres ressources consommées.
À quoi ça sert
- Ingestion depuis un grand catalogue de systèmes : bases relationnelles, SAP (ERP, BW, ODP, SuccessFactors), Salesforce, ServiceNow, entrepôts tiers.
- Faire construire des pipelines par des profils non développeurs : l'interface, l'aperçu sur un échantillon et Wrangler remplacent le code.
- Migration de traitements ETL existants venus d'outils graphiques comparables.
- Replication : réplication continue d'une base vers BigQuery, configurée en quelques écrans.
À éviter quand l'équipe écrit déjà du code : une instance tourne — et se facture — en continu, même sans pipeline actif. Pour une transformation purement SQL dans BigQuery, préférer Dataform ; pour de la réplication de base de données seule, Datastream ; pour un pipeline de flux sans interface graphique, Dataflow ou Managed Service for Apache Spark.
Le coût d'une instance court tant qu'elle existe, pas seulement pendant les exécutions. Une instance Developer réservée au développement, supprimée entre deux campagnes de travail, évite de payer une édition Enterprise à vide.
Dans la console
Alternatives en logiciel libre
- CDAP : le projet dont Cloud Data Fusion est la version gérée ; même Studio, mêmes plugins, à héberger soi-même.
- Apache NiFi : flux de données graphiques, orientés routage et transformation d'enregistrements en continu.
- Apache Hop : conception visuelle de transformations par lots, l'ETL graphique classique.
- Meltano : connecteurs d'extraction et de chargement, sans transformation graphique.