Bigtable
- Les capteurs publient leurs relevés dans un sujet Pub/Sub
- Dataflow consomme le flux et compose la clé de ligne : identifiant de l'appareil, puis horodatage
- Écriture des cellules horodatées dans la famille de colonnes de la table
- Réplication automatique vers le second cluster de l'instance ; un profil d'application décide du routage
- Le service lit une plage de lignes par préfixe de clé, en quelques millisecondes
- Data Boost exécute les gros balayages sur un calcul serverless, sans consommer les nœuds du cluster
Ce que c'est
Base NoSQL à colonnes larges, conçue pour un très haut débit de lectures et d'écritures par clé, à quelques millisecondes. C'est le système décrit par l'article Bigtable de Google, offert en service géré.
- Modèle de données : une table est une carte triée par clé de ligne. Les colonnes sont regroupées en familles de colonnes ; chaque intersection ligne–colonne contient des cellules horodatées, donc plusieurs versions. Les colonnes non utilisées ne consomment rien : la table est creuse.
- Architecture : une instance contient un ou plusieurs clusters (un par zone), chacun composé de nœuds. La table est découpée en tablets de lignes contiguës, stockés sur Colossus au format SSTable. Les nœuds ne contiennent pas les données, seulement des pointeurs : rééquilibrer ou remplacer un nœud est rapide et ne perd rien.
- Réplication : ajouter un cluster suffit, la réplication démarre seule. Les profils d'application décident du routage : un seul cluster (cohérence forte) ou le cluster disponible le plus proche (cohérence à terme, ou lecture de ses propres écritures selon la configuration).
- Disponibilité : 99,9 % pour une instance à un seul cluster ou en routage mono-cluster, 99,99 % avec routage multi-cluster, 99,999 % à partir de trois régions.
- Performance : un nœud SSD sert jusqu'à 17 000 lectures et 14 000 écritures par seconde, à moins de 5 ms.
- Accès : bibliothèques clientes, extension de la bibliothèque Apache HBase pour Java, CLI
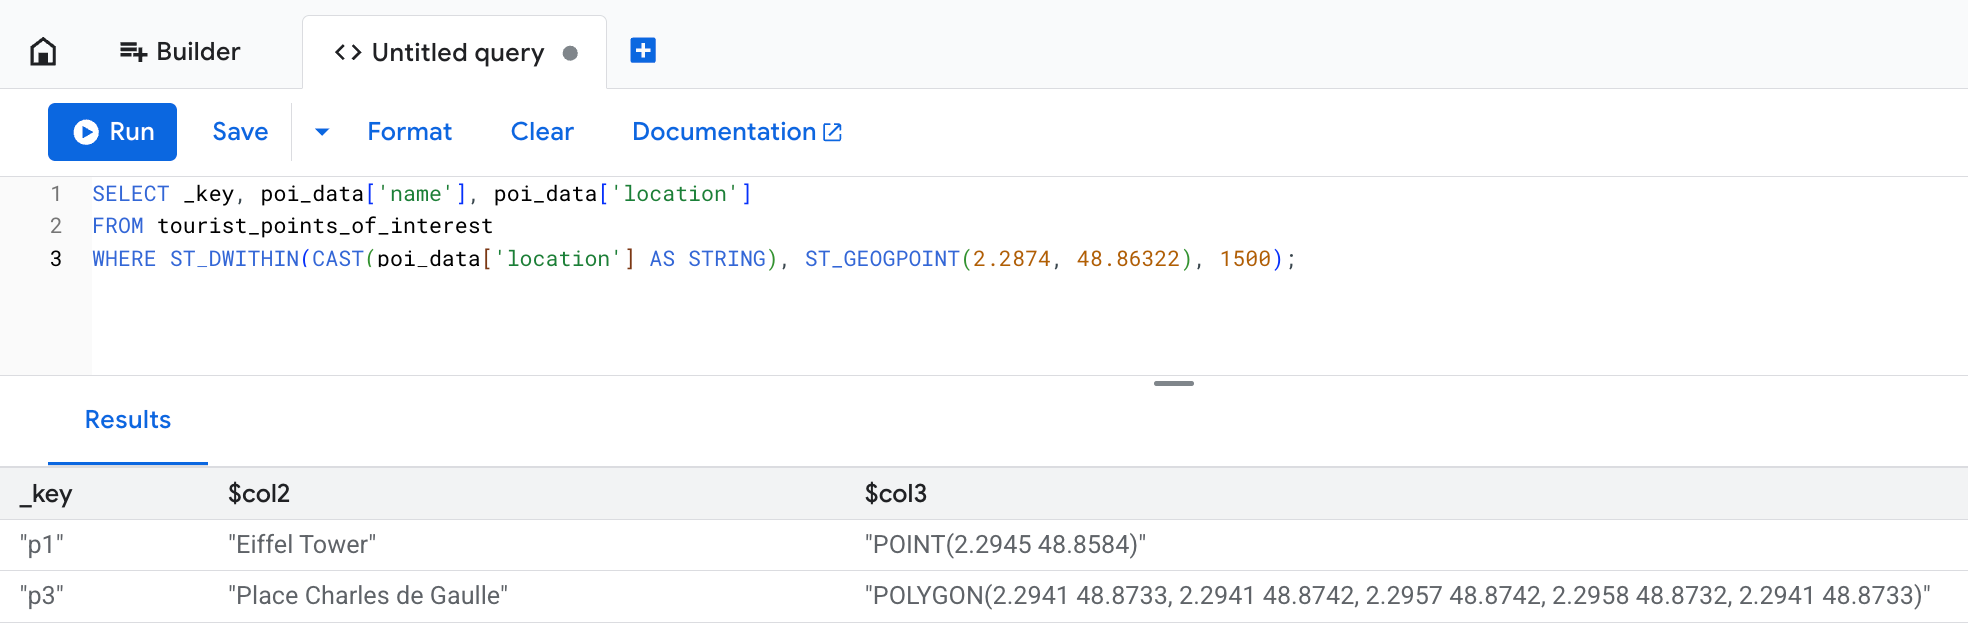
cbt, et requêtes GoogleSQL depuis Bigtable Studio. - Calcul séparé : Data Boost exécute les gros travaux de lecture sur un calcul serverless, sans toucher aux nœuds qui servent l'application.
- Deux éditions : Enterprise pour l'usage courant, Enterprise Plus pour la lecture ponctuelle sous la milliseconde (niveau en mémoire), une densité de stockage par nœud plus élevée et le SQL sur Data Boost.
- Facturation : nœuds provisionnés (ou autoscaling), stockage SSD ou HDD, sauvegardes et sortie réseau.
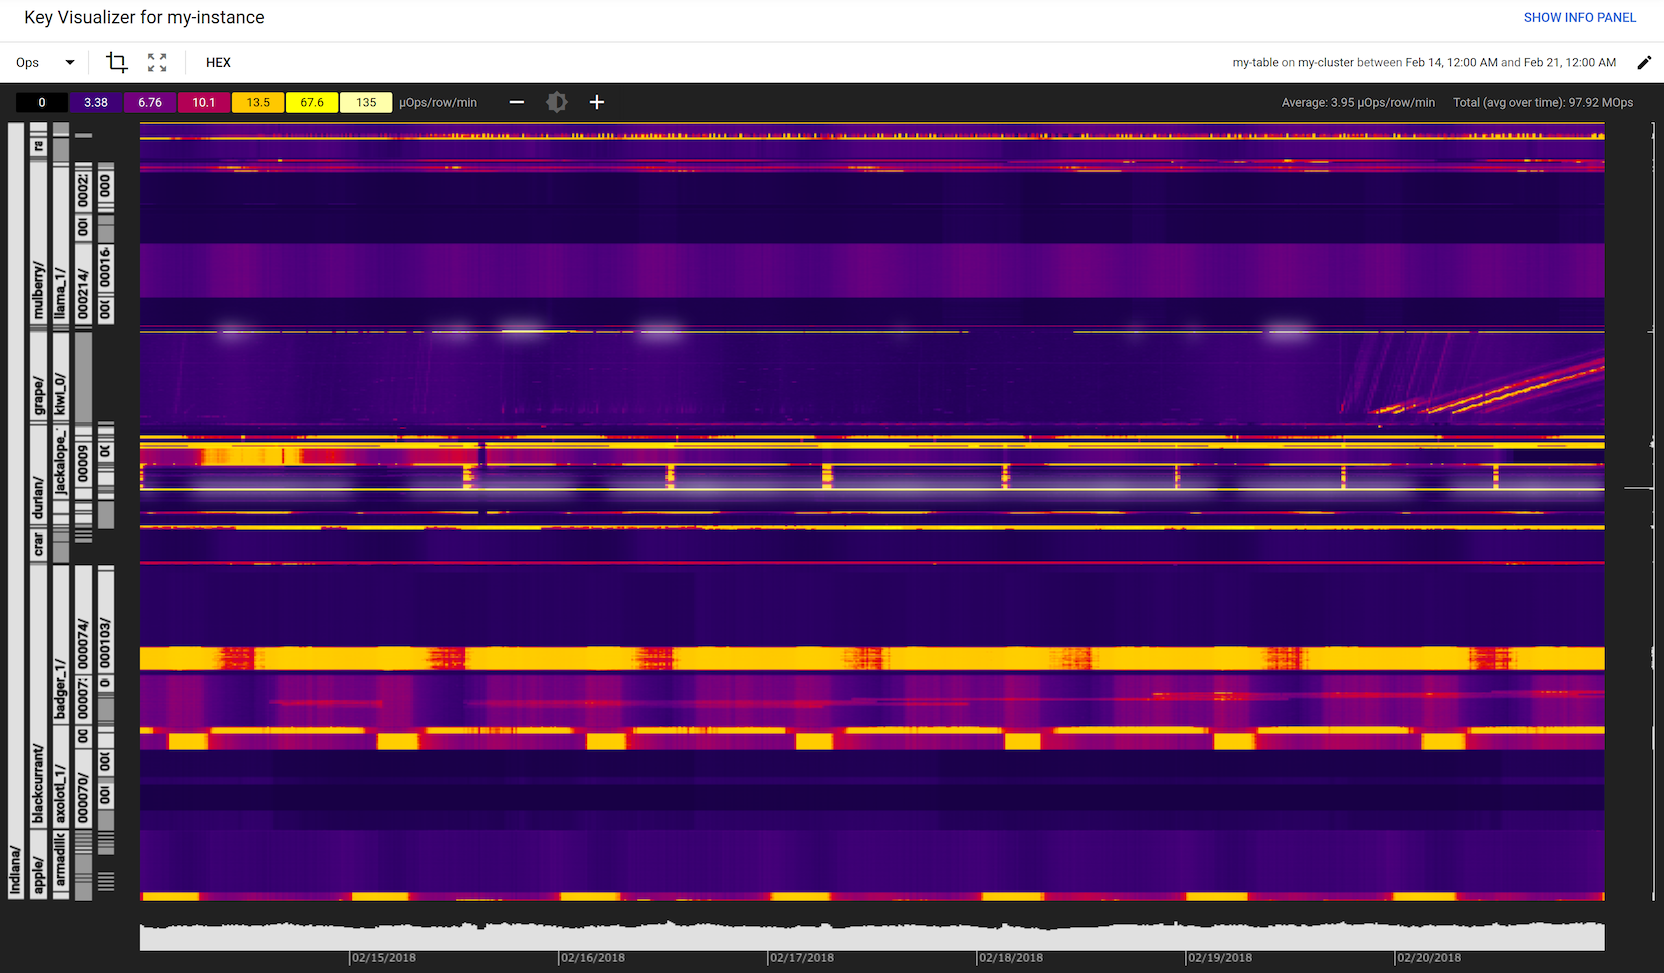
Tout se joue sur la clé de ligne. Une clé qui commence par un horodatage ou un compteur envoie toutes les écritures du moment sur le même tablet, donc sur un seul nœud : le cluster entier attend ce nœud. Faire précéder l'horodatage d'un identifiant bien réparti, et vérifier le résultat dans Key Visualizer.
À quoi ça sert
- Séries temporelles à gros volume : supervision, compteurs, relevés IoT, cours financiers.
- Historiques par entité lus par plage de clés : parcours d'un utilisateur, transactions d'un compte, événements d'un appareil.
- Moteur de stockage de traitements par lots ou en flux (Dataflow, Spark) et de charges d'apprentissage.
- Migration depuis Apache HBase ou Cassandra, quand on veut garder le modèle sans exploiter le cluster.
À éviter quand il faut des transactions sur plusieurs lignes, des jointures ou des index secondaires généraux : préférer Spanner ou Cloud SQL. À éviter aussi pour l'analyse ad hoc sur l'historique complet, qui revient moins cher dans BigQuery, et pour des valeurs de plus de quelques mégaoctets, qui ont leur place dans Cloud Storage. Voir Choisir une base de données.
Dans la console
Alternatives en logiciel libre
- Apache HBase : la mise en œuvre libre du même modèle, sur HDFS ; Bigtable en propose d'ailleurs l'API.
- Apache Cassandra : colonnes larges également, avec une réplication multi-nœuds sans maître.
- Apache Accumulo : proche de HBase, avec en plus une sécurité au niveau de la cellule.
- Apache Phoenix : couche SQL au-dessus de HBase, comme GoogleSQL au-dessus de Bigtable.
- Apache HBase + OpenTSDB : la variante spécialisée séries temporelles.