BigQuery
- Dépôt des fichiers (CSV, Parquet, Avro) dans un bucket
- Chargement par lots (bq load, gratuit) ou lecture directe en table externe
- Publication des événements en continu
- Abonnement BigQuery : les messages sont écrits directement dans une table
- Requêtes SQL des tableaux de bord et des analystes
- BigQuery ML et appels aux modèles Gemini depuis le SQL
Ce que c'est
Entrepôt de données analytique serverless : aucune instance à dimensionner, on crée des datasets et des tables, puis on interroge en SQL (dialecte GoogleSQL).
- Stockage et calcul séparés. Les tables sont stockées en format colonnes sur le stockage distribué de Google ; les requêtes s'exécutent sur un moteur massivement parallèle qui alloue dynamiquement des unités de calcul, les slots.
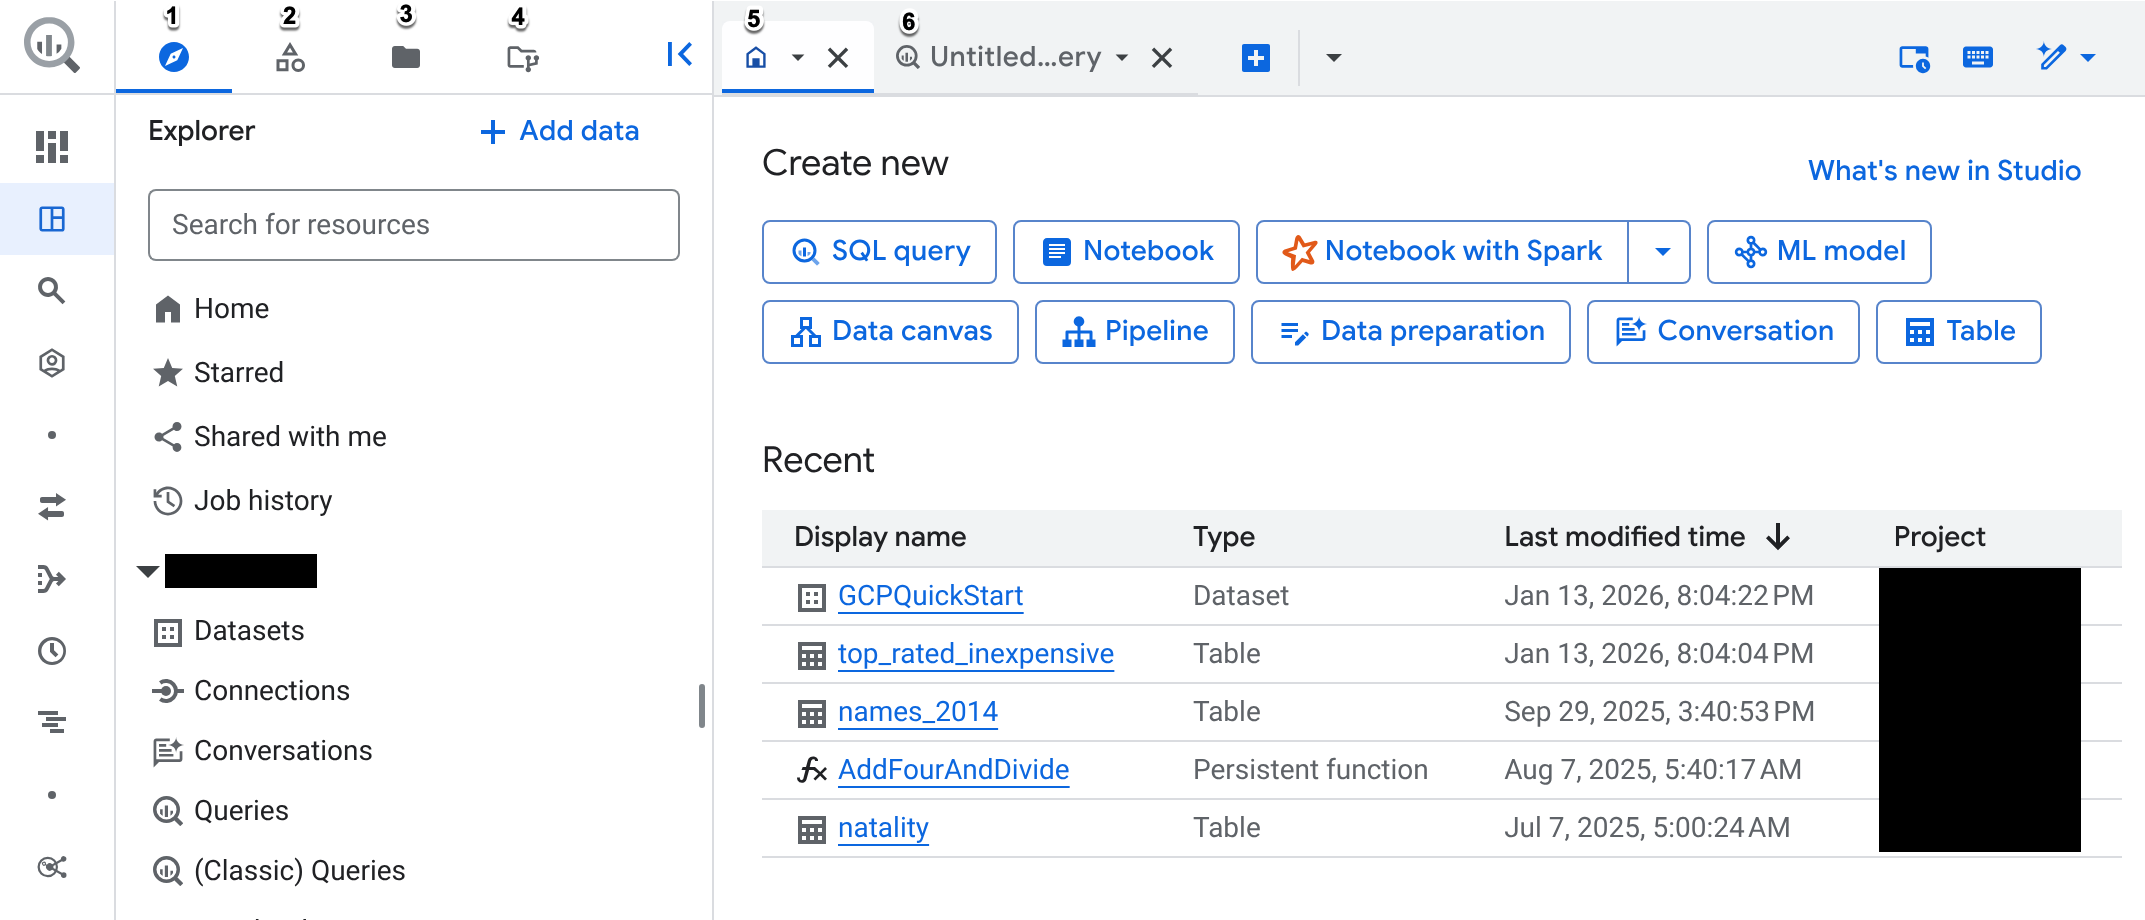
- Organisation : projet → dataset (porte la région et les droits) → tables, vues, vues matérialisées, fonctions, modèles.
- Ingestion : chargement par lots depuis Cloud Storage (gratuit), écriture en continu par la Storage Write API, abonnement Pub/Sub vers BigQuery, transferts planifiés (BigQuery Data Transfer Service).
- Données externes : tables externes et tables BigLake sur des fichiers de Cloud Storage (Parquet, ORC, Avro, Iceberg), requêtes fédérées vers Cloud SQL, AlloyDB et Spanner.
- Au-delà du SQL : BigQuery ML pour entraîner et appeler des modèles en SQL, notebooks et DataFrames Python, accélération en mémoire par BI Engine.
- Facturation : stockage au volume (moins cher après 90 jours sans modification) ; calcul soit à la demande (au volume lu par la requête), soit en capacité (éditions, facturées en slots).
À quoi ça sert
- Entrepôt de données central : historique de l'entreprise, reporting, tableaux de bord (Looker, Data Studio, Connected Sheets).
- Analyse ad hoc sur de gros volumes, du gigaoctet au pétaoctet, sans administration.
- Destination de pipelines batch et streaming (Dataflow, Pub/Sub, Datastream).
- Machine learning et IA générative au plus près des données, en SQL.
À éviter pour un usage transactionnel : mises à jour unitaires fréquentes, lectures ponctuelles par clé à la milliseconde. Préférer Cloud SQL, AlloyDB ou Spanner pour les transactions, Bigtable pour les accès par clé à très faible latence (voir Choisir une base de données).
Le coût d'une requête à la demande dépend des colonnes lues, pas des lignes renvoyées :
SELECT *suivi deLIMIT 10lit toute la table. Partitionner et clusteriser les tables réduit le volume lu.
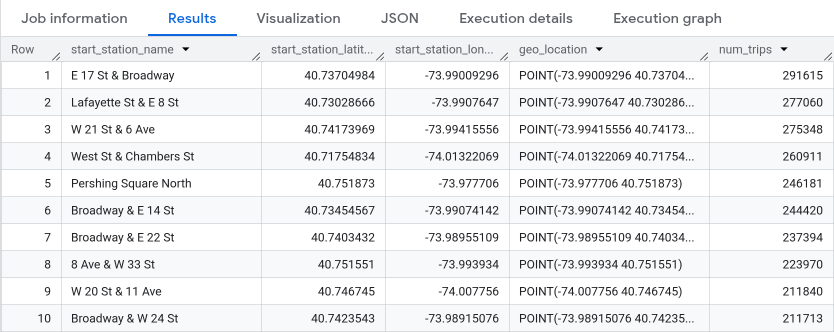
Dans la console
Alternatives en logiciel libre
- ClickHouse : base analytique en colonnes, très rapide sur les agrégations ; la plus proche en usage.
- Trino + Apache Iceberg : moteur SQL distribué sur des tables ouvertes stockées dans un object storage ; l'équivalent d'un lakehouse BigQuery + BigLake.
- Apache Druid, Apache Pinot : analytique temps réel à faible latence sur des flux.
- Apache Doris, StarRocks : entrepôts MPP compatibles MySQL.
- DuckDB : moteur analytique embarqué, pour des volumes qui tiennent sur une machine.