AlloyDB for PostgreSQL
- L'application se connecte au point de terminaison privé de l'instance, par le connecteur de langage ou l'AlloyDB Auth Proxy
- Les requêtes en lecture seule vont au pool de lecture, qui lit la même couche de stockage et se répartit la charge
- Depuis le SQL, l'extension google_ml_integration appelle un modèle pour produire des embeddings, indexés par ScaNN
- Sauvegarde continue du cluster : restauration vers n'importe quel instant de la fenêtre de rétention
- Réplication asynchrone vers un cluster secondaire d'une autre région, promouvable en cluster principal
Ce que c'est
Base compatible PostgreSQL dont Google a réécrit le moteur et le stockage, pour les charges transactionnelles exigeantes. Les applications, les pilotes et les extensions PostgreSQL fonctionnent sans changement ; l'architecture, elle, n'est plus celle d'un serveur PostgreSQL.
- Calcul et stockage séparés. Les nœuds de calcul exécutent les requêtes ; une couche de stockage distribuée, répartie sur plusieurs zones, conserve les données et grandit toute seule.
- Hiérarchie : cluster (conteneur régional des bases) → instances (points de connexion) → nœuds (les VM). L'instance principale, unique par cluster, porte les écritures ; les pools de lecture ajoutent des instances en lecture seule, dont la charge est répartie entre les nœuds.
- Haute disponibilité par défaut : l'instance principale tient sur deux nœuds dans deux zones, avec bascule automatique. SLA de 99,99 % dans la plupart des régions. La maintenance est préparée sur des serveurs de remplacement, ce qui la ramène en général sous la seconde d'indisponibilité.
- Moteur en colonnes : une représentation des données en colonnes, tenue en mémoire, qui accélère les requêtes analytiques sur les tables transactionnelles, sans copie vers un autre système.
- Réglage automatique : conseiller d'index, autovacuum adaptatif, gestion automatique de la mémoire et du stockage.
- AlloyDB AI : l'extension
vector(variante de pgvector), l'indexalloydb_scannpour la recherche approximative de voisins,google_ml_integrationpour appeler un modèle depuis le SQL,alloydb_ai_nlpour interroger la base en langage naturel. - Reprise : sauvegarde continue avec restauration à un instant donné, sauvegardes complètes planifiées, clusters secondaires inter-régions.
- AlloyDB Omni : le même moteur, téléchargeable, exécutable sur n'importe quel environnement Linux.
- Facturation : vCPU et mémoire des instances, stockage consommé, sortie réseau.
À quoi ça sert
- PostgreSQL sous forte charge, quand une instance Cloud SQL ne suit plus et qu'on ne veut ni changer de moteur ni redécouper l'application.
- Croiser transactions et analyse dans la même base (HTAP) : tableaux de bord et agrégats calculés sur les données vivantes grâce au moteur en colonnes.
- Applications d'IA générative : embeddings, recherche vectorielle et appels de modèles sans sortir les données de la base.
- Migration d'un PostgreSQL existant ou d'une base propriétaire, avec Database Migration Service.
À éviter pour une petite base ou un environnement de test : le cluster réserve au minimum un nœud de calcul et coûte plus cher que la même chose en Cloud SQL. À éviter aussi quand il faut du MySQL ou du SQL Server (Cloud SQL), quand les écritures doivent se répartir sur plusieurs régions (Spanner), ou pour un entrepôt analytique à part entière (BigQuery).
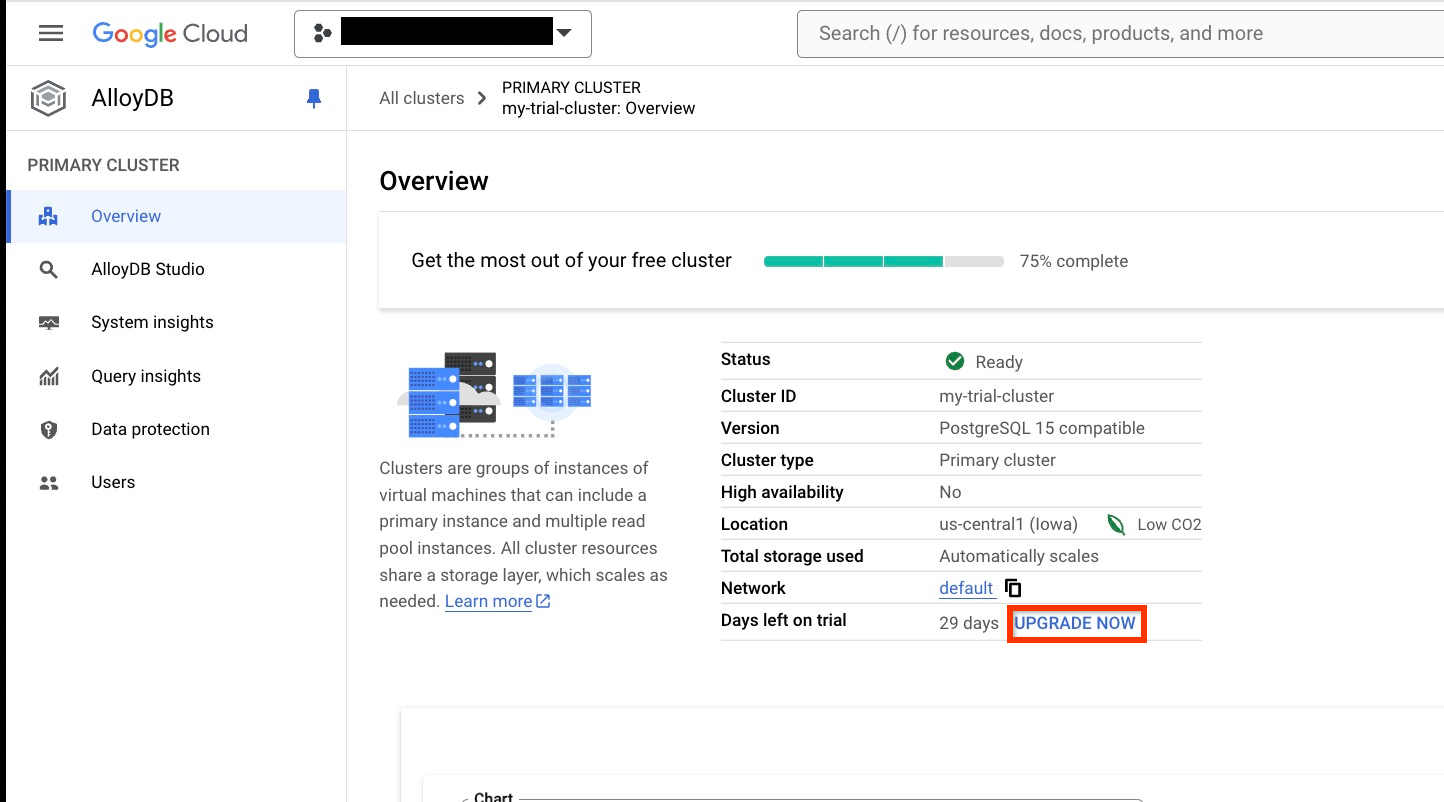
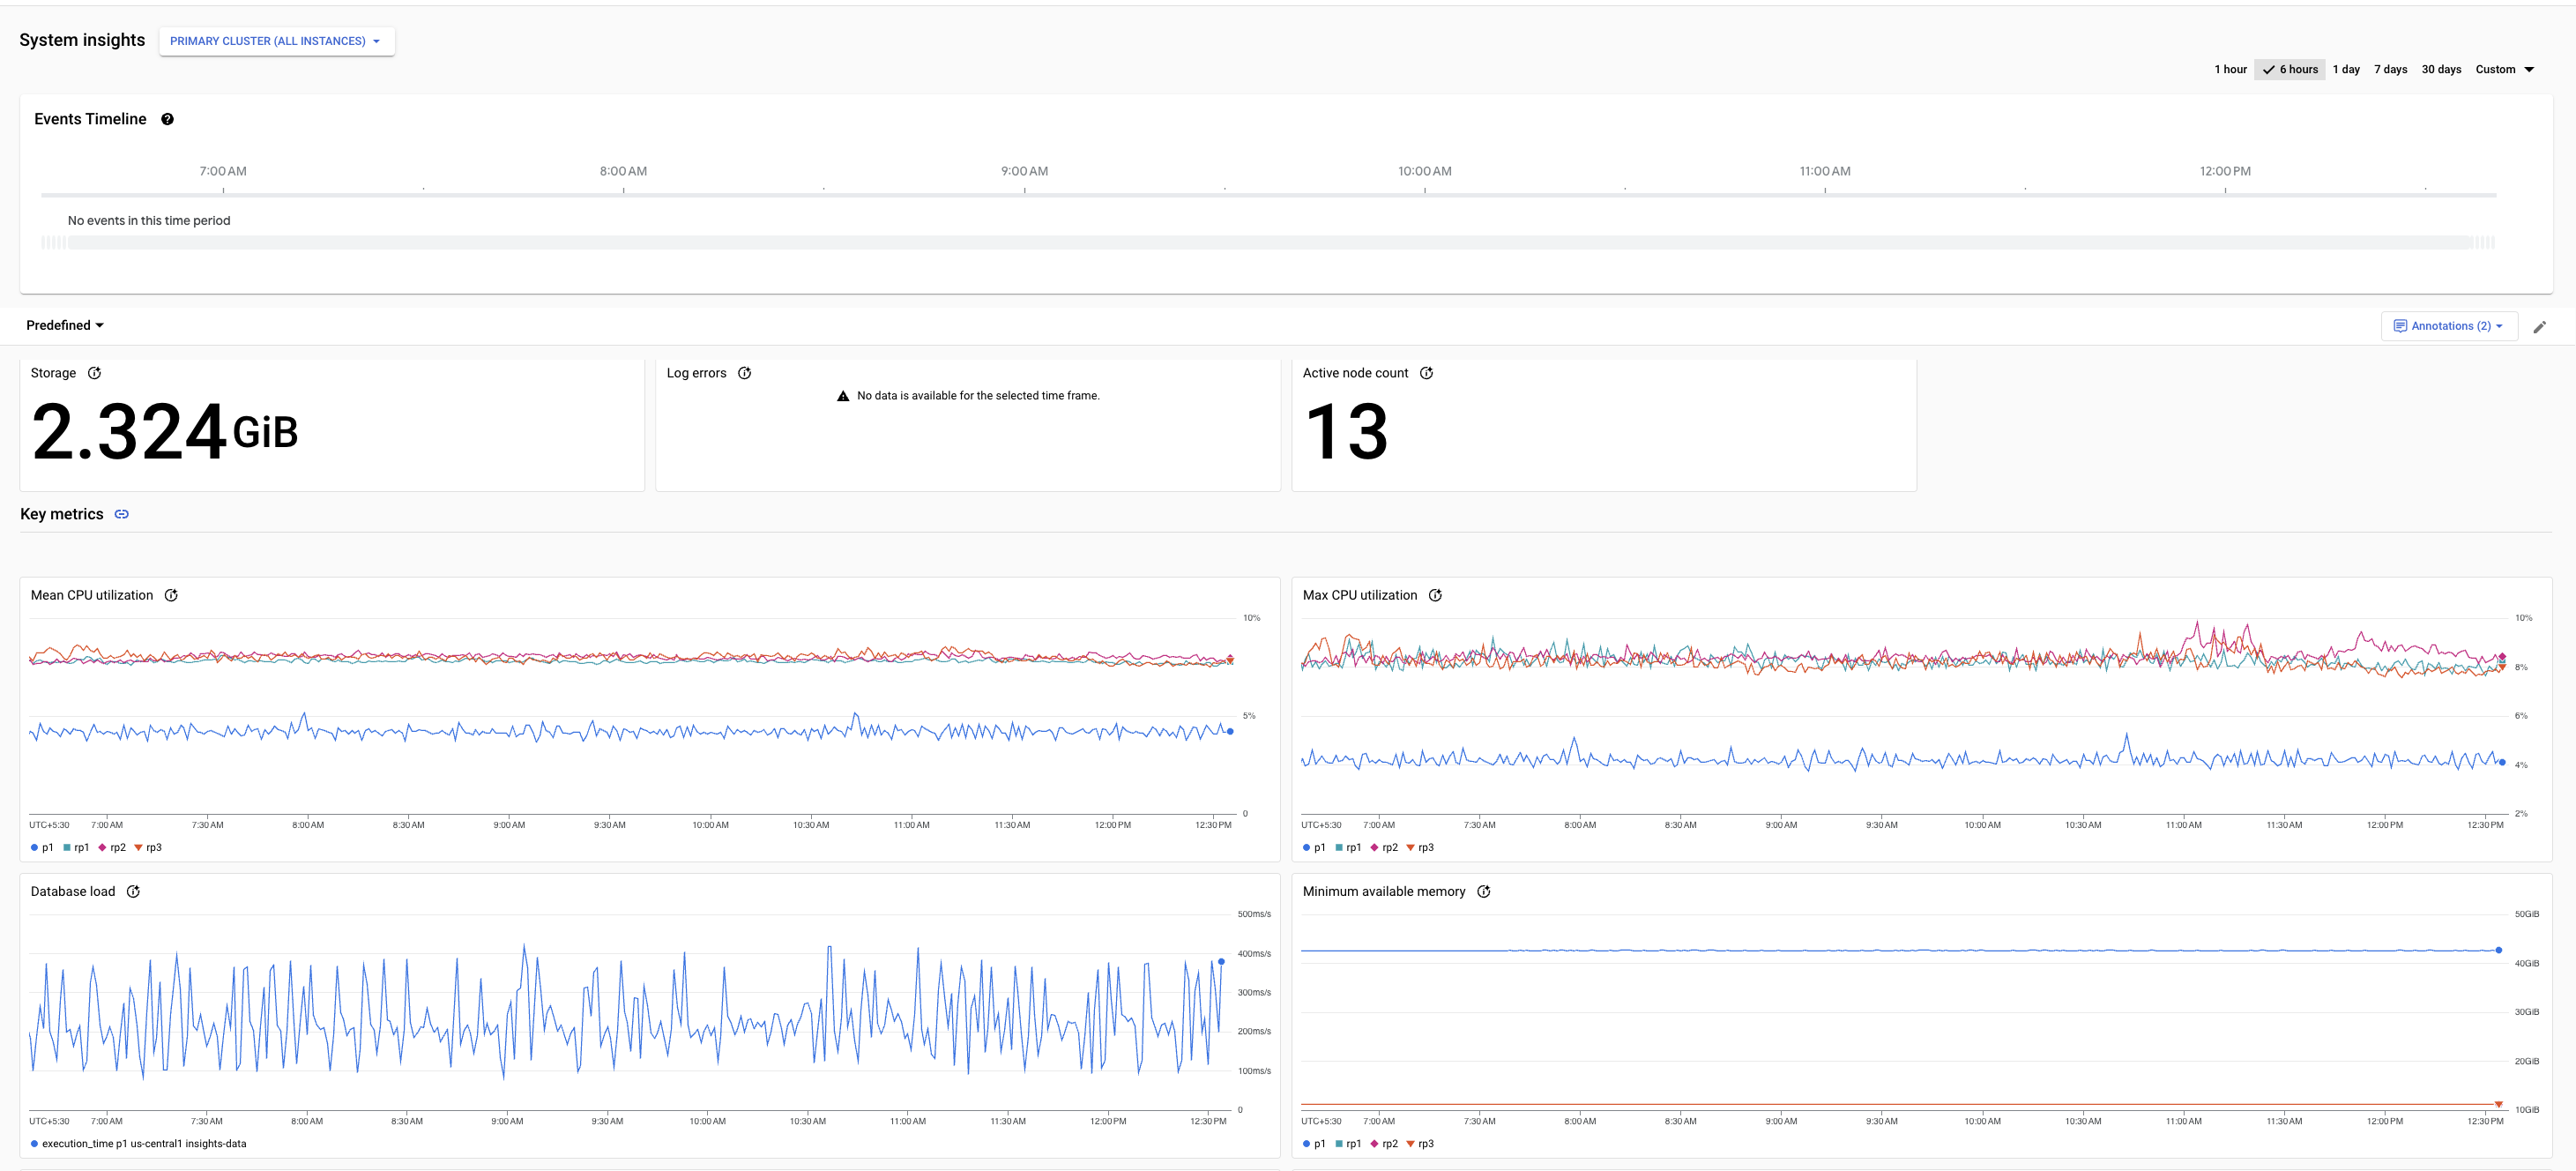
Dans la console
Alternatives en logiciel libre
- PostgreSQL autohébergé, avec CloudNativePG ou Patroni pour la haute disponibilité : la compatibilité est totale dans ce sens, puisque AlloyDB parle PostgreSQL.
- pgvector : l'extension de recherche vectorielle dont dérive celle d'AlloyDB.
- Citus : extension PostgreSQL de répartition des tables sur plusieurs nœuds, pour l'échelle horizontale.
- DuckDB via l'extension pg_duckdb, ou Apache Doris à côté de la base : l'accélération analytique en colonnes, en pièces détachées.
- Apache AGE, PostGIS, pg_cron : les extensions qui spécialisent un PostgreSQL vers un usage donné, là où AlloyDB en intègre certaines d'office.