Tri des tickets
Code de l'exemple : src/exemplia/tri_tickets/ sur GitHub
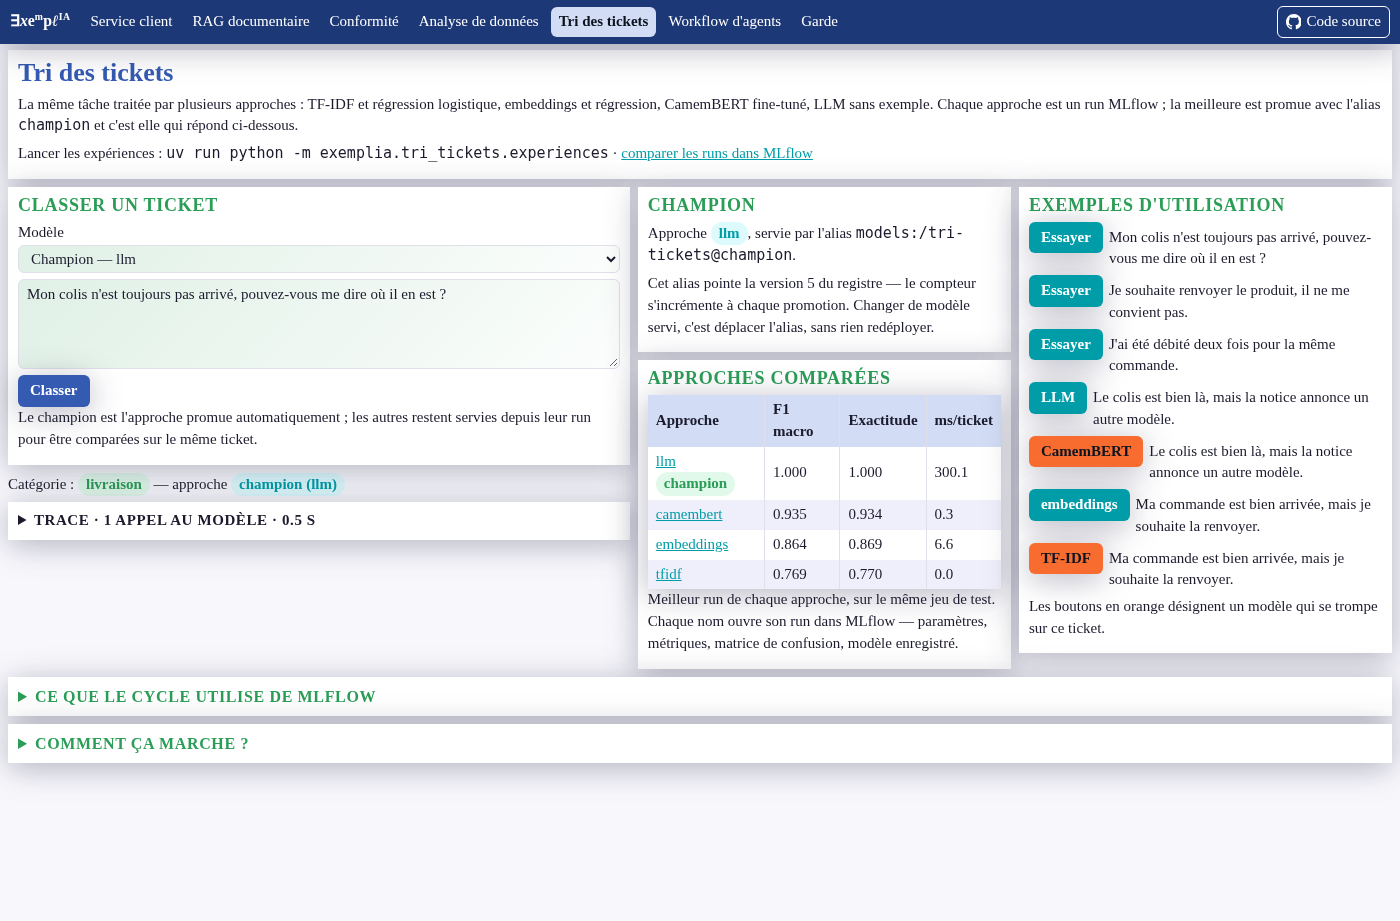
Classification des demandes du service client en cinq catégories, traitée par plusieurs approches comparées dans MLflow. Montre le cycle MLOps complet et répond à une question fréquente : faut-il un LLM, ou un modèle classique suffit-il ?
Approches
| Approche | Principe | Entraînement | Inférence |
|---|---|---|---|
tfidf |
TF-IDF (mots et paires de mots) + régression logistique | secondes, CPU | < 1 ms, CPU |
embeddings |
Embeddings du serveur de modèles + régression logistique | embeddings des 240 tickets | un appel d'embedding |
camembert |
CamemBERT fine-tuné (20 époques) | ~15 s, GPU | < 1 ms, GPU |
llm |
LLM sans exemple, prompt versionné, sortie structurée | aucun | un appel au LLM |
Jeu commun : 300 tickets, environ 80 % entraînement et 20 % test, stratifiés par catégorie. Les tickets sont produits à partir de 14 formulations par catégorie, avec des demandes qui touchent deux sujets et du bruit (minuscules, accents absents, fautes de frappe). La séparation se fait par formulation : le test ne contient que des tournures absentes de l'entraînement. Un découpage aléatoire placerait des quasi-doublons des deux côtés et donnerait au TF-IDF un score proche de 1 qui ne dit rien de sa tenue sur de nouveaux messages.
Limites
- Les tickets sont générés à partir de modèles de phrases : moins variés que de vrais tickets, donc les écarts mesurés valent pour ce jeu.
fine_tuning.py --promouvoirrejoue la règle de promotion sur tous les runs de l'expérience ; sans l'option, le run est seulement enregistré et se compare dans l'interface MLflow.- Le modèle de base est
almanach/camembert-base: avec transformers 5.x, le tokenizer decamembertv2-basedécoupe le texte caractère par caractère et le modèle n'apprend pas. - La latence mesurée inclut le réseau pour les approches servies (embeddings, LLM).
La suite : Comment ça marche ? · Comment utiliser ? · Évaluation.