Comment ça marche ? Tri des tickets
Code de l'exemple : src/exemplia/tri_tickets/ sur GitHub
300 tickets étiquetés (5 catégories)
      │ séparation par formulation : le test ne contient que des tournures
      │ absentes de l'entraînement
      ├──► TF-IDF + régression logistique        ─┐
      ├──► embeddings + régression logistique     │  un run MLflow chacun :
      ├──► CamemBERT fine-tuné (GPU)              ├─ F1 macro, exactitude, latence,
      └──► LLM sans exemple, prompt versionné    ─┘  matrice de confusion, modèle
                                │
              promotion : meilleur F1 ; à un point près, le plus rapide gagne
                                │
        Model Registry « tri-tickets » : nouvelle version, alias « champion »
                                │
                 l'application charge models:/tri-tickets@champion
Ce que montre la comparaison
Sur des formulations jamais vues à l'entraînement, le LLM sans exemple classe parfaitement, pour 300 ms par ticket. CamemBERT fine-tuné en quinze secondes atteint 0,935 pour 0,26 ms. Sur un volume élevé, c'est ce compromis qu'il faut regarder en premier.
Changer de modèle servi ne demande pas de redéploiement : l'alias champion se déplace d'une
version à l'autre.
Briques
| Brique | Rôle |
|---|---|
| scikit-learn | TF-IDF, régression logistique, métriques |
| transformers (GPU) | Fine-tuning de almanach/camembert-base |
| Ollama | Embeddings et classification sans exemple |
| MLflow Tracking | Un run par approche, mêmes métriques |
| MLflow Prompt Registry | Prompt de classification versionné, référencé par le modèle |
| MLflow Model Registry | Versions du modèle et alias champion |
Cycle MLOps
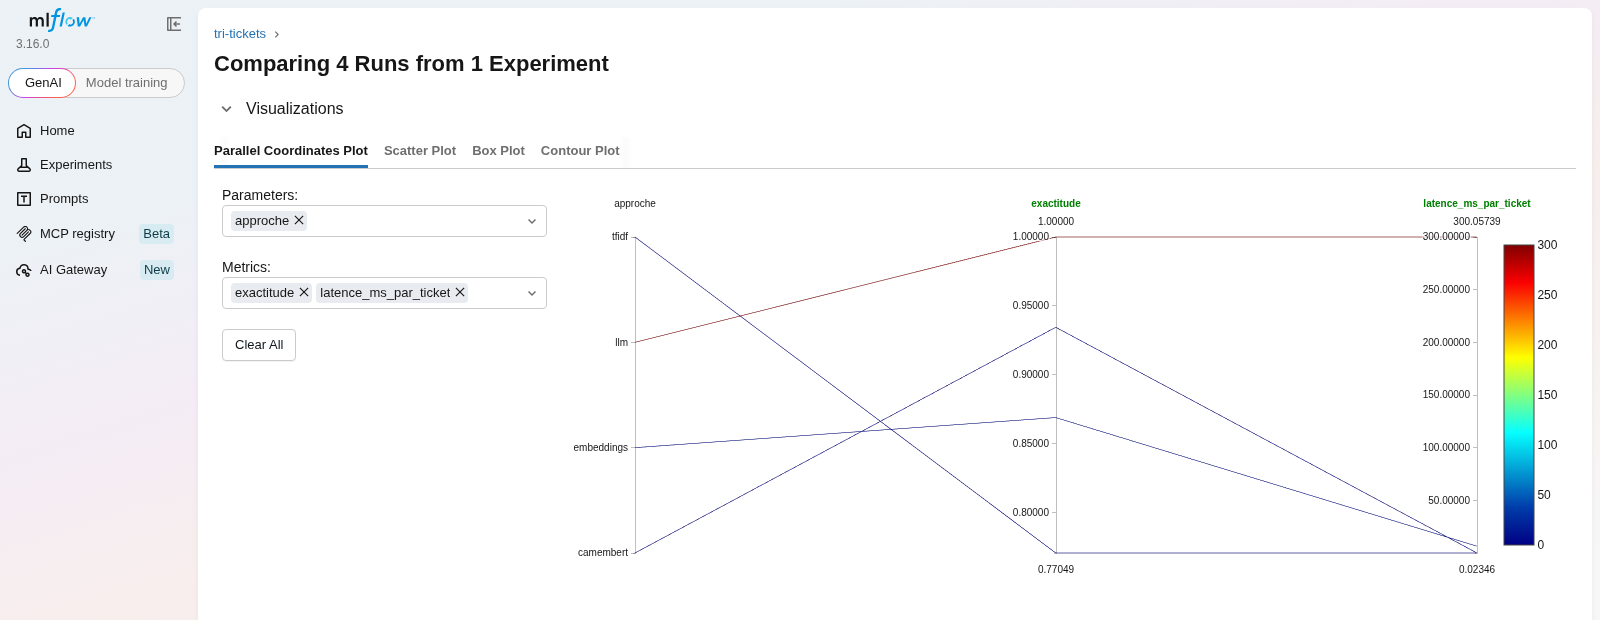
Page de comparaison de MLflow, atteinte depuis la page /tri-tickets : les quatre runs, approche
en paramètre, exactitude et latence en métriques. Chaque approche y garde ses artefacts — matrice de
confusion, rapport de classification, modèle enregistré.
Composants de l'exemple
L'exemple a deux chemins : la prédiction, servie par la page web, et le cycle d'expériences, lancé en ligne de commande, qui produit les modèles que la page charge.
Prédiction dans la page web
flowchart TD
  classDef externe fill:#fed7aa,stroke:#ea580c,color:#7c2d12
  classDef code fill:#ffffff,stroke:#6b7280,color:#1f2937
  classDef gpu fill:#fecaca,stroke:#dc2626,color:#7f1d1d
  classDef disque fill:#dcfce7,stroke:#16a34a,color:#14532d

  Nav["navigateur<br/>page /tri-tickets, HTMX"]
  subgraph Py["Processus Python : uv run exemplia"]
    Web["web.py<br/>GET /tri-tickets<br/>POST /tri-tickets/predire"]
    Mod["modèle pyfunc chargé<br/>TF-IDF, ClassifieurEmbeddings,<br/>ClassifieurLLM ou CamemBERT"]
  end
  Torch["PyTorch, transformers<br/>CamemBERT fine-tuné"]
  Ollama["Ollama (hôte)<br/>qwen3.5:9b<br/>qwen3-embedding:0.6b"]
  MLflow[("MLflow<br/>conteneur Docker<br/>runs, registres, traces")]

  Nav -- "① HTTP GET<br/>/tri-tickets" --> Web
  Web -- "② HTTP, API REST<br/>runs, alias champion" --> MLflow
  Nav -- "③ HTTP POST<br/>texte, approche" --> Web
  MLflow -- "④ HTTP, 1re fois<br/>artefacts du modèle" --> Mod
  Web -- "⑤ appel Python<br/>predict, client journalisé" --> Mod
  Mod -. "⑥ appel Python<br/>pipeline text-classification" .-> Torch
  Mod -. "⑦ HTTP, 1re prédiction<br/>prompt tri-tickets-zero-shot" .-> MLflow
  Mod -. "⑧ HTTP POST<br/>/v1/embeddings ou<br/>/v1/chat/completions" .-> Ollama
  Web -. "⑨ HTTP<br/>traces des appels OpenAI" .-> MLflow
  Web -- "⑩ fragment HTML<br/>catégorie, score, mesure" --> Nav

  class Nav externe
  class Web,Mod code
  class Torch,Ollama gpu
  class MLflow disque
uv run exemplia démarre l'application FastAPI ; le routeur de web.py sert la page
/tri-tickets. Il ne lit ni PostgreSQL ni fichier local : runs, modèles et prompt sont lus dans le
serveur MLflow (IACU_MLFLOW_TRACKING_URI, http://localhost:5000 par défaut).
- ① Ouverture de la page. Le navigateur demande
/tri-tickets; la page contient le formulaire de prédiction et les tickets d'exemple. - ② État de MLflow.
_etat_mlflowinterroge MLflow par son API REST : runs de l'expériencetri-tickets(search_runs, meilleur F1 par approche) et version du modèletri-ticketsqui porte l'aliaschampion. La page affiche la comparaison et les liens vers MLflow ; la même lecture est refaite à chaque prédiction. - ③ Demande de prédiction. HTMX envoie le texte du ticket et l'approche choisie :
champion, ou l'identifiant du meilleur run d'une approche. - ④ Chargement du modèle.
mlflow.pyfunc.load_modeltélécharge les artefacts demodels:/tri-tickets@championouruns:/<run_id>/modele; le modèle chargé est gardé en mémoire par référence (lru_cache). - ⑤ Prédiction. Sous
mesurer,_brancher_clientdonne aux modèles qui appellent un serveur (embeddings, LLM) unClientJournalqui compte les appels et retient les échanges, puispredict([texte])est appelé. Le pipeline TF-IDF calcule tout dans le processus, avec scikit-learn. - ⑥ CamemBERT. Le modèle enregistré avec
mlflow.transformersest un pipelinetext-classificationexécuté par PyTorch dans le processus ; il renvoie l'étiquette et un score. - ⑦ Prompt versionné.
ClassifieurLLMlit à sa première prédiction le gabarit référencé par son URI dans le Prompt Registry (tri-tickets-zero-shot), puis le garde en mémoire. - ⑧ Appel au serveur de modèles.
ClassifieurEmbeddingsenvoie le texte à/v1/embeddingspuis applique sa régression logistique ;ClassifieurLLMenvoie le prompt, ticket encadré pardelimiter, à/v1/chat/completionsavec unresponse_formatJSON Schema (classeCategorie), validé par Pydantic. Les noms de modèles sont ceux enregistrés avec le run, lus dans la configuration au moment de l'expérience. - ⑨ Traces.
tracage.activer("exemplia"), appelé au démarrage de l'application, active l'autolog OpenAI : chaque appel au serveur de modèles part en trace dans l'expérienceexemplia. TF-IDF et CamemBERT n'en produisent aucune. - ⑩ Réponse. Le fragment
prediction.htmlaffiche la catégorie, le score pour CamemBERT, le nombre d'appels, la durée et les échanges avec le modèle.
Cycle d'expériences et fine-tuning
flowchart TD
  classDef externe fill:#fed7aa,stroke:#ea580c,color:#7c2d12
  classDef code fill:#ffffff,stroke:#6b7280,color:#1f2937
  classDef gpu fill:#fecaca,stroke:#dc2626,color:#7f1d1d
  classDef disque fill:#dcfce7,stroke:#16a34a,color:#14532d

  subgraph Py["Processus Python : make experiences"]
    Exp["experiences.py<br/>jeu_de_donnees, lancer_*,<br/>promouvoir_champion"]
    Gen["socle/entreprise.py<br/>generer : 300 tickets"]
    Mod["modeles.py<br/>pipeline_tfidf, ClassifieurEmbeddings,<br/>ClassifieurLLM"]
    FT["fine_tuning.py<br/>Trainer, pipeline"]
  end
  Hub["Hugging Face Hub<br/>almanach/camembert-base"]
  Gpu["GPU CUDA<br/>PyTorch"]
  Ollama["Ollama (hôte)<br/>qwen3.5:9b<br/>qwen3-embedding:0.6b"]
  MLflow[("MLflow<br/>conteneur Docker<br/>expérience tri-tickets")]

  Exp -- "① appel Python<br/>tickets en mémoire" --> Gen
  Exp -- "② appel Python<br/>fit, predict" --> Mod
  Mod -- "③ HTTP POST<br/>/v1/embeddings" --> Ollama
  Mod -- "⑤ HTTP POST<br/>/v1/chat/completions" --> Ollama
  Exp -- "④ ⑥ ⑦ ⑬ HTTP, API REST<br/>prompt, runs, modèles,<br/>alias champion" --> MLflow
  Hub -- "⑧ HTTPS GET, 1re fois<br/>poids, tokenizer" --> FT
  FT -- "⑨ ⑫ appel Python<br/>jeu_de_donnees, promotion" --> Exp
  FT -- "⑩ noyaux CUDA<br/>20 époques, test" --> Gpu
  FT -- "⑪ HTTP<br/>run camembert-fine-tuning" --> MLflow

  class Hub externe
  class Exp,Gen,Mod,FT code
  class Gpu,Ollama gpu
  class MLflow disque
make experiences lance uv run python -m exemplia.tri_tickets.experiences (approches tfidf,
embeddings, llm), puis uv run python -m exemplia.tri_tickets.fine_tuning --promouvoir, qui
demande le groupe de dépendances gpu. Les deux scripts écrivent dans l'expérience tri-tickets
du serveur MLflow ; aucun ne lit PostgreSQL.
- ① Jeu de données.
jeu_de_donneesgénère les 300 tickets en mémoire (entreprise.generer, graine fixe) et les sépare avecStratifiedGroupKFold: groupes par formulation d'origine, strates par catégorie, une part sur cinq en test. - ② Entraînement et évaluation. Chaque approche est un run MLflow. Le pipeline TF-IDF et les
régressions logistiques sont entraînés par scikit-learn ;
_evaluerprédit le jeu de test et mesure F1 macro, exactitude et latence par ticket. - ③ Embeddings.
ClassifieurEmbeddingsenvoie les tickets d'entraînement, puis ceux de test, à/v1/embeddings(IACU_MODELE_EMBEDDINGS,qwen3-embedding:0.6bpar défaut), en une requête par lot. - ④ Prompt. Avant le run
llm,mlflow.genai.register_promptenregistrePROMPT_ZERO_SHOTsous le nomtri-tickets-zero-shot; l'URI de la version est passée au classifieur. - ⑤ Classification par le LLM.
ClassifieurLLMcharge ce prompt depuis le Prompt Registry et appelle/v1/chat/completionsune fois par ticket de test, avec sortie structurée (IACU_MODELE_CHAT,qwen3.5:9bpar défaut). Aucun entraînement. - ⑥ Enregistrement des runs. Pour chaque run : paramètres, métriques, rapport de
classification, matrice de confusion et modèle (
mlflow.sklearn.log_modelpour TF-IDF,mlflow.pyfunc.log_modelpour les deux autres, sans le client réseau). - ⑦ Promotion.
promouvoir_championretient les runs à moins d'un point du meilleur F1 macro, prend le plus rapide, l'enregistre comme nouvelle version detri-ticketset lui donne l'aliaschampionet le tagapproche. Ici, seuls les runs qui viennent d'être lancés sont comparés. - ⑧ Modèle de base.
fine_tuning.pys'arrête si CUDA est absent, puis chargealmanach/camembert-base(tokenizer et modèle avec une tête de classification à cinq classes), téléchargé depuis le Hugging Face Hub au premier lancement. - ⑨ Même découpage. Le script reprend
jeu_de_donnees: le jeu de test est celui des autres approches. - ⑩ Fine-tuning sur le GPU. Le
Trainerde transformers entraîne 20 époques (taux 5e-5, lots de 16, bf16 si la carte le prend en charge) et évalue à chaque époque ; un pipelinetext-classificationsur le GPU prédit ensuite le jeu de test pour mesurer les mêmes métriques. - ⑪ Run CamemBERT. Le run
camembert-fine-tuningenregistre paramètres, métriques et le pipeline avecmlflow.transformers.log_model. - ⑫ Promotion sur tous les runs. Avec
--promouvoir,resultats_experiencerelit tous les runs de l'expérience qui ont des métriques, fine-tuning compris, et applique la même règle. - ⑬ Nouveau champion. La règle crée une nouvelle version de
tri-ticketset déplace l'aliaschampion; la page le charge à la prochaine prédiction sur cet alias, sans redéploiement.
Ce que fait le GPU. Ollama sert sur le GPU le modèle d'embeddings et le LLM (⑧ de la prédiction, ③ et
⑤ du cycle d'expériences) : des passes avant, sans entraînement. Le seul entraînement sur le GPU est le
fine-tuning de CamemBERT (⑩), par PyTorch dans le processus du script. TF-IDF, les régressions
logistiques et les métriques tournent sur le CPU. Dans l'application web, le pipeline CamemBERT
rechargé par MLflow est placé sur le GPU quand CUDA est disponible, sinon sur le CPU (variable
MLFLOW_DEFAULT_PREDICTION_DEVICE pour forcer un périphérique).