Berlue — vérificateur d'hallucinations LLM

01 Berlue en action

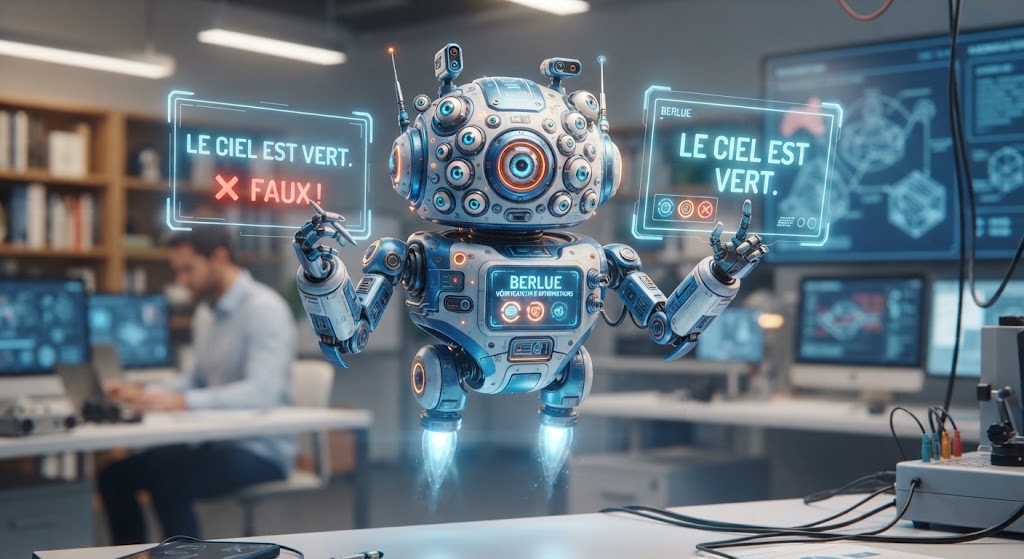
Le robot Berlue, en pleine démo, pointe vers deux panneaux holographiques affichant l'affirmation « Le ciel est vert » — l'un marqué d'une croix rouge « Faux ! », l'autre repris tel quel — pendant qu'un utilisateur travaille en arrière-plan sur des écrans de code.
Berlue vérifie en direct ce qu'affirme un LLM, et signale précisément ce qui est faux.

02 Le processus Berlue en 4 étapes

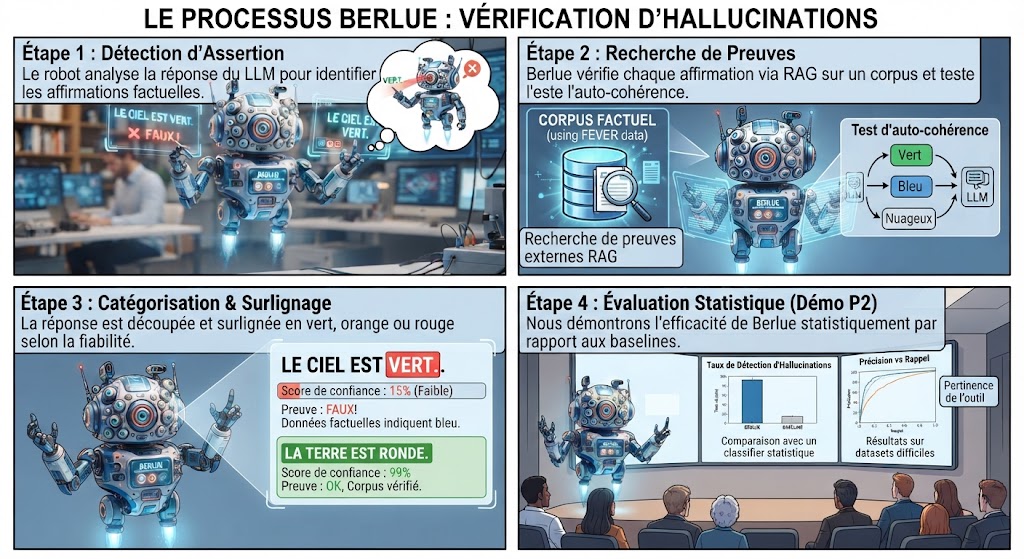
Étape 1 : détection d'assertion — le robot analyse la réponse du LLM pour identifier les affirmations factuelles. Étape 2 : recherche de preuves — Berlue vérifie chaque affirmation via RAG sur le corpus FEVER et teste l'auto-cohérence. Étape 3 : catégorisation et surlignage — la réponse est surlignée en vert, orange ou rouge selon la fiabilité, avec un score de confiance et la preuve citée. Étape 4 : évaluation statistique — démonstration de l'efficacité de Berlue face à une baseline, sur des jeux de données difficiles.

03 Le flux, pas à pas

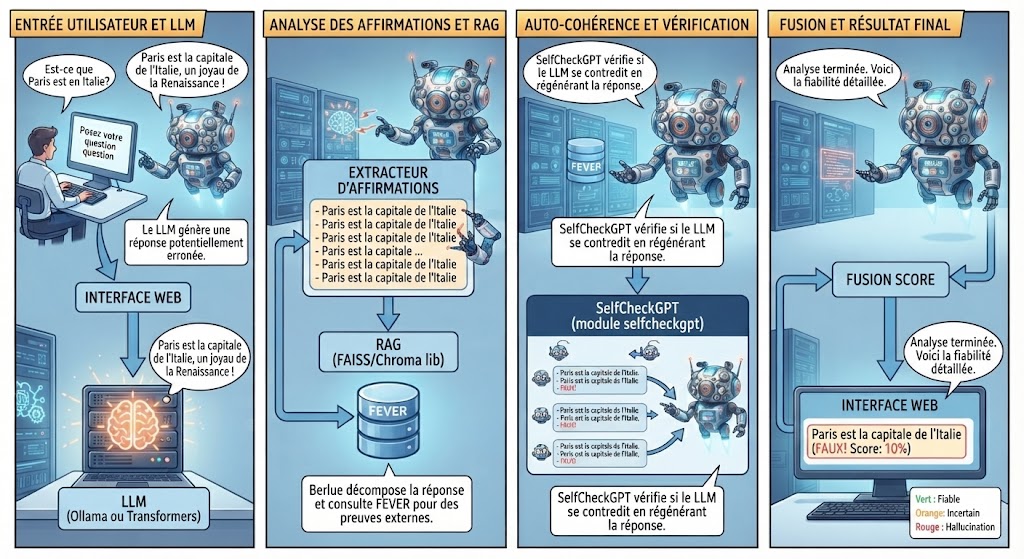
Entrée utilisateur et LLM : l'utilisateur pose une question via l'interface web, le LLM (Ollama ou Transformers) génère une réponse potentiellement erronée. Analyse des affirmations et RAG : l'extracteur d'affirmations découpe la réponse, le module RAG interroge l'index FAISS/Chroma construit sur FEVER. Auto-cohérence et vérification : SelfCheckGPT vérifie si le LLM se contredit en régénérant la réponse plusieurs fois. Fusion et résultat final : le score de fusion combine les deux verdicts et l'interface web affiche la réponse annotée, verte/orange/rouge, avec le score de confiance.

04 Encyclopédie des composants

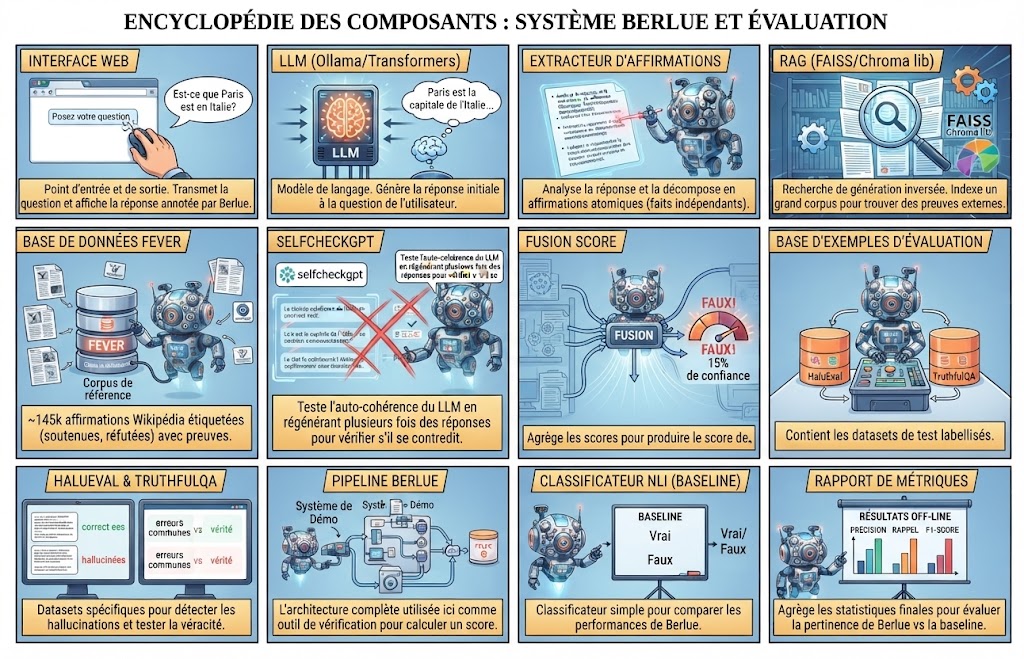
Vue d'ensemble illustrée des composants du système Berlue et de son évaluation : Interface Web, LLM (Ollama/Transformers), Extracteur d'affirmations, RAG (FAISS/Chroma), base FEVER, SelfCheckGPT, Fusion Score, base d'exemples d'évaluation, HaluEval et TruthfulQA, pipeline Berlue complet, classificateur NLI (baseline), et rapport de métriques off-line.
Récapitulatif de toutes les briques présentées en détail dans les diagrammes suivants.

05 Le concept

Le problème : un LLM répond toujours avec la même assurance, qu'il dise vrai ou qu'il invente.
L'utilisateur n'a aucun moyen simple de savoir quelle partie d'une réponse est fiable.

La démo partie 1 : une question piège (type idée reçue), la réponse du LLM affichée en direct, puis surlignée par Berlue — l'utilisateur voit l'endroit exact où le modèle « a la berlue ».

Ce que fait Berlue : Verifie que ce repond un llm n'est pas une hallucination.

La démo partie 2 : Est ce que Berlue est efficasse ? Nous presentons alors nos resultats statistiques

Comment verifier notre outils :

06 Scénario de démo — diagramme de séquence

Utilisateur Interface Berlue Ollama Module RAG SelfCheckGPT 1 · pose une question 2 · pose la question 3 · réponse + affirmations extraites pour chaque affirmation 4 · cherche une preuve 5 · verdict + citation 6 · repose la question K fois avec des températures élevées 7 · reponses à comparer 8 · score de divergence des reponses classifie grace au verdict RAG + score SelfCheckGPT → score de confiance 9 · réponse surlignée + score + citation
Temp: La température contrôle le degré d'aléatoire du mot suivant généré par le LLM.
  • Temp = 0, le modèle prend quasi toujours le mot le plus probable → réponse stable
  • Temp > 0, mots moins probables ont plus de chances d'être tirés → réponse différente à chaque tirage.

07 Composants de la démo — schéma d'architecture

Utilisateur Berlue Interface Web LLM ollama ou transformers Extracteur d'affirmations SelfCheckGPT module selfcheckgpt RAG Index vectoriel FAISS/Chroma lib FEVER Fusion Score
FEVER : ~145k affirmations Wikipédia étiquetées soutenue / réfutée / pas assez d'info, chacune avec sa preuve — le corpus qu'on indexe pour le RAG inversé.
SelfCheckGPT : implémentation de référence du module de détection d'hallucination sans boîte noire, utilisé en parallèle du RAG inversé.

08 Preuve de pertinence — séquence de l'évaluation offline

Script d'évaluation Jeux de données (HaluEval / TruthfulQA) Pipeline Berlue (Ollama + RAG + SelfCheck) Classifieur NLI (baseline légère) Rapport de métriques 1 · charge N exemples labellisés 2 · question + réponse + label vérité-terrain pour chaque question + réponses + label 3 · vérifie (pipeline complet) 4 · verdict + score de confiance 5 · même exemple (baseline) 6 · verdict basique 7 · compare Berlue vs baseline aux labels vérité-terrain, enregistre le résultat 8 · agrège précision / rappel / F1 par pipeline 9 · chiffres comparatifs (pour les slides de la présentation finale)

09 Composants de l'évaluation offline — schéma d'architecture

Script d'évaluation HaluEval TruthfulQA Pipeline Berlue détail en §07 Classifieur NLI TF-IDF + LogReg Rapport de métriques charge / exemples labellisés vérifie / verdict + score vérifie / verdict basique agrège précision / rappel / F1
  • HaluEval : ~35k réponses QA/dialogue/résumé, appariées correcte vs hallucinée.
  • TruthfulQA : 817 questions sur 38 catégories d'idées reçues, teste si le modèle répète l'erreur commune plutôt que la vérité.